Anleitung zum Einrichten des Dell Pro Max 16 Plus mit Qualcomm-Inferenzkarte unter Linux
Summary: Erfahren Sie, wie Sie den Dell Pro Max 16 Plus-MB16250 mit Qualcomm-Inferenzkarte unter Linux einrichten.
Instructions
Einrichten des Dell Pro Max 16 Plus mit Qualcomm-Inferenzkarte unter Linux
Willkommen bei Ihrem Dell Pro Max 16 Plus mit Qualcomm AI100-Inferenzkarte!
Befolgen Sie diese einmaligen Einrichtungsschritte unten, um die Karte für KI-Inferenz-Workloads mit Ubuntu 24.04 auf der Dell Pro Max 16 Plus-Workstation vorzubereiten. Dadurch wird sichergestellt, dass die Workstation und die Karte über die richtige Software- und Konfigurationsgrundlinien-Einrichtung verfügen, um direkt mit der Verwendung der Karte zu beginnen.
-
Überprüfen der Installation der AI100-Karte.
Verwenden Sie Folgendes:lspciBefehl zum Überprüfen, ob die Karte im Laptop installiert ist:lspci | grep Qualcomm
Mit diesem Befehl werden zwei (2) Qualcomm a100 PCIe-Geräteeinträge für die AI100-Karte angezeigt.dell@dell:~$ lspci | grep Qualcomm 04:00.0 Processing accelerators: Qualcomm Technologies, Inc Device a100 05:00.0 Processing accelerators: Qualcomm Technologies, Inc Device a100 dell@dell:~$ -
Aktualisieren des BIOS auf der Dell Pro Max 16 Plus-Workstation.
Aktualisieren Sie das Workstation-BIOS, um sicherzustellen, dass der Laptop über die neueste Unterstützung für die AI100-Inferenzkarte verfügt. Verwenden Sie die folgenden Befehle, um nach BIOS-Updates zu suchen und dann ein Upgrade durchzuführen, wenn ein Update verfügbar ist:
Befehle zum Suchen nach BIOS-Updates:sudo fwupdmgr refresh --force sudo fwupdmgr upgrade
Beispielausgabe zur Aktualisierung auf das neueste BIOS.dell@dell:~$ sudo fwupdmgr refresh --force Updating lvfs Downloading… [*************************************] Successfully downloaded new metadata: 7 local devices supported dell@dell:~$ sudo fwupdmgr upgrade Devices with no available firmware updates: • Integrated Webcam 8M • PC811 SED SK hynix 2048GB • TPM • UEFI Device Firmware • UEFI dbx • USB4 host controller Perform operation? [Y|n]: Y Waiting… [***************************************] Successfully installed firmware Do not turn off your computer or remove the AC adapter while the update is in progress. An update requires a reboot to complete. Restart now? [y|N]:
Überprüfen Sie, ob die BIOS-Version 2.22 oder höher installiert ist.dmidecode-Befehl überprüfen, ob sie ausgeführt werden: Die vorhandene BIOS-Firmwareversion wird überprüft.sudo dmidecode -t 0 -
Aktualisieren des Ubuntu-Betriebssystems (BS) auf Ihrer Dell Pro Max 16 Plus-Workstation
Beim nächsten Update des Ubuntu-Betriebssystems auf der Workstation wird die Unterstützung für die AI100-Inferenzkarte in Ubuntu 24.04 integriert. Durch das Update von Ubuntu wird sichergestellt, dass die neuesten Kernel-Module und AI100-Firmwareupdates für Ihre Karte verfügbar sind.
Um Ubuntu zu aktualisieren, verwenden Sie entweder den Ubuntu "Software Updater" im Desktop-Menü "Apps" oder verwenden Sie die folgenden Befehle in einem Terminal:
Befehle zum Aktualisieren der Ubuntu-Software im Terminal:sudo apt-get update sudo apt-get upgrade sudo rebootNachdem der Laptop Ubuntu heruntergeladen, installiert und aktualisiert hat, starten Sie die Workstation neu, um sicherzustellen, dass alle Startzeitänderungen für den Kernel durchgeführt werden.
Überprüfen Sie, ob Ihr aktualisierter Ubuntu-Kernel Version 6.14.0-1017-oem oder höher ist. Diese Version enthält die signierten Kernel-Module, die Ihren AI100 mit aktiviertem Secure Boot unterstützen. Verwenden Sie den folgenden Befehl, um Ihre Kernel-Version zu überprüfen.
Überprüfen, ob der Linux-Kernel Version 6.14.0-1017-oem oder höher ist.dell@dell:~$ uname -r 6.14.0-1017-oemdell@dell:~$ uname -r 6.14.0-1017-oem
Überprüfen Sie als Nächstes, ob das Linux-Firmwarepaket, das die AI100-Firmware enthält, Version 2.22 oder höher ist, indem Sie diesen Befehlszeilenbefehl verwenden:
Überprüfen Sie, ob die Linux-Firmware Version 2.22 oder höher ist.dell@dell:~$ dpkg-query --list linux-firmware Desired=Unknown/Install/Remove/Purge/Hold | Status=Not/Inst/Conf-files/Unpacked/halF-conf/Half-inst/trig-aWait/Trig-pend |/ Err?=(none)/Reinst-required (Status,Err: uppercase=bad) ||/ Name Version Architecture Description +++-==============-================================-============-================================= ii linux-firmware 20240318.git3b128b60-0ubuntu2.22 amd64 Firmware for Linux kernel drivers dell@dell:~$ -
GRUB-Kernel-Parameter werden aktualisiert.
Um die Qualcomm AI100-Inferenzkarte vollständig zu verwenden, deaktivieren Sie die Funktion PCIe Access Control System (ACS). Dies ist erforderlich, um Tensor-Slicing mit beiden AI100-Geräten auf der Qualcomm AI100-Karte vollständig zu unterstützen. Deaktivieren Sie ACS auf dem PCIe-Switch auf der AI100-Karte. Dies ermöglicht den vollständigen Datenzugriff zwischen den beiden AI100-Geräten und allen 64 GB des integrierten RAM, wenn die Inferenz auf beiden ausgeführt wird.Dazu wird ein Linux-Kernelparameter übergeben, der der GRUB-Konfiguration hinzugefügt wird, um die Qualcomm AI100-Inferenzkarte zu unterstützen. Kernel-Parameter sind Konfigurationen, die während des Startvorgangs an den Linux-Kernel übergeben werden und den Kernel anweisen, wie bestimmte Funktionen konfiguriert werden sollen. In diesem Fall wird ACS für die AI100-Karte deaktiviert. Dies geschieht durch Hinzufügen eines Kernelparameters zur GRUB-Konfigurationsdatei.
Öffnen Sie die GRUB-Konfigurationsdatei mit Root-Berechtigungen in einem Texteditor.
Bearbeiten der GRUB-Konfigurationsdatei/etc/default/grub.sudo nano /etc/default/grubsudo nano /etc/default/grub
Bearbeiten Sie dieGRUB_CMDLINE_LINUX_DEFAULTZeile, um diepci=disable_acs_redir(ACS auf dem PCIe-Switch der AI100-Karte deaktivieren). Stellen Sie sicher, dass Sie die genaue Syntax unten verwenden. Stellen Sie außerdem sicher, dass nur einGRUB_CMDLINE_LINUX_DEFAULTZeile in der/etc/default/grubDatei (Fügen Sie die Kernel-Optionen bei Bedarf in einer Zeile zusammen).
ÄnderungGRUB_CMDLINE_LINUX_DEFAULTLinie.GRUB_CMDLINE_LINUX_DEFAULT="quiet splash pci=disable_acs_redir=03:00.0\;03:01.0"Drücken Sie STRG+X, wählen Sie Y aus, und drücken Sie die EINGABETASTE, um die Konfigurationsänderungen zu speichern. Führen Sie nun die folgenden Schritte aus und starten Sie sie neu, damit die Änderungen wirksam werden.
Erzeugen Sie die GRUB-Konfiguration neu.sudo update-grub sudo rebootÜberprüfen Sie die Änderungen nach dem Neustart mit den folgenden Befehlen.
Überprüfen Sie die GRUB-Konfigurationsänderungen.dell@dell:~$ cat /proc/cmdline BOOT_IMAGE=/boot/vmlinuz-6.14.0-1016-oem root=UUID=cd20aec8-6b44-45f7-bca5-307240cec24b ro quiet splash pci=disable_acs_redir=03:00.0;03:01.0 vt.handoff=7dell@dell:~$ cat /proc/cmdline BOOT_IMAGE=/boot/vmlinuz-6.14.0-1016-oem root=UUID=cd20aec8-6b44-45f7-bca5-307240cec24b ro quiet splash pci=disable_acs_redir=03:00.0;03:01.0 vt.handoff=7
Überprüfen Sie, ob ACS mit dmesg deaktiviert ist. Meldungen für "Konfigurierter ACS" werden wie folgt angezeigt:dell@dell:~$ sudo dmesg | grep ACS [ 0.000000] Command line: BOOT_IMAGE=/boot/vmlinuz-6.14.0-1016-oem root=UUID=cd20aec8-6b44-45f7-bca5-307240cec24b ro quiet splash pcie_port_m=force pci=disable_acs_redir=03:00.0;03:01.0 vt.handoff=7 [ 0.141658] Kernel command line: BOOT_IMAGE=/boot/vmlinuz-6.14.0-1016-oem root=UUID=cd20aec8-6b44-45f7-bca5-307240cec24b ro quiet splash pcie_port_m=force pci=disable_acs_redir=03:00.0;03:01.0 vt.handoff=7 [ 0.741030] pci 0000:03:00.0: Configured ACS to 0x0000 [ 0.745422] pci 0000:03:01.0: Configured ACS to 0x0000 -
Installieren von Docker
Der schnellste Weg zum Ausführen der Inferenz auf der AI100-Karte ist die Verwendung vorgefertigter AI100-Docker-Container, die Unterstützung für die Qualcomm AI100-Inferenzkarte bieten. Der vorgefertigte Docker-Container bietet eine einsatzbereite Umgebung für die Ausführung der Inferenz-Workloads. Der Container umfasst die Qualcomm AI100 Platform and Apps SDKs und Toolchain, die Python-Umgebung, Qualcomm Efficient Transformers zum Kompilieren von KI-Modellen und Ausführen von Inferenzen sowie gebrauchsfertige vLLM- und Triton-Unterstützung für die AI100-Inferenzkarte.
Verwenden Sie den folgenden Befehl, um Docker in Ubuntu zu installieren:
sudo snap install docker
Um Docker als normaler Nutzer auszuführen, führen Sie die folgenden Befehle aus.
Befehle zum Ausführen von Docker als normaler Nutzer.# create and join the docker group sudo addgroup --system docker sudo adduser $USER docker newgrp docker # disable and re-enable the docker snap if you added the group while Docker Engine was running sudo snap disable docker sudo snap enable docker# create and join the docker group sudo addgroup --system docker sudo adduser $USER docker newgrp docker # disable and re-enable the docker snap if you added the group while Docker Engine was running sudo snap disable docker sudo snap enable docker
Das Präfix sudo für alle Docker-Befehle ist erforderlich, wenn der Nutzer nicht zur Docker-Gruppe hinzugefügt wird:sudo docker run ...Referenz: Docker-Snap
Alternativ kann Docker mit apt Debian Docker Docs
installiert werden
Sobald Docker installiert ist, testen Sie die Installation wie folgt:
Überprüfen Sie, ob Docker mit hello-world installiert wurde:dell@dell:~$ docker run hello-world Unable to find image 'hello-world:latest' locally latest: Pulling from library/hello-world 17eec7bbc9d7: Pull complete Digest: sha256:d4aaab6242e0cace87e2ec17a2ed3d779d18fbfd03042ea58f2995626396a274 Status: Downloaded newer image for hello-world:latest Hello from Docker! This message shows that your installation appears to be working correctly. ... -
Die Dell Pro Max 16 Plus-Workstation AI100-Inferenzkarte ist jetzt einsatzbereit!
Damit ist die einmalige Einrichtung abgeschlossen, die für die Verwendung der AI100-Inferenzkarte erforderlich ist. In den nächsten Abschnitten wird gezeigt, wie Sie AI100-Tools verwenden, um den Status der Karte anzuzeigen und erste einfache Inferenzen auszuführen, um zu überprüfen, ob die AI100-Karte betriebsbereit ist.
-
Überprüfen der AI100-Karte
Überprüfen Sie die AI100-Karte und führen Sie die anfängliche Inferenz aus, indem Sie einen vordefinierten AI100-Docker-Container verwenden, der alle AI100-Plattform- und -App-SDKs, die Toolchain sowie die für die Verwendung der Karte erforderlichen Inferenzierungstools vLLM und Triton enthält.
Wenn der AI100-Docker-Container zum ersten Mal ausgeführt wird, wird mit diesem Befehl auch der Container abgerufen. Das AI100-Docker-Container-Image umfasst ~14 GB Download. Um den AI100-Docker-Container zu starten, verwenden Sie den folgenden Befehl:
Starten Sie den AI100-Docker-Container.docker run --rm -it \ --privileged \ --device=/dev/accel/accel1 \ --device=/dev/accel/accel2 \ --network host \ --ulimit nofile=1048576 \ -e OMP_NUM_THREADS=8 \ ghcr.io/quic/cloud_ai_inference_ubuntu24:1.20.6.0 \ /bin/bash
Sobald der AI100-Docker-Container abgerufen und ausgeführt wurde, wird eine Ausgabe wie diese auf dem Bildschirm angezeigt:
Beispielausgabe nach dem Starten des AI100-Docker-Containers.dell@dell:~$ docker run --rm -it --device=/dev/accel/accel1 --device=/dev/accel/accel2 --network host --ulimit nofile=1048576 -e OMP_NUM_THREADS=8 -v ~/Downloads/qwen3_coder_qpc:/root/qpc/ ghcr.io/quic/cloud_ai_inference_ubuntu24:1.20.6.0 /bin/bash ================================== == Qualcomm Cloud AI Containers == ================================== Platform SDK version: 1.20.6.0 Apps SDK version: 1.20.6.0 This container image and its contents are governed by the terms of the license at /usr/share/doc/CONTAINER_LICENSE.txt. By pulling and using the container, you accept the terms and conditions of this license. root@dell:~#dell@dell:~$ docker run --rm -it --device=/dev/accel/accel1 --device=/dev/accel/accel2 --network host --ulimit nofile=1048576 -e OMP_NUM_THREADS=8 -v ~/Downloads/qwen3_coder_qpc:/root/qpc/ ghcr.io/quic/cloud_ai_inference_ubuntu24:1.20.6.0 /bin/bash ================================== == Qualcomm Cloud AI Containers == ================================== Platform SDK version: 1.20.6.0 Apps SDK version: 1.20.6.0 This container image and its contents are governed by the terms of the license at /usr/share/doc/CONTAINER_LICENSE.txt. By pulling and using the container, you accept the terms and conditions of this license. root@dell:~#
Verwenden des AI100qaic-util -q, um eine Textausgabe des Status der AI100-Karte bereitzustellen, wie in der folgenden Beispielausgabe.
Beispielausgabe fürqaic-util -qroot@dell:~# qaic-util -q LRT QC_IMAGE_VERSION: LRT.AIC.13.2.1.20.6.0 LRT IMAGE_VARIANT: LRT.AIC.REL Number of devices queried: 2 QID 0 Status:Ready ...Eine Grid-Statusansicht ist über die Schaltfläche
Beispiel-Leerlaufausgabe fürqaic-util -t1 Befehl, mit dem der Kartenstatus regelmäßig aktualisiert wird. Die folgende Beispielausgabe zeigt die AI100-Karte im Leerlauf. Die AI100-Karte umfasst zwei AI100-Geräte mit jeweils 16 NSP-Rechenkernen (Neural Signal Processor). Jedes Gerät weist 32 GB Arbeitsspeicher von insgesamt 64 GB auf der Karte auf:qaic-util -t 1.root@dell:~# qaic-util -t 1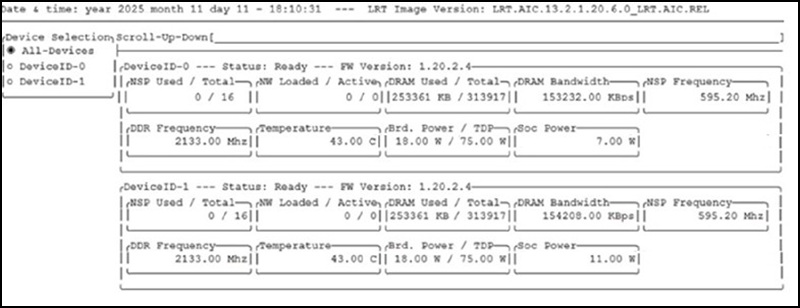
Hier ist ein weiteres Beispielqaic-utilwährend die AI100-Karte eine KI-Inferenz-Workload ausführt. In diesem Fall wird ein größeres Modell angezeigt - qwen3-coder:30b. Die Ausgabe zeigt, dass alle 16 NSPs auf jedem AI100-Gerät verwendet werden, die Kartentemperatur von niedrigeren Leerlauftemperaturen auf 47 °C gestiegen ist, dass jedes AI100-Teil jeweils ~13 GB verbraucht, insgesamt 26 GB für das Modell, die für die Platine verwendete Gesamtleistung beträgt 51 von maximal 75 W, Die NSP-Frequenz für den Workload wurde auf 1.100 MHz erhöht.
Beispielausgabe für AI100 ausgeführte Inferenz mitqaic-util -t 1.root@dell:~# qaic-util -t 1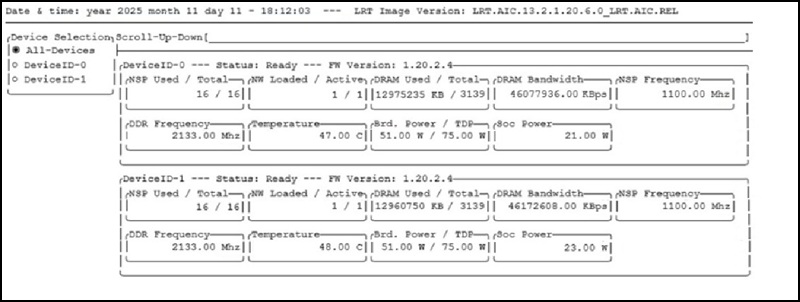
Um die AI100-Karte zurückzusetzen, verwenden Sie denqaic-util -s. Für diesen Befehl ist eine Hardwareberechtigung innerhalb des Containers erforderlich, die beim Ausführen des Containers den Befehlszeilenparameter "-privileged" erfordert. Die folgende Beispielausgabe zeigt die Verwendung vonqaic util -sgefolgt vonqaic-util -t1, um den Kartenstatus zu überwachen. Ungültige Feldwerte wie in der Beispielausgabe unten werden angezeigt, bis die Karte den Reset abgeschlossen hat:
Beispielausgabe des Zurücksetzens der AI100-Karte mitqaic-util -sundqaic-util -t 1.root@dell:~# qaic-util -s Resetting all devices… 0000:04:00.0: 0000:04:00.0 success 0000:05:00.0: 0000:05:00.0 success root@dell:~# qaic-util -t 1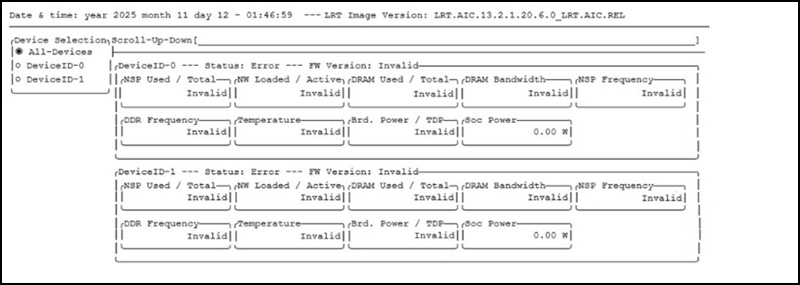
Verwenden Sie eine einzelne Systemeingabeaufforderung, um den AI100-Kartenstatus mithilfe des AI100-Docker-Containers wie folgt aufzurufen.
Starten Sie den AI100-Docker-Container.docker run --rm -it \ --privileged \ --device=/dev/accel/accel1 \ --device=/dev/accel/accel2 \ --network host \ --ulimit nofile=1048576 \ -e OMP_NUM_THREADS=8 \ ghcr.io/quic/cloud_ai_inference_ubuntu24:1.20.6.0 \ qaic-util -t 1docker run --rm -it \ --privileged \ --device=/dev/accel/accel1 \ --device=/dev/accel/accel2 \ --network host \ --ulimit nofile=1048576 \ -e OMP_NUM_THREADS=8 \ ghcr.io/quic/cloud_ai_inference_ubuntu24:1.20.6.0 \ qaic-util -t 1Hinweis: Fehlerausgabezeilen werden angezeigt, wenn der Befehlqaic-util -sundqaic-util -t 1Befehle und in der Rasterausgabe wird "Invalid" für Temperatur und Platinenleistung/TDP und "0,00 W" für SoC-Leistung angezeigt. Es gibt Änderungen am Upstream-Flug, um dieses Problem in den kommenden Updates für das Ubuntu-Betriebssystem und AI100-Docker-Container zu beheben. -
Ausführen der Testableitung
In diesem Abschnitt wird gezeigt, wie Sie einen schnellen Inferenztest auf der AI100-Karte durchführen. Verwenden Sie diesen Inferenztest, um die Funktionalität der AI100-Karte zu überprüfen.
Verwenden Sie den Befehlszeilenbefehl
qaic-runnerSo führen Sie die erste Testinferenz-Workload aus. Verwenden Sie-d, um das AI100-Zielgerät anzugeben,-aum die Anzahl der zu verwendenden NSPs anzugeben und-nFür die Anzahl der Iterationen:
Beispieltestinferenz mitqaic-runner.docker run --rm -it \ --device=/dev/accel/accel1 \ --device=/dev/accel/accel2 \ --network host \ --ulimit nofile=1048576 \ -e OMP_NUM_THREADS=8 \ ghcr.io/quic/cloud_ai_inference_ubuntu24:1.20.6.0 \ qaic-runner -t /opt/qti-aic/test-data/aic100/v2/1nsp/1nsp-conv-hmx/ -a 16 -n 5000 -d 0docker run --rm -it \ --device=/dev/accel/accel1 \ --device=/dev/accel/accel2 \ --network host \ --ulimit nofile=1048576 \ -e OMP_NUM_THREADS=8 \ ghcr.io/quic/cloud_ai_inference_ubuntu24:1.20.6.0 \ qaic-runner -t /opt/qti-aic/test-data/aic100/v2/1nsp/1nsp-conv-hmx/ -a 16 -n 5000 -d 0
Auf dem Bildschirm wird eine Beispielausgabe wie die folgende angezeigt:
Beispielausgabe für die Ausführung der Testinferenz.dell@dell:~$ docker run --rm -it \ --device=/dev/accel/accel1 \ --device=/dev/accel/accel2 \ --network host \ --ulimit nofile=1048576 \ -e OMP_NUM_THREADS=8 \ ghcr.io/quic/cloud_ai_inference_ubuntu24:1.20.6.0 \ qaic-runner -t /opt/qti-aic/test-data/aic100/v2/1nsp/1nsp-conv-hmx/ -a 16 -n 5000 -d 0 loading /opt/qti-aic/dev/lib/x86_64/libQAic.so ---- Stats ---- InferenceCnt 5000 TotalDuration 22544us BatchSize 1 Inf/Sec 221788.502 -
Nützliche Links
Die folgende Tabelle enthält eine Liste wichtiger und nützlicher AI100-Ressourcen und Links, mit denen Sie die AI100-Inferenzkarte optimal nutzen können.
- Qualcomm AI100 Benutzerhandbuch
- Qualcomm Efficient Transformers Library
- QAIC-Container:
- QAIC Containers – zuletzt 24.04
- Entwickler-Blog
- http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/ Hinweis: Diese URL ist kein HTTPS-Link. Benutzung erfolgt auf eigene Gefahr.
Hinweis: Rufen Sie die Support-Website auf und verwenden Sie das Filterstichwort Linux , um weitere Dell Artikel im Zusammenhang mit dem Dell Pro Max 16 Plus-MB16250 mit Al100-Laptop anzuzeigen: - Qualcomm AI100 Benutzerhandbuch
-
AI100 – Vorgefertigte Modelle
Die folgende Tabelle enthält einen Snapshot der KI-Modelle, die für die Ausführung im AI100-Docker-Container (z. B. mit vLLM) vorkonfiguriert sind.
Die AI100-Inferenzkarte führt Modelle im Qualcomm Program Container-Format (QPC) aus. QPCs können aus Huggingface-Modellen mit den AI100 Platform and Apps SDKs erstellt werden oder vorgefertigte KI-Modell-QPCs aus dem Zentree-Onlinekatalog unter folgendem Link verwenden. QPCs sind auf die Anzahl der AI100-Geräte auf der Karte ausgelegt. Das Dell Pro Max 16 Plus mit Qualcomm Inference Card unterstützt QPCs, die auf einem oder zwei SoCs (AI100 System on a Chip) ausgeführt werden können. Ein QPC, der für zwei AI100-Geräte entwickelt wurde, verwendet Tensor-Slicing, um große Modelle mit der Rechenleistung von zwei AI100-Geräten über die vollen 64 GB Speicher auf der Karte ausführen zu können.
Weitere Informationen finden Sie auf der Registerkarte "Catalog" unter dem folgenden Link für http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/
Hinweis: Diese URLs sind keine HTTPS-Links. Benutzung erfolgt auf eigene Gefahr.Modellfamilie Modellarchitektur Repräsentatives Modell Modelltyp QAIC SDK-Version Automatische QEff-Klasse Aufgabe QPC-Link BERT BERTModel BAAI/bge-large-de-v1.5 Einbetten des Modells 1.19.6 QEFFAutoModel Texteinbettung http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.19.6/bge-large-en-v1.5/ BERT BERTModel BAAI/bge-m3 Einbetten des Modells 1.19.6 QEFFAutoModel Texteinbettung http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.19.6/bge-m3/ BERT BERTModel BAAI/bge-base-de-v1.5 Einbetten des Modells 1.19.6 QEFFAutoModel Texteinbettung http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.19.6/bge-base-en-v1.5/ DeepSeek-R1-Destille-Lama LlamaForCausalLM Valdemardi/DeepSeek-R1-Distill-Llama-70B-AWQ Reines Text-Sprachmodell 1.20.4 QEFFAutoModelForCausalLM Textgenerierung http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/DeepSeek-R1-Distill-Llama-70B-AWQ/ DeepSeek-R1-Destille-Lama LlamaForCausalLM Casperhansen/Deepseek-R1-Distill-Lama-8B-AWQ Reines Text-Sprachmodell 1.20.4 QEFFAutoModelForCausalLM Textgenerierung http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/deepseek-r1-distill-llama-8b-awq/ DeepSeek-R1-Destillieren-Qwen Qwen2ForCausalLM Valdemardi/DeepSeek-R1-Distill-Llama-32B-AWQ Reines Text-Sprachmodell 1.20.4 QEFFAutoModelForCausalLM Textgenerierung http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/DeepSeek-R1-Distill-Qwen-32B-AWQ/ DeepSeek-R1-Destillieren-Qwen Qwen2ForCausalLM Casperhansen/Deepseek-R1-DISTILL-QWEN-7B-AWQ Reines Text-Sprachmodell 1.20.4 QEFFAutoModelForCausalLM Textgenerierung http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/deepseek-r1-distill-qwen-7b-awq/ Gemma3 Gemma3ForConditionalGeneration google/gemma-3-4b-it Multimodales Sprachmodell 1.20.4 QEFFAutoModelForImageTextToText Vision-Sprachmodelle (Text + Bildgenerierung) http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/gemma-3-4b-it/ GPT-OSS GptOssForCausalLM OpenAI/GPT-OSS-20B Reines Text-Sprachmodell 1.20.4 QEFFAutoModeForCausalLM Textgenerierung http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/gpt-oss-20b/ Granit-3.2 GraniteForCausalLM ibm-granite/granite-3.2-8b-instruct Reines Text-Sprachmodell 1.20.4 QEFFAutoModelForCausalLM Textgenerierung http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/granite-3.2-8b-instruct/ Granit-3.3 GraniteForCausalLM ibm-granite/granite-3.3-8b-instruct Reines Text-Sprachmodell 1.20.4 QEFFAutoModelForCausalLM Textgenerierung http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/granite-3.3-8b-instruct/ Lama 3.1 LlamaForCausalLM meta-llama/llama-3.1-8B-Instruct Reines Text-Sprachmodell 1.20.4 QEFFAutoModelForCausalLM Textgenerierung http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/Llama-3.1-8B/ Lama 3.1 Nemotron LlamaForCausalLM ibnzterrell/nvidia-llama-3.1-nemotron-70B-Instruct-HF-AWQ-INT4 Reines Text-Sprachmodell 1.20.4 QEFFAutoModelForCausalLM Textgenerierung http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/Nvidia-Llama-3.1-Nemotron-70B-Instruct-HF-AWQ-INT4/ Lama 3.1 Nemotron LlamaForCausalLM nvidia/Llama-3.1-Nemotron-Nano-8B-v1 Reines Text-Sprachmodell 1.20.4 QEFFAutoModelForCausalLM Textgenerierung http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/Llama-3.1-Nemotron-Nano-8B-v1/ Lama 3.2 LlamaForCausalLM meta-lama/llama-3.2-1B Reines Text-Sprachmodell 1.20.4 QEFFAutoModelForCausalLM Textgenerierung http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/Llama-3.2-1B/ Lama 3.2 LlamaForCausalLM meta-lla/llama-3.2-3B Reines Text-Sprachmodell 1.20.4 QEFFAutoModelForCausalLM Textgenerierung http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/Llama-3.2-3B/ Lama 3.2 LlamaForCausalLM meta-llama/llama-3.2-3B-Instruct Reines Text-Sprachmodell 1.20.4 QEFFAutoModelForCausalLM Textgenerierung http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/Llama-3.2-3B-Instruct/ Lama 3.2 MllamaForConditionalGeneration meta-lla/lla-3.2-11B-vision-instruct Multimodales Sprachmodell 1.20.4 QEFFAutoModelForImageTextToText Vision-Sprachmodelle (Text + Bildgenerierung) http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/Llama-3.2-11B-Vision-Instruct/ Lama 3.2 instruieren LlamaForCausalLM meta-llama/llama-3.2-1B-Instruct Reines Text-Sprachmodell 1.20.4 QEFFAutoModelForCausalLM Textgenerierung http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/Llama-3.2-1B-Instruct/ Lama 3.x LlamaForCausalLM Ziel: Meta-Llama-3.1-70B-Instruct-AWQ-INT4
Entwurf: Lama-3.2-1B-InstructSpekulative Dekodierung (SpD) 1.20.4 QEFFAutoModelForCausalLM Textgenerierung http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/spd/meta-llama/ Lama 3.x LlamaForCausalLM Ziel: casperhansen/llama-3.3-70b-instruct-awq
Entwurf: meta-llama/llama-3.2-1B-InstructSpekulative Dekodierung (SpD) 1.20.4 QEFFAutoModelForCausalLM Textgenerierung http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/spd/llama33-70b-awq__draft-llama32-1b/ Mistral MistralForCausalLM mistralai/mistral-7B-Instruct-v0.1 Reines Text-Sprachmodell 1.20.4 QEFFAutoModelForCausalLM Textgenerierung http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/Mistral-7B-Instruct-v0.1/ Phi-4 Phi3ForCausalLM Microsoft/PHI-4 Reines Text-Sprachmodell 1.20.4 QEFFAutoModelForCausalLM Textgenerierung http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/phi-4/ Qwen3 Qwen3Moe Qwen/Qwen3-30B-A3B-Instruct-2507 Reines Text-Sprachmodell 1.20.4 QEFFAutoModelForCausalLM Textgenerierung http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/Qwen3-30B-A3B-Instruct-2507/ Qwen3-Programmierer Qwen3Moe Qwen/Qwen3-Coder-30B-A3B-Instruct Reines Text-Sprachmodell 1.20.4 QEFFAutoModelForCausalLM Codegenerierung http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/Qwen3-Coder-30B-A3B-Instruct/ Sarvamai Sarvamai Sarvamai/Sarvam-1 Reines Text-Sprachmodell 1.20.4 QEFFAutoModelForCausalLM Textgenerierung Schwerpunkt Indische Sprache http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/sarvam-1/ SDXL StableDiffusionForTextToImage Stabilitätai/Stable-Diffusion-XL-Base-1.0 Multimodales Sprachmodell 1.20.4 AutoPipelineForText2Image Vision-Sprachmodelle (Text + Bildgenerierung) http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/stable-diffusion-xl-base-1.0/ SDXL Turbo StableDiffusionForTextToImage StabilitätAI/SDXL-Turbo Multimodales Sprachmodell 1.20.4 AutoPipelineForText2Image Vision-Sprachmodelle (Text + Bildgenerierung) http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/sdxl_turbo/ Flüstern Flüstern OpenAI/Whisper-Base Audiomodell 1.20.4 QEFFAutoModelForSpeechSeq2Seq Automatische Spracherkennung (Transkription) http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/whisper-base/ Flüstern Flüstern OpenAI/Whisper-Large-V3-Turbo Audiomodell 1.20.4 QEFFAutoModelForSpeechSeq2Seq Automatische Spracherkennung (Transkription) http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/whisper-large-v3-turbo/ Flüstern Flüstern OpenAI/Whisper-Large Audiomodell 1.20.4 QEFFAutoModelForSpeechSeq2Seq Automatische Spracherkennung (Transkription) http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/whisper-large/ Flüstern Flüstern OpenAI/Whisper-Medium Audiomodell 1.20.4 QEFFAutoModelForSpeechSeq2Seq Automatische Spracherkennung (Transkription) http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/whisper-medium/ Flüstern Flüstern OpenAI/Whisper-Small Audiomodell 1.20.4 QEFFAutoModelForSpeechSeq2Seq Automatische Spracherkennung (Transkription) http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/whisper-small/ Flüstern Flüstern openai-whisper-tiny Audiomodell 1.20.4 QEFFAutoModelForSpeechSeq2Seq Automatische Spracherkennung (Transkription) http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/whisper-tiny/ XLM-RoBERTa XLMRobertaModel intfloat/mehrsprachig-e5-groß Einbetten des Modells 1.20.4 QEFFAutoModel Texteinbettung http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/multilingual-e5-large/ XLM-RoBERTa XLMRobertaModel intfloat/mehrsprachig-e5-klein Einbetten des Modells 1.19.6 QEFFAutoModel Texteinbettung http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.19.6/multilingual-e5-small/