Come configurare Dell Pro Max 16 Plus con scheda di inferenza Qualcomm in Linux
Summary: Informazioni su come configurare Dell Pro Max 16 Plus MB16250 con Qualcomm Inference Card in Linux.
Instructions
Configurazione di Dell Pro Max 16 Plus con scheda di inferenza Qualcomm in Linux
Benvenuto nel tuo Dell Pro Max 16 Plus con scheda di inferenza Qualcomm AI100!
Segui questi passaggi di configurazione una tantum riportati di seguito per preparare la scheda per i carichi di lavoro di inferenza AI utilizzando Ubuntu 24.04 sulla workstation Dell Pro Max 16 Plus. In questo modo si garantisce che la workstation e la scheda dispongano del software e delle linee di base di configurazione appropriati per iniziare subito a utilizzare la scheda.
-
Verifica dell'installazione della scheda AI100.
Utilizzare quanto segue:lspciComando per verificare che la scheda sia installata sul notebook:lspci | grep Qualcomm
Questo comando visualizza due (2) voci del dispositivo Qualcomm a100 PCIe per la scheda AI100.dell@dell:~$ lspci | grep Qualcomm 04:00.0 Processing accelerators: Qualcomm Technologies, Inc Device a100 05:00.0 Processing accelerators: Qualcomm Technologies, Inc Device a100 dell@dell:~$ -
Aggiornamento del BIOS sulla workstation Dell Pro Max 16 Plus.
Aggiornare il BIOS della workstation per assicurarsi che il notebook disponga del supporto più recente per la scheda di inferenza AI100. Utilizzare i seguenti comandi per verificare la disponibilità di aggiornamenti del BIOS e quindi aggiornarli se disponibili:
Comandi per verificare la disponibilità di aggiornamenti del BIOS:sudo fwupdmgr refresh --force sudo fwupdmgr upgrade
Esempio di output: aggiornamento del BIOS alla versione più recente.dell@dell:~$ sudo fwupdmgr refresh --force Updating lvfs Downloading… [*************************************] Successfully downloaded new metadata: 7 local devices supported dell@dell:~$ sudo fwupdmgr upgrade Devices with no available firmware updates: • Integrated Webcam 8M • PC811 SED SK hynix 2048GB • TPM • UEFI Device Firmware • UEFI dbx • USB4 host controller Perform operation? [Y|n]: Y Waiting… [***************************************] Successfully installed firmware Do not turn off your computer or remove the AC adapter while the update is in progress. An update requires a reboot to complete. Restart now? [y|N]:
Verificare che la versione del BIOS 2.22 o successiva sia installata utilizzandodmidecode: Controllo della versione del firmware del BIOS esistente.sudo dmidecode -t 0 -
Aggiornamento del sistema operativo (OS) Ubuntu sulla workstation Dell Pro Max 16 Plus
Nel prossimo aggiornamento del sistema operativo Ubuntu sulla workstation, il supporto per la scheda di inferenza AI100 è integrato in Ubuntu 24.04. L'aggiornamento di Ubuntu garantisce la disponibilità dei moduli kernel più recenti e degli aggiornamenti del firmware AI100 per la scheda.
Per aggiornare Ubuntu, utilizzare "Software Updater" di Ubuntu nel menu App del desktop oppure utilizzare i seguenti comandi in un terminale:
Comandi per aggiornare il software Ubuntu nel terminale:sudo apt-get update sudo apt-get upgrade sudo rebootUna volta che il notebook ha scaricato, installato e aggiornato Ubuntu, riavviare la workstation per assicurarsi che vengano apportate modifiche all'avvio del kernel.
Verificare che la versione del kernel Ubuntu aggiornato sia 6.14.0-1017-oem o successiva. Questa versione include i moduli kernel firmati che supportano AI100 con Secure Boot abilitato. Utilizzare il seguente comando per controllare la versione del kernel.
Verificare che la versione del kernel Linux sia 6.14.0-1017-oem o successiva.dell@dell:~$ uname -r 6.14.0-1017-oemdell@dell:~$ uname -r 6.14.0-1017-oem
Successivamente, verificare che il pacchetto del firmware Linux che include il firmware AI100 sia versione 2.22 o successiva utilizzando questo comando della riga di comando:
Verificare che la versione del firmware Linux sia 2.22 o successiva.dell@dell:~$ dpkg-query --list linux-firmware Desired=Unknown/Install/Remove/Purge/Hold | Status=Not/Inst/Conf-files/Unpacked/halF-conf/Half-inst/trig-aWait/Trig-pend |/ Err?=(none)/Reinst-required (Status,Err: uppercase=bad) ||/ Name Version Architecture Description +++-==============-================================-============-================================= ii linux-firmware 20240318.git3b128b60-0ubuntu2.22 amd64 Firmware for Linux kernel drivers dell@dell:~$ -
Aggiornamento dei parametri del kernel GRUB.
Per utilizzare completamente la scheda di inferenza Qualcomm AI100, disabilitare la funzione chiamata PCIe Access Control System (ACS). Questa operazione è necessaria per supportare completamente il tensor slicing utilizzando entrambi i dispositivi AI100 sulla scheda Qualcomm AI100. Disabilitare ACS sullo switch PCIe sulla scheda AI100. Ciò consente l'accesso completo ai dati tra i due dispositivi AI100 e tutti i 64 GB di RAM integrata durante l'esecuzione dell'inferenza su entrambi.Questa operazione viene eseguita passando un parametro del kernel Linux che viene aggiunto alla configurazione GRUB per supportare la scheda di inferenza Qualcomm AI100. I parametri del kernel sono configurazioni passate al kernel Linux durante l'avvio che indicano al kernel come configurare determinate funzioni. In questo caso, ACS viene disabilitato per la scheda AI100. A tale scopo, si aggiunge un parametro del kernel al file di configurazione di GRUB.
Aprire il file di configurazione di GRUB con privilegi root utilizzando un editor di testo.
Modificare il file di configurazione di GRUB/etc/default/grub.sudo nano /etc/default/grubsudo nano /etc/default/grub
Modificare la proprietàGRUB_CMDLINE_LINUX_DEFAULTriga per aggiungere ilpci=disable_acs_redir(disabilitare ACS sullo switch PCIe della scheda AI100). Assicurarsi di avere la sintassi esatta riportata di seguito. Assicurarsi inoltre che sia presente un soloGRUB_CMDLINE_LINUX_DEFAULTnella riga/etc/default/grubfile (unisci le opzioni del kernel, se necessario, su un'unica riga).
CambiareGRUB_CMDLINE_LINUX_DEFAULTLinea.GRUB_CMDLINE_LINUX_DEFAULT="quiet splash pci=disable_acs_redir=03:00.0\;03:01.0"Premere CTRL+X, selezionare Y e premere Invio per salvare le modifiche alla configurazione. A questo punto, eseguire il comando seguente e riavviare per applicare le modifiche.
Rigenerare la configurazione GRUB.sudo update-grub sudo rebootVerificare le modifiche utilizzando i seguenti comandi dopo il riavvio.
Verificare le modifiche alla configurazione di GRUB.dell@dell:~$ cat /proc/cmdline BOOT_IMAGE=/boot/vmlinuz-6.14.0-1016-oem root=UUID=cd20aec8-6b44-45f7-bca5-307240cec24b ro quiet splash pci=disable_acs_redir=03:00.0;03:01.0 vt.handoff=7dell@dell:~$ cat /proc/cmdline BOOT_IMAGE=/boot/vmlinuz-6.14.0-1016-oem root=UUID=cd20aec8-6b44-45f7-bca5-307240cec24b ro quiet splash pci=disable_acs_redir=03:00.0;03:01.0 vt.handoff=7
Verificare che ACS sia disabilitato utilizzando dmesg. I messaggi per "ACS configurato" vengono visualizzati come di seguito:dell@dell:~$ sudo dmesg | grep ACS [ 0.000000] Command line: BOOT_IMAGE=/boot/vmlinuz-6.14.0-1016-oem root=UUID=cd20aec8-6b44-45f7-bca5-307240cec24b ro quiet splash pcie_port_m=force pci=disable_acs_redir=03:00.0;03:01.0 vt.handoff=7 [ 0.141658] Kernel command line: BOOT_IMAGE=/boot/vmlinuz-6.14.0-1016-oem root=UUID=cd20aec8-6b44-45f7-bca5-307240cec24b ro quiet splash pcie_port_m=force pci=disable_acs_redir=03:00.0;03:01.0 vt.handoff=7 [ 0.741030] pci 0000:03:00.0: Configured ACS to 0x0000 [ 0.745422] pci 0000:03:01.0: Configured ACS to 0x0000 -
Installare Docker
Il percorso più rapido per eseguire l'inferenza sulla scheda AI100 consiste nell'utilizzare container Docker AI100 predefiniti che includono il supporto per la scheda di inferenza Qualcomm AI100. Il container Docker predefinito fornisce un ambiente pronto all'uso per l'esecuzione dei carichi di lavoro di inferenza. Il contenitore include la piattaforma Qualcomm AI100 e gli SDK e la toolchain per le app, l'ambiente Python, i trasformatori efficienti Qualcomm per la compilazione di modelli AI e l'esecuzione di inferenze, oltre a includere il supporto vLLM e Triton pronto all'uso per la scheda di inferenza AI100.
Per installare Docker in Ubuntu, utilizzare il seguente comando:
sudo snap install docker
Per eseguire docker come utente normale, eseguire i seguenti comandi.
Comandi per eseguire docker come un utente normale.# create and join the docker group sudo addgroup --system docker sudo adduser $USER docker newgrp docker # disable and re-enable the docker snap if you added the group while Docker Engine was running sudo snap disable docker sudo snap enable docker# create and join the docker group sudo addgroup --system docker sudo adduser $USER docker newgrp docker # disable and re-enable the docker snap if you added the group while Docker Engine was running sudo snap disable docker sudo snap enable docker
Se l'utente non viene aggiunto al gruppo Docker, è necessario aggiungere sudo a tutti i comandi Docker:sudo docker run ...Riferimento: Docker Snap
In alternativa, Docker può essere installato usando apt Debian Docker Docs
Una volta installato Docker, testare l'installazione come segue:
Verificare che Docker venga installato con hello-world:dell@dell:~$ docker run hello-world Unable to find image 'hello-world:latest' locally latest: Pulling from library/hello-world 17eec7bbc9d7: Pull complete Digest: sha256:d4aaab6242e0cace87e2ec17a2ed3d779d18fbfd03042ea58f2995626396a274 Status: Downloaded newer image for hello-world:latest Hello from Docker! This message shows that your installation appears to be working correctly. ... -
La scheda di inferenza AI100 della workstation Dell Pro Max 16 Plus è ora pronta per l'uso!
In questo modo si completa la configurazione una tantum richiesta per utilizzare la scheda di inferenza AI100. Le sezioni successive mostrano come utilizzare gli strumenti AI100 per visualizzare lo stato della scheda ed eseguire una semplice inferenza iniziale per verificare che la scheda AI100 sia operativa.
-
Controllo della scheda AI100
Controllare la scheda AI100 ed eseguire l'inferenza iniziale utilizzando un contenitore Docker AI100 predefinito contenente tutti gli SDK della piattaforma e delle app AI100, la toolchain e gli strumenti di inferenza vLLM e Triton necessari per utilizzare la scheda.
Se è la prima volta che si esegue il contenitore Docker AI100, anche questo comando recupera il contenitore. L'immagine del contenitore Docker AI100 è un download di ~14 GB. Per avviare il contenitore Docker AI100, utilizzare il seguente comando:
Avviare il contenitore Docker AI100.docker run --rm -it \ --privileged \ --device=/dev/accel/accel1 \ --device=/dev/accel/accel2 \ --network host \ --ulimit nofile=1048576 \ -e OMP_NUM_THREADS=8 \ ghcr.io/quic/cloud_ai_inference_ubuntu24:1.20.6.0 \ /bin/bash
Una volta recuperato ed eseguito il container Docker AI100, sullo schermo viene visualizzato un output come questo:
Esempio di output dopo l'avvio del contenitore Docker AI100.dell@dell:~$ docker run --rm -it --device=/dev/accel/accel1 --device=/dev/accel/accel2 --network host --ulimit nofile=1048576 -e OMP_NUM_THREADS=8 -v ~/Downloads/qwen3_coder_qpc:/root/qpc/ ghcr.io/quic/cloud_ai_inference_ubuntu24:1.20.6.0 /bin/bash ================================== == Qualcomm Cloud AI Containers == ================================== Platform SDK version: 1.20.6.0 Apps SDK version: 1.20.6.0 This container image and its contents are governed by the terms of the license at /usr/share/doc/CONTAINER_LICENSE.txt. By pulling and using the container, you accept the terms and conditions of this license. root@dell:~#dell@dell:~$ docker run --rm -it --device=/dev/accel/accel1 --device=/dev/accel/accel2 --network host --ulimit nofile=1048576 -e OMP_NUM_THREADS=8 -v ~/Downloads/qwen3_coder_qpc:/root/qpc/ ghcr.io/quic/cloud_ai_inference_ubuntu24:1.20.6.0 /bin/bash ================================== == Qualcomm Cloud AI Containers == ================================== Platform SDK version: 1.20.6.0 Apps SDK version: 1.20.6.0 This container image and its contents are governed by the terms of the license at /usr/share/doc/CONTAINER_LICENSE.txt. By pulling and using the container, you accept the terms and conditions of this license. root@dell:~#
Usa l'AI100qaic-util -qper fornire un output testuale dello stato della scheda AI100, come nell'output di esempio seguente.
Esempio di output perqaic-util -qroot@dell:~# qaic-util -q LRT QC_IMAGE_VERSION: LRT.AIC.13.2.1.20.6.0 LRT IMAGE_VARIANT: LRT.AIC.REL Number of devices queried: 2 QID 0 Status:Ready ...È possibile visualizzare lo stato della griglia utilizzando il comando
Esempio di output inattivo perqaic-util -t1 comando che aggiorna periodicamente lo stato della scheda. L'output di esempio seguente mostra la scheda AI100 inattiva. La scheda AI100 include due dispositivi AI100, ciascuno con 16 core di elaborazione NSP (Neural Signal Processor). Ogni dispositivo mostra 32 GB di memoria, per un totale di 64 GB sulla scheda:qaic-util -t 1.root@dell:~# qaic-util -t 1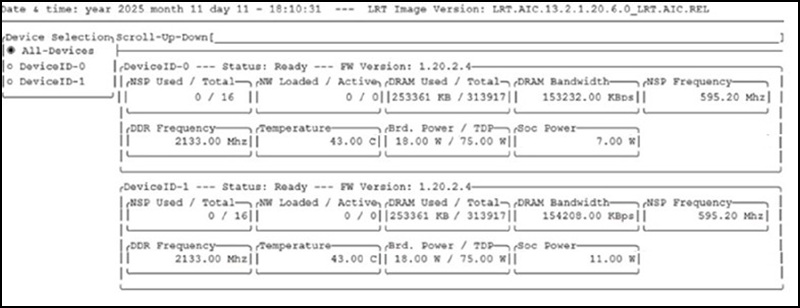
Ecco un altro esempioqaic-utilmentre la scheda AI100 esegue un carico di lavoro di inferenza AI. In questo caso, mostra un modello più grande: qwen3-coder:30b. L'output mostra che tutti i 16 NSP vengono utilizzati su ciascun dispositivo AI100, la temperatura della scheda è aumentata a 47 °C a causa delle temperature di inattività inferiori, che ogni parte AI100 utilizza ~13 GB ciascuno, per un totale di 26 GB per il modello, la potenza complessiva utilizzata per la scheda è 51 su un massimo di 75 W, e che la frequenza NSP è aumentata per il carico di lavoro a 1100 Mhz.
Output di esempio per l'inferenza in esecuzione di AI100 conqaic-util -t 1.root@dell:~# qaic-util -t 1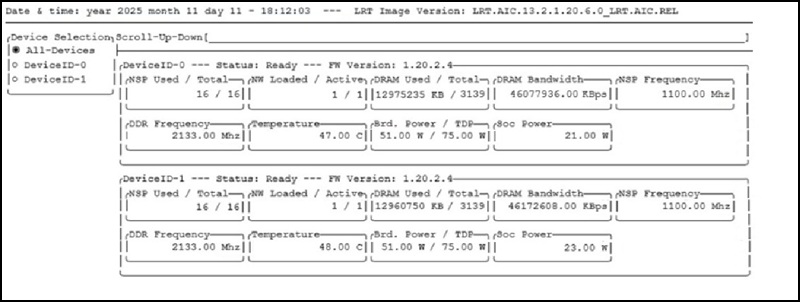
Per ripristinare la scheda AI100, utilizzare il pulsanteqaic-util -s. Questo comando richiede l'autorizzazione hardware all'interno del container che richiede il parametro della riga di comando "-privileged" durante l'esecuzione del container. L'output di esempio seguente mostra l'utilizzo diqaic util -sseguito daqaic-util -t1 per monitorare lo stato della scheda. I valori dei campi non validi come nell'output di esempio riportato di seguito vengono visualizzati fino a quando la scheda non completa il ripristino:
Esempio di output del ripristino della scheda AI100 utilizzandoqaic-util -seqaic-util -t 1.root@dell:~# qaic-util -s Resetting all devices… 0000:04:00.0: 0000:04:00.0 success 0000:05:00.0: 0000:05:00.0 success root@dell:~# qaic-util -t 1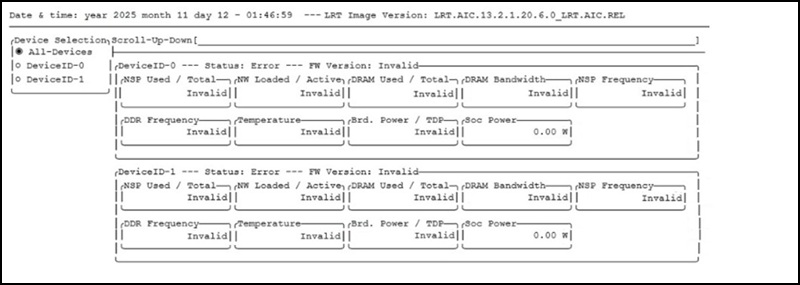
Utilizzare un singolo prompt di sistema per visualizzare lo stato della scheda AI100 utilizzando il contenitore Docker di AI100 come indicato di seguito.
Avviare il contenitore Docker AI100.docker run --rm -it \ --privileged \ --device=/dev/accel/accel1 \ --device=/dev/accel/accel2 \ --network host \ --ulimit nofile=1048576 \ -e OMP_NUM_THREADS=8 \ ghcr.io/quic/cloud_ai_inference_ubuntu24:1.20.6.0 \ qaic-util -t 1docker run --rm -it \ --privileged \ --device=/dev/accel/accel1 \ --device=/dev/accel/accel2 \ --network host \ --ulimit nofile=1048576 \ -e OMP_NUM_THREADS=8 \ ghcr.io/quic/cloud_ai_inference_ubuntu24:1.20.6.0 \ qaic-util -t 1Nota: Le righe di output di errore vengono visualizzate durante l'esecuzione diqaic-util -seqaic-util -t 1e nel relativo output di griglia che mostra "Non valido" per la temperatura e l'alimentazione della scheda/TDP e "0,00 W" mostrato per l'alimentazione SoC. Sono in corso modifiche upstream per risolvere questo problema nei prossimi aggiornamenti del contenitore Docker del sistema operativo Ubuntu e AI100. -
Esecuzione dell'inferenza di test
Questa sezione mostra come eseguire un test di inferenza rapida sulla scheda AI100. Utilizzare questo test di inferenza per verificare la funzionalità della scheda AI100.
Utilizzare il comando della riga di comando
qaic-runnerper eseguire il primo carico di lavoro di inferenza di test. Utilizzare-dper specificare il dispositivo AI100 di destinazione,-aspecificare il numero di NSP da utilizzare, e-nPer il numero di iterazioni:
Esempio di inferenza del test tramiteqaic-runner.docker run --rm -it \ --device=/dev/accel/accel1 \ --device=/dev/accel/accel2 \ --network host \ --ulimit nofile=1048576 \ -e OMP_NUM_THREADS=8 \ ghcr.io/quic/cloud_ai_inference_ubuntu24:1.20.6.0 \ qaic-runner -t /opt/qti-aic/test-data/aic100/v2/1nsp/1nsp-conv-hmx/ -a 16 -n 5000 -d 0docker run --rm -it \ --device=/dev/accel/accel1 \ --device=/dev/accel/accel2 \ --network host \ --ulimit nofile=1048576 \ -e OMP_NUM_THREADS=8 \ ghcr.io/quic/cloud_ai_inference_ubuntu24:1.20.6.0 \ qaic-runner -t /opt/qti-aic/test-data/aic100/v2/1nsp/1nsp-conv-hmx/ -a 16 -n 5000 -d 0
Sullo schermo viene visualizzato un output di esempio, come il seguente:
Output di esempio per l'esecuzione dell'inferenza di test.dell@dell:~$ docker run --rm -it \ --device=/dev/accel/accel1 \ --device=/dev/accel/accel2 \ --network host \ --ulimit nofile=1048576 \ -e OMP_NUM_THREADS=8 \ ghcr.io/quic/cloud_ai_inference_ubuntu24:1.20.6.0 \ qaic-runner -t /opt/qti-aic/test-data/aic100/v2/1nsp/1nsp-conv-hmx/ -a 16 -n 5000 -d 0 loading /opt/qti-aic/dev/lib/x86_64/libQAic.so ---- Stats ---- InferenceCnt 5000 TotalDuration 22544us BatchSize 1 Inf/Sec 221788.502 -
Collegamenti utili
La tabella seguente include un elenco di risorse e collegamenti chiave e utili per AI100 per iniziare a ottenere il massimo dalla scheda di inferenza AI100.
- Guida
utente di Qualcomm AI100: Punto di partenza per tutti gli argomenti AI100 - guida utente completa per AI100
- Libreria
- Contenitori
- Contenitori QAIC - 24.04 più recente
- Blog
- http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/ Nota: Questo URL non è un link HTTPS. Utilizzare a proprio rischio e pericolo.
Nota: Accedere al sito del supporto e utilizzare la parola chiave "Filter" Linux per visualizzare altri articoli Dell associati a Dell Pro Max 16 Plus MB16250 con notebook Al100: - Guida
-
Modelli predefiniti AI100
La tabella seguente include un'istantanea dei modelli di intelligenza artificiale preintegrati per l'esecuzione all'interno del container Docker AI100 (ad esempio utilizzando vLLM).
La scheda di inferenza AI100 esegue i modelli utilizzando un formato QPC (Qualcomm Program Container). I QPC possono essere creati da modelli Huggingface utilizzando gli SDK AI100 Platform e Apps, oppure utilizzare QPC di modelli AI predefiniti dal catalogo Zentree online al seguente link. I QPC sono progettati per il numero di dispositivi AI100 sulla scheda: Dell Pro Max 16 Plus con scheda di inferenza Qualcomm supporta QPC costruiti per funzionare su uno o due SoC (AI100 System on a Chip). Un QPC progettato per due dispositivi AI100 utilizza il tensizing per poter eseguire modelli di grandi dimensioni utilizzando l'elaborazione di due dispositivi AI100 su tutti i 64 GB di memoria sulla scheda.
Vedere la scheda del catalogo al seguente link per http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/
Nota: Questi URL non sono link HTTPS. Utilizzare a proprio rischio e pericolo.Famiglia di modelli Architettura del modello Modello rappresentativo Modello Versione QAIC SDK Classe automatica QEff Attività Collegamento QPC BERT BERTModel BAAI/bge-large-en-v1.5 Modello di incorporamento 1.19.6 QEFFAutoModel Incorporamento del testo http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.19.6/bge-large-en-v1.5/ BERT BERTModel BAAI/bge-m3 Modello di incorporamento 1.19.6 QEFFAutoModel Incorporamento del testo http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.19.6/bge-m3/ BERT BERTModel BAAI/bge-base-en-v1.5 Modello di incorporamento 1.19.6 QEFFAutoModel Incorporamento del testo http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.19.6/bge-base-en-v1.5/ DeepSeek-R1-Distill-Lama LamaForCausalLM Valdemardi/DeepSeek-R1-Distill-Llama-70B-AWQ Modello linguistico di solo testo 1.20.4 QEFFAutoModelForCausalLM Generazione di testo http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/DeepSeek-R1-Distill-Llama-70B-AWQ/ DeepSeek-R1-Distill-Lama LamaForCausalLM Casperhansen/Deepseek-R1-distill-lama-8B-AWQ Modello linguistico di solo testo 1.20.4 QEFFAutoModelForCausalLM Generazione di testo http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/deepseek-r1-distill-llama-8b-awq/ DeepSeek-R1-Distill-Qwen Qwen2ForCausalLM Valdemardi/DeepSeek-R1-Distill-Llama-32B-AWQ Modello linguistico di solo testo 1.20.4 QEFFAutoModelForCausalLM Generazione di testo http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/DeepSeek-R1-Distill-Qwen-32B-AWQ/ DeepSeek-R1-Distill-Qwen Qwen2ForCausalLM Casperhansen/Deepseek-R1-distill-QWEN-7B-AWQ Modello linguistico di solo testo 1.20.4 QEFFAutoModelForCausalLM Generazione di testo http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/deepseek-r1-distill-qwen-7b-awq/ Gemma3 Gemma3ForConditionalGeneration google/gemma-3-4b-it Modello linguistico multimodale 1.20.4 QEFFAutoModelForImageTextToText Modelli di linguaggio visivo (generazione di testo + immagine) http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/gemma-3-4b-it/ GPT-OSS GptOssForCausalLM OpenAI/GPT-OSS-20B Modello linguistico di solo testo 1.20.4 QEFFAutoModeForCausalLM Generazione di testo http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/gpt-oss-20b/ Granito-3.2 GranitoForCausalLM IBM-granito/granito-3.2-8b-istruzioni Modello linguistico di solo testo 1.20.4 QEFFAutoModelForCausalLM Generazione di testo http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/granite-3.2-8b-instruct/ Granito-3.3 GranitoForCausalLM IBM-granito/granito-3.3-8b-istruzioni Modello linguistico di solo testo 1.20.4 QEFFAutoModelForCausalLM Generazione di testo http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/granite-3.3-8b-instruct/ Lama 3.1 LamaForCausalLM meta-lama/Lama-3.1-8B-Istruire Modello linguistico di solo testo 1.20.4 QEFFAutoModelForCausalLM Generazione di testo http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/Llama-3.1-8B/ Lama 3.1 Nemotron LamaForCausalLM invidia-lama-3.1-nemotron-70B-istruire-HF-AWQ-INT4 Modello linguistico di solo testo 1.20.4 QEFFAutoModelForCausalLM Generazione di testo http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/Nvidia-Llama-3.1-Nemotron-70B-Instruct-HF-AWQ-INT4/ Lama 3.1 Nemotron LamaForCausalLM nvidia/Lama-3.1-Nemotron-Nano-8B-v1 Modello linguistico di solo testo 1.20.4 QEFFAutoModelForCausalLM Generazione di testo http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/Llama-3.1-Nemotron-Nano-8B-v1/ Lama 3.2 LamaForCausalLM meta-lama/Lama-3.2-1B Modello linguistico di solo testo 1.20.4 QEFFAutoModelForCausalLM Generazione di testo http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/Llama-3.2-1B/ Lama 3.2 LamaForCausalLM meta-lama/Lama-3.2-3B Modello linguistico di solo testo 1.20.4 QEFFAutoModelForCausalLM Generazione di testo http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/Llama-3.2-3B/ Lama 3.2 LamaForCausalLM meta-lama/Llama-3.2-3B-Istruire Modello linguistico di solo testo 1.20.4 QEFFAutoModelForCausalLM Generazione di testo http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/Llama-3.2-3B-Instruct/ Lama 3.2 MlamaForConditionalGeneration meta-lama/Lama-3.2-11B-Visione-Istruire Modello linguistico multimodale 1.20.4 QEFFAutoModelForImageTextToText Modelli di linguaggio visivo (generazione di testo + immagine) http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/Llama-3.2-11B-Vision-Instruct/ Lama 3.2 Istruire LamaForCausalLM meta-lama/Llama-3.2-1B-Istruire Modello linguistico di solo testo 1.20.4 QEFFAutoModelForCausalLM Generazione di testo http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/Llama-3.2-1B-Instruct/ Lama 3.x LamaForCausalLM Bersaglio: Meta-lama-3.1-70B-Instruct-AWQ-INT4
Bozza: Lama-3.2-1B-IstruireDecodifica speculativa (SpD) 1.20.4 QEFFAutoModelForCausalLM Generazione di testo http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/spd/meta-llama/ Lama 3.x LamaForCausalLM Bersaglio: casperhansen/lama-3.3-70b-instruct-awq
Bozza: meta-llama/Llama-3.2-1B-InstructDecodifica speculativa (SpD) 1.20.4 QEFFAutoModelForCausalLM Generazione di testo http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/spd/llama33-70b-awq__draft-llama32-1b/ Mistral MistralForCausalLM mistralai/Mistral-7B-Instruct-v0.1 Modello linguistico di solo testo 1.20.4 QEFFAutoModelForCausalLM Generazione di testo http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/Mistral-7B-Instruct-v0.1/ Phi-4 Phi3ForCausalLM Microsoft/PHI-4 Modello linguistico di solo testo 1.20.4 QEFFAutoModelForCausalLM Generazione di testo http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/phi-4/ Qwen3 Qwen3Moe Qwen/Qwen3-30B-A3B-Istruct-2507 Modello linguistico di solo testo 1.20.4 QEFFAutoModelForCausalLM Generazione di testo http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/Qwen3-30B-A3B-Instruct-2507/ Qwen3-Coder Qwen3Moe Qwen/Qwen3-Coder-30B-A3B-Istruzioni Modello linguistico di solo testo 1.20.4 QEFFAutoModelForCausalLM Generazione di codice http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/Qwen3-Coder-30B-A3B-Instruct/ Sarvamai Sarvamai Sarvamai/Sarvam-1 Modello linguistico di solo testo 1.20.4 QEFFAutoModelForCausalLM Focus sulla lingua indiana per la generazione di testo http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/sarvam-1/ SDXL StableDiffusionForTextToImage di stabilitàAI/diffusione-stabile-XL-BASE-1.0 Modello linguistico multimodale 1.20.4 AutoPipelineForText2Image Modelli di linguaggio visivo (generazione di testo + immagine) http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/stable-diffusion-xl-base-1.0/ SDXL Turbo StableDiffusionForTextToImage StabilitàAI/SDXL-Turbo Modello linguistico multimodale 1.20.4 AutoPipelineForText2Image Modelli di linguaggio visivo (generazione di testo + immagine) http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/sdxl_turbo/ Sussurro Sussurro OpenAI/Whisper-Base Modello audio 1.20.4 QEFFAutoModelForSpeechSeq2Seq Riconoscimento vocale automatico (trascrizione) http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/whisper-base/ Sussurro Sussurro OpenAI/Whisper-large-V3-Turbo Modello audio 1.20.4 QEFFAutoModelForSpeechSeq2Seq Riconoscimento vocale automatico (trascrizione) http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/whisper-large-v3-turbo/ Sussurro Sussurro OpenAI/Whisper-Large Modello audio 1.20.4 QEFFAutoModelForSpeechSeq2Seq Riconoscimento vocale automatico (trascrizione) http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/whisper-large/ Sussurro Sussurro OpenAI/Whisper-medium Modello audio 1.20.4 QEFFAutoModelForSpeechSeq2Seq Riconoscimento vocale automatico (trascrizione) http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/whisper-medium/ Sussurro Sussurro OpenAI/Whisper-Small Modello audio 1.20.4 QEFFAutoModelForSpeechSeq2Seq Riconoscimento vocale automatico (trascrizione) http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/whisper-small/ Sussurro Sussurro openai-whisper-minuscolo Modello audio 1.20.4 QEFFAutoModelForSpeechSeq2Seq Riconoscimento vocale automatico (trascrizione) http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/whisper-tiny/ XLM-RoBERTa XLMRobertaModel IntFloat/Multilingual-E5-Large Modello di incorporamento 1.20.4 QEFFAutoModel Incorporamento del testo http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/multilingual-e5-large/ XLM-RoBERTa XLMRobertaModel Intfloat/Multilingual-E5-Small Modello di incorporamento 1.19.6 QEFFAutoModel Incorporamento del testo http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.19.6/multilingual-e5-small/