Como configurar o Dell Pro Max 16 Plus com a placa de inferência Qualcomm no Linux
Summary: Saiba como configurar o Dell Pro Max 16 Plus MB16250 com a placa de inferência Qualcomm no Linux.
Instructions
Como configurar o Dell Pro Max 16 Plus com placa de inferência Qualcomm no Linux
Bem-vindo ao Dell Pro Max 16 Plus com placa de inferência Qualcomm AI100!
Siga estas etapas de configuração única abaixo para preparar a placa para cargas de trabalho de inferência de IA usando o Ubuntu 24.04 na workstation Dell Pro Max 16 Plus. Isso garante que a workstation e a placa tenham o software correto e as linhas de base de configuração para começar a usar a placa.
-
Verificando a instalação da placa AI100.
Use o seguintelspciComando para verificar se a placa está instalada no notebook:lspci | grep Qualcomm
Este comando exibe duas (2) entradas de dispositivo Qualcomm a100 PCIe para a placa AI100.dell@dell:~$ lspci | grep Qualcomm 04:00.0 Processing accelerators: Qualcomm Technologies, Inc Device a100 05:00.0 Processing accelerators: Qualcomm Technologies, Inc Device a100 dell@dell:~$ -
Atualização do BIOS na workstation Dell Pro Max 16 Plus.
Atualize o BIOS da workstation para garantir que o notebook tenha o suporte mais recente para a placa de inferência AI100. Use os seguintes comandos para verificar se há atualizações do BIOS e, em seguida, atualize se houver uma atualização disponível:
Comandos para verificar se há atualizações do BIOS:sudo fwupdmgr refresh --force sudo fwupdmgr upgrade
Exemplo de saída atualizando para o BIOS mais recente.dell@dell:~$ sudo fwupdmgr refresh --force Updating lvfs Downloading… [*************************************] Successfully downloaded new metadata: 7 local devices supported dell@dell:~$ sudo fwupdmgr upgrade Devices with no available firmware updates: • Integrated Webcam 8M • PC811 SED SK hynix 2048GB • TPM • UEFI Device Firmware • UEFI dbx • USB4 host controller Perform operation? [Y|n]: Y Waiting… [***************************************] Successfully installed firmware Do not turn off your computer or remove the AC adapter while the update is in progress. An update requires a reboot to complete. Restart now? [y|N]:
Verifique se a versão 2.22 ou superior do BIOS está instalada usando odmidecodecomando: Verificando a versão existente do firmware do BIOS.sudo dmidecode -t 0 -
Como atualizar o sistema operacional (SO) Ubuntu em sua workstation Dell Pro Max 16 Plus
Na próxima atualização do sistema operacional Ubuntu na workstation, o suporte para a placa de inferência AI100 será integrado ao Ubuntu 24.04. A atualização do Ubuntu garante que os módulos de kernel mais recentes e as atualizações de firmware do AI100 estejam disponíveis para sua placa.
Para atualizar o Ubuntu, use o "Software Updater" do Ubuntu no menu Aplicativos da área de trabalho ou use os seguintes comandos em um Terminal:
Comandos para atualizar o software Ubuntu no Terminal:sudo apt-get update sudo apt-get upgrade sudo rebootDepois que o notebook baixar, instalar e atualizar o Ubuntu, reinicialize a workstation para garantir que todas as alterações no tempo de inicialização do kernel ocorram.
Verifique se o kernel do Ubuntu atualizado tem a versão 6.14.0-1017-oem ou mais recente. Essa versão inclui os módulos de kernel assinados que dão suporte ao AI100 com a inicialização segura ativada. Use o comando a seguir para verificar a versão do kernel.
Verificando se o kernel do Linux é a versão 6.14.0-1017-oem ou mais recente.dell@dell:~$ uname -r 6.14.0-1017-oemdell@dell:~$ uname -r 6.14.0-1017-oem
Em seguida, verifique se o pacote de firmware Linux que inclui o firmware do AI100 é a versão 2.22 ou superior usando este comando de linha de comando:
Verifique se o firmware do Linux é a versão 2.22 ou posterior.dell@dell:~$ dpkg-query --list linux-firmware Desired=Unknown/Install/Remove/Purge/Hold | Status=Not/Inst/Conf-files/Unpacked/halF-conf/Half-inst/trig-aWait/Trig-pend |/ Err?=(none)/Reinst-required (Status,Err: uppercase=bad) ||/ Name Version Architecture Description +++-==============-================================-============-================================= ii linux-firmware 20240318.git3b128b60-0ubuntu2.22 amd64 Firmware for Linux kernel drivers dell@dell:~$ -
Atualização dos parâmetros do kernel do GRUB.
Para usar totalmente a placa de inferência Qualcomm AI100, desative o recurso chamado PCIe Access Control System (ACS). Isso é necessário para suportar fatiamento de tensor totalmente usando ambos os dispositivos AI100 na placa Qualcomm AI100. Desative o ACS no switch PCIe na placa AI100. Isso permite acesso total aos dados entre os dois dispositivos AI100 e todos os 64 GB de RAM integrada ao executar a inferência em ambos.Isso é feito passando um parâmetro do kernel do Linux que é adicionado à configuração do GRUB para dar suporte à placa de inferência Qualcomm AI100. Os parâmetros do kernel são configurações passadas para o kernel do Linux durante a inicialização que instrui o kernel como configurar determinados recursos. Nesse caso, o ACS está sendo desativado para a placa AI100. A adição de um parâmetro de kernel ao arquivo de configuração do GRUB faz isso.
Abra o arquivo de configuração do GRUB com privilégios root usando um editor de texto.
Edite o arquivo de configuração do GRUB/etc/default/grub.sudo nano /etc/default/grubsudo nano /etc/default/grub
Edite oGRUB_CMDLINE_LINUX_DEFAULTlinha para adicionar opci=disable_acs_redir(desative o ACS no switch PCIe da placa AI100). Certifique-se de ter a sintaxe exata abaixo. Certifique-se também de que haja apenas umGRUB_CMDLINE_LINUX_DEFAULTlinha no/etc/default/grubArquivo (mescle as opções do kernel, se necessário, em uma linha).
MudarGRUB_CMDLINE_LINUX_DEFAULTLinha.GRUB_CMDLINE_LINUX_DEFAULT="quiet splash pci=disable_acs_redir=03:00.0\;03:01.0"Pressione CTRL+X, selecione Y e pressione Enter para salvar as alterações de configuração. Agora, execute o seguinte e reinicialize para que a ação entre em vigor.
Regenere a configuração do GRUB.sudo update-grub sudo rebootVerifique as alterações usando os seguintes comandos após a reinicialização.
Verifique as alterações de configuração do GRUB.dell@dell:~$ cat /proc/cmdline BOOT_IMAGE=/boot/vmlinuz-6.14.0-1016-oem root=UUID=cd20aec8-6b44-45f7-bca5-307240cec24b ro quiet splash pci=disable_acs_redir=03:00.0;03:01.0 vt.handoff=7dell@dell:~$ cat /proc/cmdline BOOT_IMAGE=/boot/vmlinuz-6.14.0-1016-oem root=UUID=cd20aec8-6b44-45f7-bca5-307240cec24b ro quiet splash pci=disable_acs_redir=03:00.0;03:01.0 vt.handoff=7
Verifique se o ACS está desabilitado usando dmesg. As mensagens para "ACS configurado" são exibidas como abaixo:dell@dell:~$ sudo dmesg | grep ACS [ 0.000000] Command line: BOOT_IMAGE=/boot/vmlinuz-6.14.0-1016-oem root=UUID=cd20aec8-6b44-45f7-bca5-307240cec24b ro quiet splash pcie_port_m=force pci=disable_acs_redir=03:00.0;03:01.0 vt.handoff=7 [ 0.141658] Kernel command line: BOOT_IMAGE=/boot/vmlinuz-6.14.0-1016-oem root=UUID=cd20aec8-6b44-45f7-bca5-307240cec24b ro quiet splash pcie_port_m=force pci=disable_acs_redir=03:00.0;03:01.0 vt.handoff=7 [ 0.741030] pci 0000:03:00.0: Configured ACS to 0x0000 [ 0.745422] pci 0000:03:01.0: Configured ACS to 0x0000 -
Instalar o Docker
O caminho mais rápido para executar a inferência na placa AI100 é usar contêineres do Docker do AI100 pré-configurados que incluem suporte para a placa de inferência Qualcomm AI100. O contêiner do Docker predefinido fornece um ambiente pronto para uso para executar as cargas de trabalho de inferência. O contêiner inclui a plataforma Qualcomm AI100 e SDKs de aplicativos e toolchain, ambiente Python e Qualcomm Efficient Transformers para compilar modelos de IA e executar inferências, bem como incluir suporte pronto para usar vLLM e Triton para a placa de inferência AI100.
Para instalar o Docker no Ubuntu, use o seguinte comando:
sudo snap install docker
Para executar o docker como um usuário normal, execute os comandos a seguir.
Comandos para executar o docker como um usuário normal.# create and join the docker group sudo addgroup --system docker sudo adduser $USER docker newgrp docker # disable and re-enable the docker snap if you added the group while Docker Engine was running sudo snap disable docker sudo snap enable docker# create and join the docker group sudo addgroup --system docker sudo adduser $USER docker newgrp docker # disable and re-enable the docker snap if you added the group while Docker Engine was running sudo snap disable docker sudo snap enable docker
A prefixação de todos os comandos do docker com sudo será obrigatória se o usuário não for adicionado ao grupo do docker:sudo docker run ...Referência: Snapshot do Docker
Alternativamente, o Docker pode ser instalado usando apt Debian Docker Docs
Depois que o Docker estiver instalado, teste a instalação da seguinte maneira:
Verifique se o Docker foi instalado com o Hello-World:dell@dell:~$ docker run hello-world Unable to find image 'hello-world:latest' locally latest: Pulling from library/hello-world 17eec7bbc9d7: Pull complete Digest: sha256:d4aaab6242e0cace87e2ec17a2ed3d779d18fbfd03042ea58f2995626396a274 Status: Downloaded newer image for hello-world:latest Hello from Docker! This message shows that your installation appears to be working correctly. ... -
A placa de inferência AI100 da workstation Dell Pro Max 16 Plus já está pronta para uso!
Isso conclui a configuração única necessária para usar a placa de inferência AI100. As próximas seções mostram como usar as ferramentas AI100 para ver o status da placa e executar a inferência simples inicial para verificar se a placa AI100 está operacional.
-
Como verificar a placa AI100
Verifique a placa AI100 e execute a inferência inicial usando um contêiner do Docker do AI100 pré-criado que contenha todos os SDKs de aplicativos e da plataforma AI100, o toolchain e as ferramentas de inferência vLLM e Triton necessárias para usar a placa.
Se esta for a primeira vez que o contêiner do Docker AI100 é executado, esse comando também busca o contêiner. A imagem do contêiner do Docker AI100 tem ~14 GB de download. Para iniciar o contêiner do Docker AI100, use o seguinte comando:
Inicie o contêiner do Docker AI100.docker run --rm -it \ --privileged \ --device=/dev/accel/accel1 \ --device=/dev/accel/accel2 \ --network host \ --ulimit nofile=1048576 \ -e OMP_NUM_THREADS=8 \ ghcr.io/quic/cloud_ai_inference_ubuntu24:1.20.6.0 \ /bin/bash
Depois que o contêiner do Docker AI100 for obtido e executado, um resultado semelhante será exibido na tela:
Exemplo de saída após iniciar o contêiner do Docker AI100.dell@dell:~$ docker run --rm -it --device=/dev/accel/accel1 --device=/dev/accel/accel2 --network host --ulimit nofile=1048576 -e OMP_NUM_THREADS=8 -v ~/Downloads/qwen3_coder_qpc:/root/qpc/ ghcr.io/quic/cloud_ai_inference_ubuntu24:1.20.6.0 /bin/bash ================================== == Qualcomm Cloud AI Containers == ================================== Platform SDK version: 1.20.6.0 Apps SDK version: 1.20.6.0 This container image and its contents are governed by the terms of the license at /usr/share/doc/CONTAINER_LICENSE.txt. By pulling and using the container, you accept the terms and conditions of this license. root@dell:~#dell@dell:~$ docker run --rm -it --device=/dev/accel/accel1 --device=/dev/accel/accel2 --network host --ulimit nofile=1048576 -e OMP_NUM_THREADS=8 -v ~/Downloads/qwen3_coder_qpc:/root/qpc/ ghcr.io/quic/cloud_ai_inference_ubuntu24:1.20.6.0 /bin/bash ================================== == Qualcomm Cloud AI Containers == ================================== Platform SDK version: 1.20.6.0 Apps SDK version: 1.20.6.0 This container image and its contents are governed by the terms of the license at /usr/share/doc/CONTAINER_LICENSE.txt. By pulling and using the container, you accept the terms and conditions of this license. root@dell:~#
Usar o AI100qaic-util -qpara fornecer saída textual do estado da placa AI100, como no exemplo de saída a seguir.
Exemplo de resultado paraqaic-util -qroot@dell:~# qaic-util -q LRT QC_IMAGE_VERSION: LRT.AIC.13.2.1.20.6.0 LRT IMAGE_VARIANT: LRT.AIC.REL Number of devices queried: 2 QID 0 Status:Ready ...É possível visualizar o status da grade usando o
Exemplo de saída ociosa paraqaic-util -t1 comando que atualiza periodicamente o status da placa. O exemplo de saída a seguir mostra a placa AI100 em marcha lenta. A placa AI100 inclui dois dispositivos AI100, cada um com 16 núcleos de computação de processador de sinal neural (NSP). Cada dispositivo mostra 32 GB de memória, totalizando 64 GB na placa:qaic-util -t 1.root@dell:~# qaic-util -t 1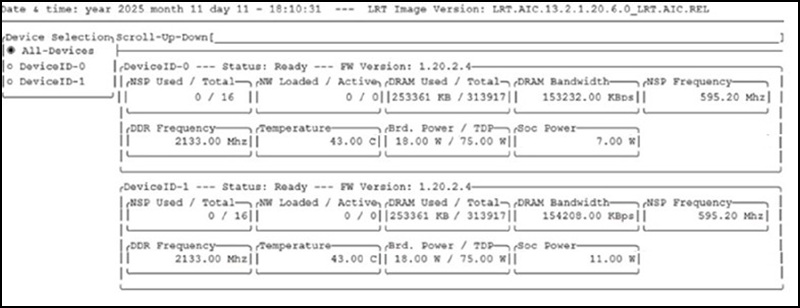
Aqui está outro exemploqaic-utilresultado enquanto a placa AI100 está executando uma carga de trabalho de inferência de IA. Neste caso, ele mostra um modelo maior - qwen3-coder:30b. A saída mostra que todos os 16 NSPs estão sendo usados em cada dispositivo AI100, a temperatura da placa aumentou para 47 °C em temperaturas ociosas mais baixas, que cada peça AI100 está usando ~13 GB cada, totalizando 26 GB para o modelo, a potência geral usada para a placa é de 51 de um máximo de 75 W, e que a frequência do PNS aumentou para a carga de trabalho para 1100 Mhz.
Exemplo de resultado para inferência de execução do AI100 usandoqaic-util -t 1.root@dell:~# qaic-util -t 1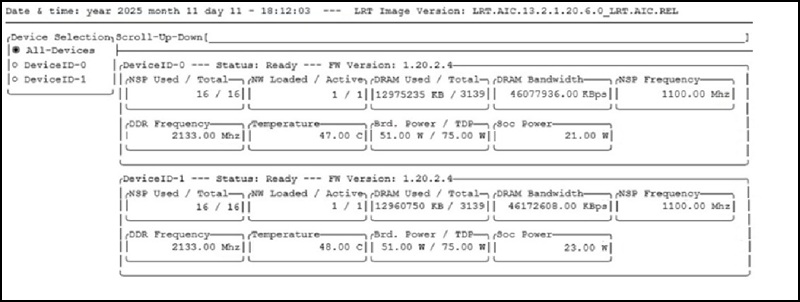
Para redefinir a placa AI100, use o comandoqaic-util -s. Esse comando requer permissão de hardware dentro do contêiner, exigindo o parâmetro de linha de comando "-privileged" ao executar o contêiner. O exemplo de resultado a seguir mostra o usoqaic util -sseguido porqaic-util -t1 para monitorar o status do cartão. Valores de campo inválidos, como no exemplo de resultado abaixo, são exibidos até que o cartão conclua a redefinição:
Exemplo de resultado da redefinição da placa AI100 usandoqaic-util -seqaic-util -t 1.root@dell:~# qaic-util -s Resetting all devices… 0000:04:00.0: 0000:04:00.0 success 0000:05:00.0: 0000:05:00.0 success root@dell:~# qaic-util -t 1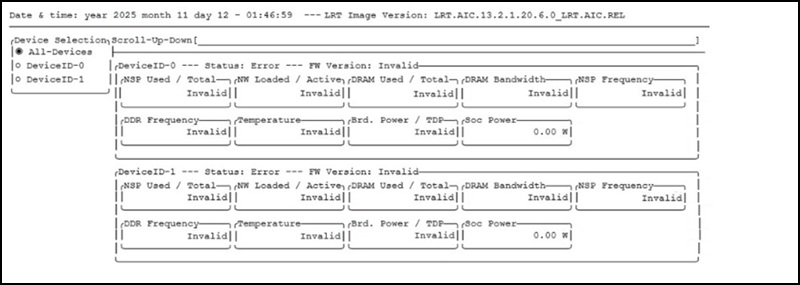
Use um prompt do sistema único para exibir o status da placa AI100 usando o contêiner do AI 100 Docker da seguinte maneira.
Inicie o contêiner do Docker AI100.docker run --rm -it \ --privileged \ --device=/dev/accel/accel1 \ --device=/dev/accel/accel2 \ --network host \ --ulimit nofile=1048576 \ -e OMP_NUM_THREADS=8 \ ghcr.io/quic/cloud_ai_inference_ubuntu24:1.20.6.0 \ qaic-util -t 1docker run --rm -it \ --privileged \ --device=/dev/accel/accel1 \ --device=/dev/accel/accel2 \ --network host \ --ulimit nofile=1048576 \ -e OMP_NUM_THREADS=8 \ ghcr.io/quic/cloud_ai_inference_ubuntu24:1.20.6.0 \ qaic-util -t 1Nota: As linhas de saída de erro são vistas ao executar oqaic-util -seqaic-util -t 1e em sua saída de grade mostrando "Inválido" para temperatura e alimentação/TDP da placa e "0,00 W" mostrado para Alimentação do SoC. Há mudanças no voo upstream para resolver isso nas próximas atualizações do sistema operacional Ubuntu e do contêiner do Docker AI100. -
Executando inferência de teste
Esta seção mostra como executar um teste de inferência rápida na placa AI100. Use esse teste de inferência para verificar a funcionalidade da placa AI100.
Usar o comando de linha de comando
qaic-runnerpara executar a primeira carga de trabalho de inferência de teste. Use-dpara especificar o dispositivo AI100 de destino,-apara especificar o número de NSPs a serem usados, e-npara o número de iterações:
Inferência de teste de amostra usandoqaic-runner.docker run --rm -it \ --device=/dev/accel/accel1 \ --device=/dev/accel/accel2 \ --network host \ --ulimit nofile=1048576 \ -e OMP_NUM_THREADS=8 \ ghcr.io/quic/cloud_ai_inference_ubuntu24:1.20.6.0 \ qaic-runner -t /opt/qti-aic/test-data/aic100/v2/1nsp/1nsp-conv-hmx/ -a 16 -n 5000 -d 0docker run --rm -it \ --device=/dev/accel/accel1 \ --device=/dev/accel/accel2 \ --network host \ --ulimit nofile=1048576 \ -e OMP_NUM_THREADS=8 \ ghcr.io/quic/cloud_ai_inference_ubuntu24:1.20.6.0 \ qaic-runner -t /opt/qti-aic/test-data/aic100/v2/1nsp/1nsp-conv-hmx/ -a 16 -n 5000 -d 0
Um exemplo de resultado como o seguinte é exibido na tela:
Exemplo de saída para inferência de teste em execução.dell@dell:~$ docker run --rm -it \ --device=/dev/accel/accel1 \ --device=/dev/accel/accel2 \ --network host \ --ulimit nofile=1048576 \ -e OMP_NUM_THREADS=8 \ ghcr.io/quic/cloud_ai_inference_ubuntu24:1.20.6.0 \ qaic-runner -t /opt/qti-aic/test-data/aic100/v2/1nsp/1nsp-conv-hmx/ -a 16 -n 5000 -d 0 loading /opt/qti-aic/dev/lib/x86_64/libQAic.so ---- Stats ---- InferenceCnt 5000 TotalDuration 22544us BatchSize 1 Inf/Sec 221788.502 -
Links úteis
A tabela abaixo inclui uma lista dos principais e úteis recursos e links do AI100 para começar a aproveitar ao máximo o cartão de inferência do AI100.
- Guia
do usuário do Qualcomm AI100: Ponto de partida para todos os tópicos AI100 - guia do usuário abrangente do AI100
- Biblioteca
- Contêineres QAIC
- Contêineres QAIC — 24.04 mais recente
- Blog
- http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/ Nota: Este URL não é um link HTTPS. Use por sua conta e risco.
Nota: Acesse o site de suporte e use a palavra-chave de filtro Linux para ver outros artigos da Dell associados ao MB16250 Dell Pro Max 16 Plus com notebook Al100: - Guia
-
Modelos pré-criados do AI100
A tabela abaixo inclui um snapshot dos modelos de IA que são pré-criados para serem executados dentro do contêiner do Docker AI100 (usando vLLM, por exemplo).
A placa de inferência AI100 executa modelos usando um formato Qualcomm Program Container (QPC). Os QPCs podem ser criados a partir de modelos Huggingface usando a plataforma AI100 e os SDKs de aplicativos, ou usar QPCs de modelo de IA pré-criados do catálogo on-line da Zentree no link a seguir. As QPCs são criadas visando o número de dispositivos AI100 na placa — o Dell Pro Max 16 Plus com placa de inferência Qualcomm oferece suporte a QPCs criadas para serem executadas em um ou dois SoCs (sistema AI100 em um chip). Um QPC criado para dois dispositivos AI100 usa fatiamento tensor para poder executar modelos grandes usando a computação de dois dispositivos AI100 no total de 64 GB de memória na placa.
Consulte a guia catálogo no link a seguir para o http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/
Nota: Esses URLs não são links HTTPS. Use por sua conta e risco.Família de modelos Arquitetura do modelo Modelo representativo Tipo de modelo Versão do SDK do QAIC QEff Auto Classe Tarefa QPC Link BERT BERTModel BAAI/bge-large-en-v1.5 Modelo de incorporação 1.19.6 QEFFAutoModel Incorporação de texto Disponível em: http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.19.6/bge-large-en-v1.5/ BERT BERTModel BAAI/bge-m3 Modelo de incorporação 1.19.6 QEFFAutoModel Incorporação de texto Disponível em: http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.19.6/bge-m3/ BERT BERTModel BAAI/bge-base-en-v1.5 Modelo de incorporação 1.19.6 QEFFAutoModel Incorporação de texto Disponível em: qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.19.6/bge-base-en-v1.5/ DeepSeek-R1-Destilação-Lhama LlamaForCausalLM Valdemardi/DeepSeek-R1-Destilação-Llama-70B-AWQ Modelo de linguagem somente texto 1.20.4 QEFFAutoModelForCausalLM Geração de texto Disponível em: qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/DeepSeek-R1-Distill-Llama-70B-AWQ/ DeepSeek-R1-Destilação-Lhama LlamaForCausalLM casperhansen/deepseek-r1-destilar-llama-8b-awq Modelo de linguagem somente texto 1.20.4 QEFFAutoModelForCausalLM Geração de texto Disponível em: http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/deepseek-r1-distill-llama-8b-awq/ DeepSeek-R1-Destilação-Qwen Qwen2ForCausalLM Valdemardi/DeepSeek-R1-Destilação-Llama-32B-AWQ Modelo de linguagem somente texto 1.20.4 QEFFAutoModelForCausalLM Geração de texto Disponível em: qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/DeepSeek-R1-Distill-Qwen-32B-AWQ/ DeepSeek-R1-Destilação-Qwen Qwen2ForCausalLM casperhansen/deepseek-r1-destilar-qwen-7b-awq Modelo de linguagem somente texto 1.20.4 QEFFAutoModelForCausalLM Geração de texto Disponível em: http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/deepseek-r1-distill-qwen-7b-awq/ Gemma3 Gemma3ForConditionalGeneration Google/gemma-3-4b-it Modelo de linguagem multimodal 1.20.4 QEFFAutoModelForImageTextToText Modelos de linguagem de visão (texto + geração de imagens) Disponível em: qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/gemma-3-4b-it/ GPT-OSS GptOssForCausalLM openai/gpt-oss-20b Modelo de linguagem somente texto 1.20.4 QEFFAutoModeForCausalLM Geração de texto Disponível em: qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/gpt-oss-20b/ Granito-3.2 GranitoForCausalLM IBM-Granito/Granito-3.2-8B-Instruct Modelo de linguagem somente texto 1.20.4 QEFFAutoModelForCausalLM Geração de texto Disponível em: qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/granite-3.2-8b-instruct/ Granito-3.3 GranitoForCausalLM ibm-granito/granito-3.3-8b-instruir Modelo de linguagem somente texto 1.20.4 QEFFAutoModelForCausalLM Geração de texto Disponível em: qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/granite-3.3-8b-instruct/ Lhama 3,1 LlamaForCausalLM meta-lhama/Llama-3.1-8B-Instruir Modelo de linguagem somente texto 1.20.4 QEFFAutoModelForCausalLM Geração de texto Disponível em: http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/Llama-3.1-8B/ Lhama 3.1 Nemotron LlamaForCausalLM ibnzterrell/Nvidia-Llama-3.1-Nemotron-70B-Instrução-HF-AWQ-INT4 Modelo de linguagem somente texto 1.20.4 QEFFAutoModelForCausalLM Geração de texto Disponível em: http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/Nvidia-Llama-3.1-Nemotron-70B-Instruct-HF-AWQ-INT4/ Lhama 3.1 Nemotron LlamaForCausalLM nvidia/Llama-3.1-Nemotron-Nano-8B-v1 Modelo de linguagem somente texto 1.20.4 QEFFAutoModelForCausalLM Geração de texto Disponível em: http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/Llama-3.1-Nemotron-Nano-8B-v1/ Lhama 3,2 LlamaForCausalLM meta-lhama/Llama-3.2-1B Modelo de linguagem somente texto 1.20.4 QEFFAutoModelForCausalLM Geração de texto Disponível em: http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/Llama-3.2-1B/ Lhama 3,2 LlamaForCausalLM meta-lhama/Llama-3.2-3B Modelo de linguagem somente texto 1.20.4 QEFFAutoModelForCausalLM Geração de texto Disponível em: http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/Llama-3.2-3B/ Lhama 3,2 LlamaForCausalLM meta-lhama/Llama-3.2-3B-Instruir Modelo de linguagem somente texto 1.20.4 QEFFAutoModelForCausalLM Geração de texto Disponível em: http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/Llama-3.2-3B-Instruct/ Lhama 3,2 MllamaForConditionalGeneration meta-lhama/Llama-3.2-11B-Visão-Instrução Modelo de linguagem multimodal 1.20.4 QEFFAutoModelForImageTextToText Modelos de linguagem de visão (texto + geração de imagens) Disponível em: http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/Llama-3.2-11B-Vision-Instruct/ Llama 3.2 Instruir LlamaForCausalLM meta-lhama/Llama-3.2-1B-Instruir Modelo de linguagem somente texto 1.20.4 QEFFAutoModelForCausalLM Geração de texto Disponível em: http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/Llama-3.2-1B-Instruct/ Lhama 3.x LlamaForCausalLM Alvo: Meta-llama-3.1-70B-Instruct-AWQ-INT4
Rascunho: Lhama-3.2-1B-InstruirDecodificação especulativa (SpD) 1.20.4 QEFFAutoModelForCausalLM Geração de texto Disponível em: http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/spd/meta-llama/ Lhama 3.x LlamaForCausalLM Destino: casperhansen/llama-3.3-70b-instruct-awq
Rascunho: meta-llama/Llama-3.2-1B-instruirDecodificação especulativa (SpD) 1.20.4 QEFFAutoModelForCausalLM Geração de texto Disponível em: http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/spd/llama33-70b-awq__draft-llama32-1b/ Mistral MistralForCausalLM mistralai/Mistral-7B-Instruir-v0.1 Modelo de linguagem somente texto 1.20.4 QEFFAutoModelForCausalLM Geração de texto Disponível em: qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/Mistral-7B-Instruct-v0.1/ Phi-4 Phi3ForCausalLM Microsoft/PHI-4 Modelo de linguagem somente texto 1.20.4 QEFFAutoModelForCausalLM Geração de texto Disponível em: qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/phi-4/ Qwen3 Qwen3Moe Qwen/Qwen3-30B-A3B-Instrução-2507 Modelo de linguagem somente texto 1.20.4 QEFFAutoModelForCausalLM Geração de texto Disponível em: http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/Qwen3-30B-A3B-Instruct-2507/ Codificador Qwen3 Qwen3Moe Qwen/Qwen3-Coder-30B-A3B-Instruir Modelo de linguagem somente texto 1.20.4 QEFFAutoModelForCausalLM Geração de código Disponível em: http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/Qwen3-Coder-30B-A3B-Instruct/ Sarvamai Sarvamai sarvamai/sarvam-1 Modelo de linguagem somente texto 1.20.4 QEFFAutoModelForCausalLM Geração de texto Foco no idioma indiano Disponível em: qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/sarvam-1/ SDXL StableDiffusionForTextToImage stabilityai/stable-diffusion-xl-base-1.0 Modelo de linguagem multimodal 1.20.4 AutoPipelineForText2Image Modelos de linguagem de visão (texto + geração de imagens) Disponível em: http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/stable-diffusion-xl-base-1.0/ SDXL Turbo StableDiffusionForTextToImage StabilityAI/SDXL-Turbo Modelo de linguagem multimodal 1.20.4 AutoPipelineForText2Image Modelos de linguagem de visão (texto + geração de imagens) Disponível em: qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/sdxl_turbo/ Sussurro Sussurro openai/base whisper Modelo de áudio 1.20.4 QEFFAutoModelForSpeechSeq2Seq Reconhecimento automático de fala (transcrição) Disponível em: http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/whisper-base/ Sussurro Sussurro openai/sussurro-grande-v3-turbo Modelo de áudio 1.20.4 QEFFAutoModelForSpeechSeq2Seq Reconhecimento automático de fala (transcrição) Disponível em: qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/whisper-large-v3-turbo/ Sussurro Sussurro openai/sussurro grande Modelo de áudio 1.20.4 QEFFAutoModelForSpeechSeq2Seq Reconhecimento automático de fala (transcrição) Disponível em: qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/whisper-large/ Sussurro Sussurro openai/whisper-medium Modelo de áudio 1.20.4 QEFFAutoModelForSpeechSeq2Seq Reconhecimento automático de fala (transcrição) Disponível em: http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/whisper-medium/ Sussurro Sussurro openai/sussurro-pequeno Modelo de áudio 1.20.4 QEFFAutoModelForSpeechSeq2Seq Reconhecimento automático de fala (transcrição) Disponível em: http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/whisper-small/ Sussurro Sussurro openai-sussurro-minúsculo Modelo de áudio 1.20.4 QEFFAutoModelForSpeechSeq2Seq Reconhecimento automático de fala (transcrição) Disponível em: qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/whisper-tiny/ XLM-RoBERTa Modelo XLMRoberta intfloat/multilingue-e5-grande Modelo de incorporação 1.20.4 QEFFAutoModel Incorporação de texto Disponível em: http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.20.4/multilingual-e5-large/ XLM-RoBERTa Modelo XLMRoberta intfloat/multilingue-e5-pequeno Modelo de incorporação 1.19.6 QEFFAutoModel Incorporação de texto Disponível em: http:qualcom-qpc-models.s3-website-us-east-1.amazonaws.com/QPC/1.19.6/multilingual-e5-small/