OpenShift: El proceso de implementación del clúster falló debido a un estado incorrecto del pod estático.
Resumen: Un problema de OpenShift Container Platform que causa una falla en la implementación del clúster, el estado del pod estático cambió a completado.
Síntomas
Escenario 1: El proceso de configuración de la implementación del clúster falló con el error "No se pudo ejecutar el paso Esperar a que el plano de control de OCP esté listo"
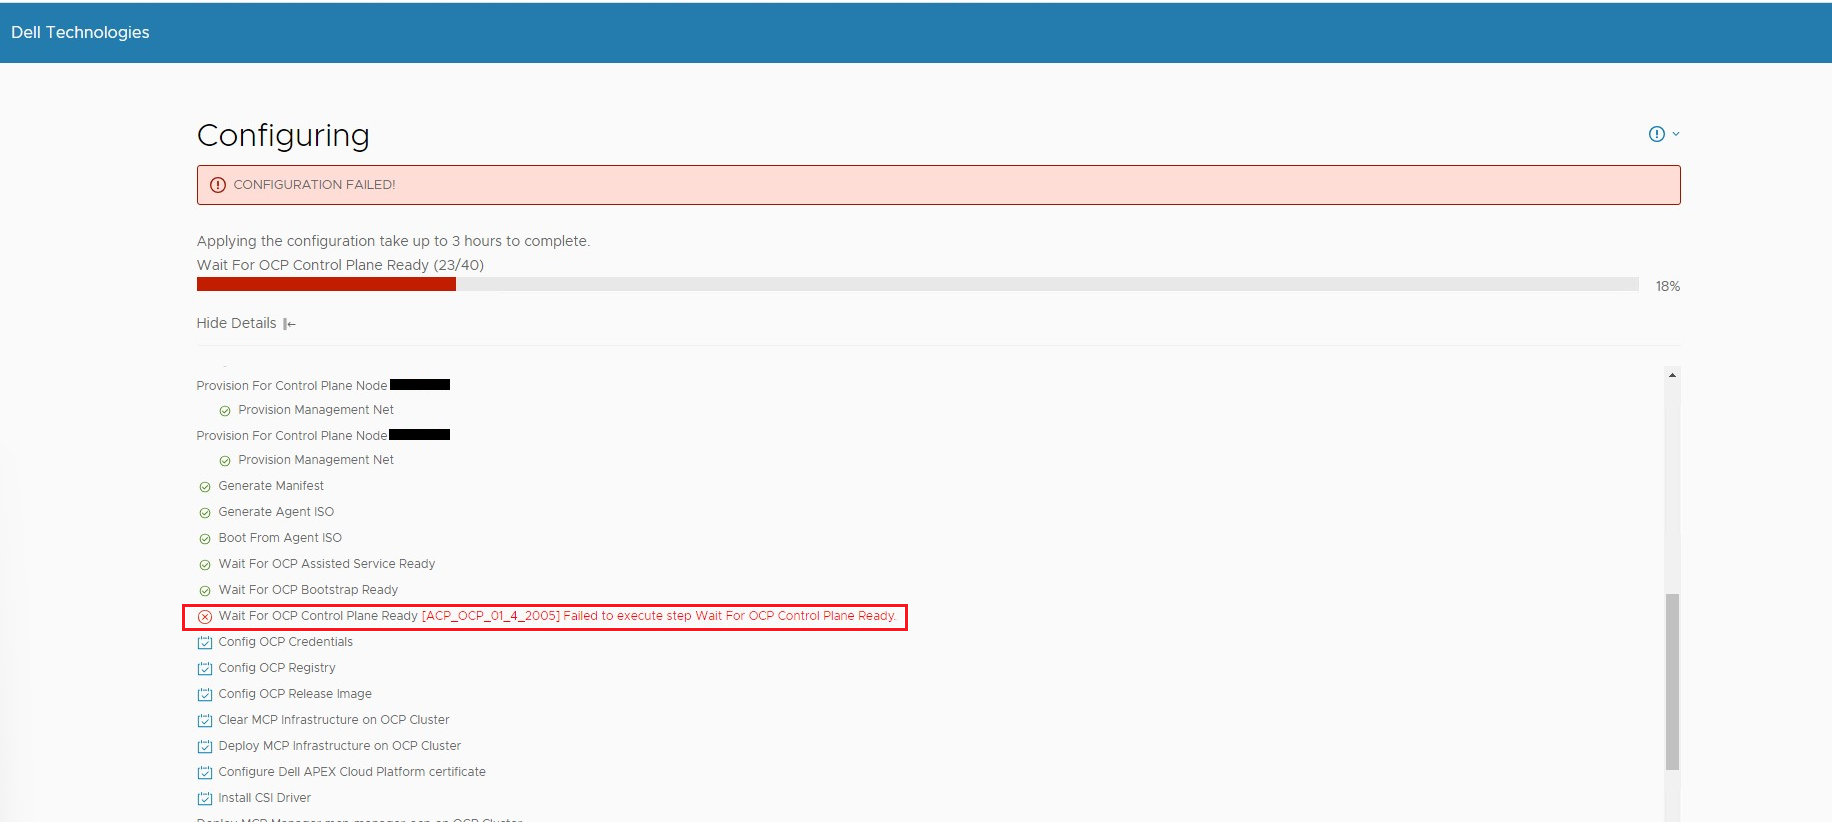
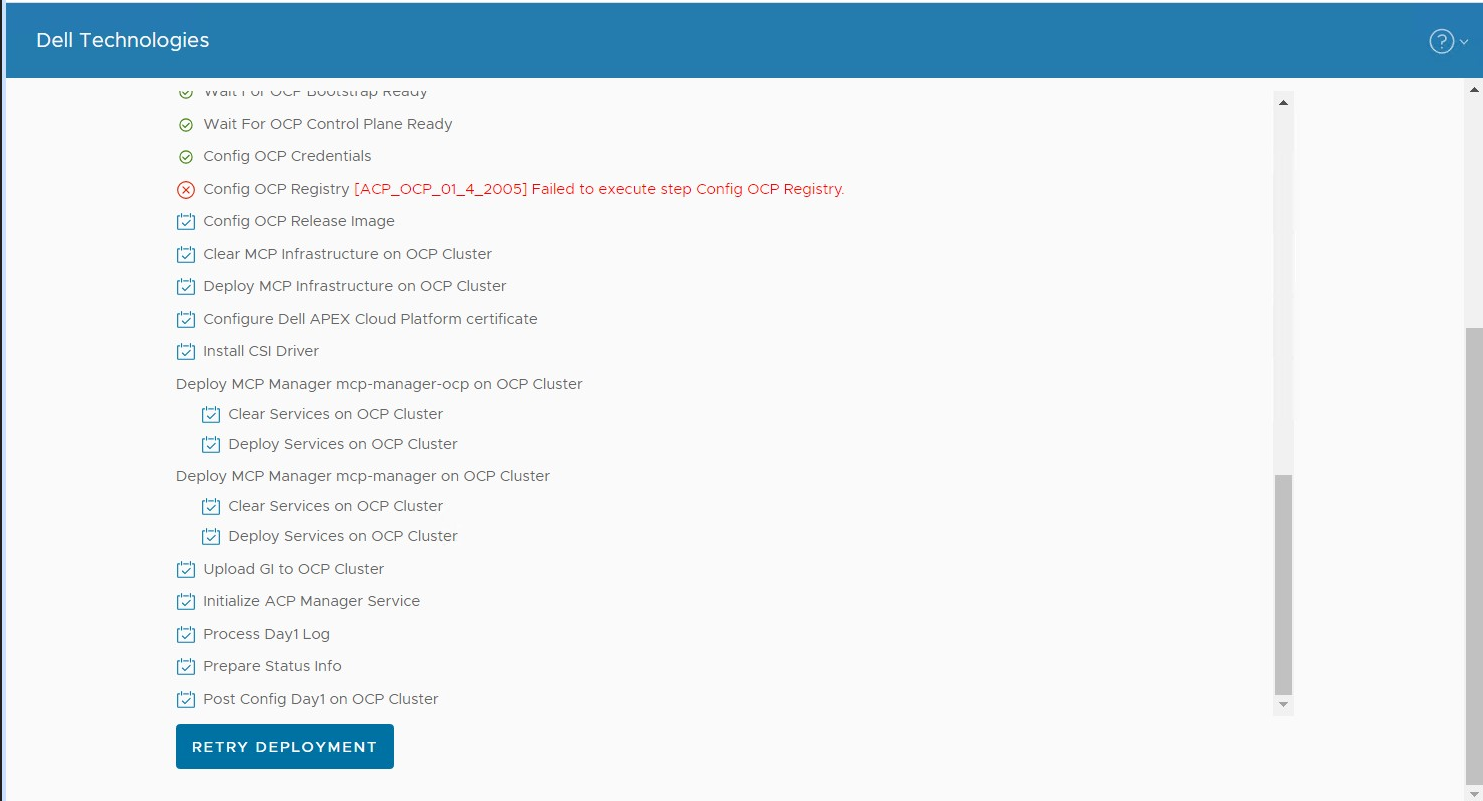
Situación 2: El proceso de configuración de implementación del clúster falló con el error "No se pudo ejecutar el paso Configuración del registro de OCP"
Inicie sesión en el nodo principal a través de SSH (la credencial predeterminada es root/Passw0rd!), ejecute los siguientes comandos para comprobar el estado de clusterversion, clusteroperator y static pods.
1. Ejecute el comando:kubectl --kubeconfig="/usr/share/mcp_ocp/pv/mcp-installer-ocp/auth/kubeconfig" get clusterversion
El comando devuelve "kube-scheduler is degraded", por ejemplo:
| VERSIÓN DEL NOMBRE DISPONIBLE PROGRESANDO DESDE LA VERSIÓN Falso
Falso 5h4m Error al conciliar 4.13.12: El operador del clúster kube-scheduler está degradado |
o devuelve "kube-controller-manager is degraded", por ejemplo:
| VERSIÓN DEL NOMBRE DISPONIBLE PROGRESANDO DESDE LA VERSIÓN DE ESTADO Falso
Falso 5h4m Error al conciliar 4.13.12: El operador del clúster kube-controller-manager está degradado |
2. Ejecute el comando:
kubectl --kubeconfig="/usr/share/mcp_ocp/pv/mcp-installer-ocp/auth/kubeconfig" get co
Toma kube-controller-manager está degradado, por ejemplo, el comando muestra que un kube-controller-manager está degradado con el mensaje "GuardControllerDegraded: Falta el operando en el nodo"
|
VERSIÓN DEL NOMBRE DISPONIBLE PROGRESIVAMENTE DEGRADADO DESDE EL MENSAJE ...... kube-controller-manager 4.13.12 Verdadero Verdadero Verdadero 4d7h GuardControllerDegradado: [Falta el operando en el nodo h01-01-compute-02.p82.local, Falta el operando en el nodo h01-01-compute-03.p82.local]... ...... machine-config 4.13.12 Verdadero Falso Verdadero 4d7h No se pudo resincronizar la versión 4.13.12 debido a un error durante syncRequiredMachineConfigPools: [Se agotó el tiempo de espera mientras se esperaba la condición, el maestro del grupo de errores no está listo, reintentándolo. Estado: (pool degradado: total verdadero: 3, listo 1, actualizado: 1, no disponible: 2)] |
3. Ejecute el comando:
kubectl --kubeconfig="/usr/share/mcp_ocp/pv/mcp-installer-ocp/auth/kubeconfig" get pods -A | grep kube-controller-manager
Toma kube-controller-manager está degradado, por ejemplo, el comando muestra que un kube-controller-manager es 0/1
|
NOMBRE LISTO ESTADO REINICIA LA EDAD installer-4-h01-01-compute-03.p82.local 0/1 Completado 0 4d7h installer-4-h01-01-compute-04.p82.local 0/1 Completado 0 4d7h installer-5-h01-01-compute-03.p82.local 0/1 Completado 0 4d7h installer-5-h01-01-compute-04.p82.local 0/1 Completado 0 4d7h installer-6-h01-01-compute-03.p82.local 0/1 Completado 0 4d7h kube-controller-manager-guard-h01-01-compute-03.p82.local 0/1 En ejecución 0 4d7h kube-controller-manager-guard-h01-01-compute-04.p82.local 1/1 en ejecución 0 4d7h kube-controller-manager-h01-01-compute-04.p82.local 4/4 en ejecución 0 4d7h |
Causa
La causa raíz es que Kubernetes no puede eliminar algunos pods y hace que algunos servicios se ejecuten en mal estado.
Resolución
Este problema se corregirá en futuras versiones de OCP.
Para la versión de OCP afectada, siga los pasos que se indican a continuación para solucionar el problema:
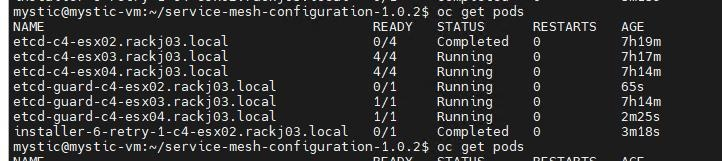
inicio de sesión SSH en el nodo identificado; en el ejemplo anterior, el nombre del nodo identificado es "c4-esx02.rackj03.local".
1. Guarde la clave privada correspondiente a la clave pública ssh que generó en la página web del asistente de implementación del clúster.
Ejecute el comando: ssh-keygen -t ecdsa -b 521
- Ingrese un nombre de archivo en el que desee guardar la clave o utilizar el valor predeterminado.
- Ingrese la frase de contraseña o utilice el valor predeterminado.
Su clave pública se guardó en /root/.ssh/id_ecdsa.pub
3. Ejecute el siguiente comando: sudo systemctl restart kubelet
4. Vuelva a intentar el proceso de implementación del clúster desde la página web del asistente