Codice evento Openshift: 1030NODO0001
Résumé: Un utilizzo elevato sostenuto della CPU su un singolo nodo del piano di controllo, una maggiore pressione della CPU potrebbe causare un failover. aumentare la CPU disponibile.
Cet article concerne
Cet article ne concerne pas
Cet article n’est associé à aucun produit spécifique.
Toutes les versions du produit ne sont pas identifiées dans cet article.
Symptômes
Una pressione eccessiva della CPU può causare una serializzazione lenta e prestazioni scadenti da kube-apiserver ed etcd. In questo caso, c è il rischio che i client vedano richieste API non reattive che vengono emesse di nuovo, causando una pressione ancora maggiore sulla CPU.
Può anche causare problemi alle sonde di liveness a causa della lenta reattività di etcd sul back-end. Se un kube-apiserver ha esito negativo in questa condizione, è probabile che si verifichi una cascata poiché anche i kube-apiserver rimanenti sono sottoposti a underprovisioning.
Può anche causare problemi alle sonde di liveness a causa della lenta reattività di etcd sul back-end. Se un kube-apiserver ha esito negativo in questa condizione, è probabile che si verifichi una cascata poiché anche i kube-apiserver rimanenti sono sottoposti a underprovisioning.
Cause
Questo avviso viene attivato in caso di utilizzo elevato sostenuto della CPU su un singolo nodo del piano di controllo.
L'urgenza di questo avviso è determinata dalla durata dell'utilizzo elevato della CPU da parte del nodo:
L'urgenza di questo avviso è determinata dal tempo per cui l'utilizzo della CPU in tutti e tre i nodi del piano di controllo è superiore a quello che possono sostenere due nodi del piano di controllo.
L'urgenza di questo avviso è determinata dalla durata dell'utilizzo elevato della CPU da parte del nodo:
- Critica
- quando l'utilizzo della CPU su un singolo nodo del piano di controllo è superiore al 90% per più di 1 ora.
- Warning
- Quando l'utilizzo della CPU su un singolo nodo del piano di controllo è superiore al 90% per più di 5 m.
L'urgenza di questo avviso è determinata dal tempo per cui l'utilizzo della CPU in tutti e tre i nodi del piano di controllo è superiore a quello che possono sostenere due nodi del piano di controllo.
- Warning
- Quando l'utilizzo della CPU in tutti e tre i nodi del piano di controllo è superiore a quello di due nodi del piano di controllo, può resistere per più di 10 m.
Résolution
Diagnosi:
Eseguire le seguenti query PromQL sulla console web OCP per facilitare la diagnosi (osservare le metriche → → eseguire le query).I primi 5 container con il maggiore utilizzo della CPU su un determinato nodo:
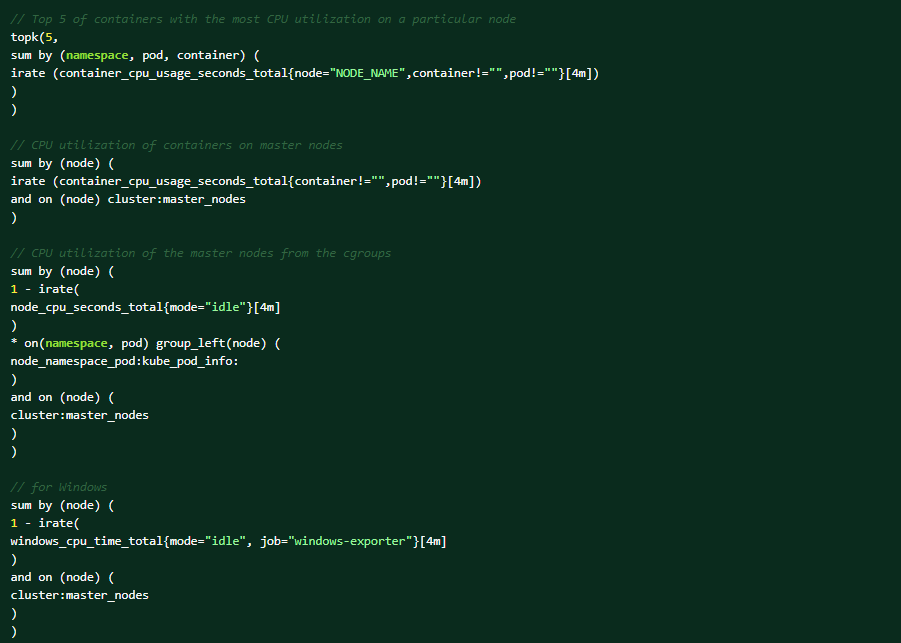
Queste sono le condizioni che potrebbero attivare l'avviso:
- È presente un nuovo carico di lavoro che genera più chiamate all'APIserver e causa un elevato utilizzo della CPU. In questo caso, aumentare la CPU e la memoria sui nodi del piano di controllo.
- l'avviso viene attivato in base alle metriche del nodo, pertanto potrebbe essere che un componente sul nodo stia causando un elevato utilizzo della CPU.
- APIService/ETCD sta elaborando più richieste a causa di tentativi del client causati da una condizione sottostante.
- distribuzione non uniforme delle richieste alle istanze dell'APIserver a causa di http2 (esegue il multiplexing delle richieste su una singola connessione TCP). I sistemi di bilanciamento del carico non sono a livello di applicazione e pertanto non comprendono http2.
Mitigazione:
- Se un carico di lavoro genera un carico sull'apiserver che causa un utilizzo elevato della CPU, aumentare la CPU e la memoria sui nodi del piano di controllo.
- Se l'elevato utilizzo elevato sostenuto della CPU è dovuto a una riduzione delle prestazioni del cluster:
- Individuare la root cause del danneggiamento e determinare di conseguenza i passaggi successivi.
Supporto:
Se quanto descritto sopra non risolve il problema, contattare il supporto tecnico Dell EMC per ulteriori indagini.
Informations supplémentaires
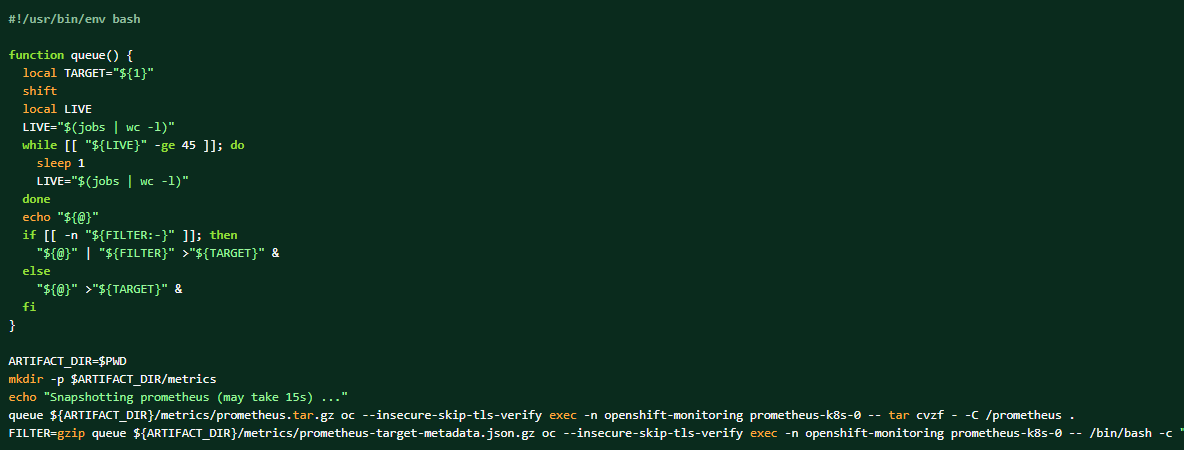
Se il pacchetto di log viene raccolto, i dati Prometheus possono anche essere scaricati come materiali complementari.
Come eseguire un dump dei dati Prometheus del cluster:
Produits concernés
APEX Cloud Platform for Red Hat OpenShiftPropriétés de l’article
Numéro d’article: 000217405
Type d’article: Solution
Dernière modification: 18 sept. 2026
Version: 4
Trouvez des réponses à vos questions auprès d’autres utilisateurs Dell
Services de support
Vérifiez si votre appareil est couvert par les services de support.