OpenShift-händelsekod: 1030NOD0001
Résumé: Ihållande hög CPU-användning på en enda kontrollplansnod kommer mer CPU-tryck sannolikt att orsaka en redundansväxling. öka tillgänglig CPU.
Cet article concerne
Cet article ne concerne pas
Cet article n’est associé à aucun produit spécifique.
Toutes les versions du produit ne sont pas identifiées dans cet article.
Symptômes
Extremt CPU-tryck kan orsaka långsam serialisering och dåliga prestanda från kube-apiserver och etcd. När detta inträffar finns det en risk för att klienter ser icke-responsiva API-begäranden som utfärdas igen, vilket orsakar ännu mer CPU-tryck.
Det kan också orsaka misslyckade liveness-avsökningar på grund av långsam etcd-svarstid på serverdelen. Om en kube-apiserver misslyckas under det här villkoret är risken stor att du får en kaskad eftersom de återstående kube-apiservers också är underetablerade.
Det kan också orsaka misslyckade liveness-avsökningar på grund av långsam etcd-svarstid på serverdelen. Om en kube-apiserver misslyckas under det här villkoret är risken stor att du får en kaskad eftersom de återstående kube-apiservers också är underetablerade.
Cause
Den här aviseringen utlöses när det finns en ihållande hög CPU-användning på en enda kontrollplansnod.
Hur brådskande den här aviseringen är bestäms av hur länge noden upprätthåller hög CPU-användning:
Hur brådskande den här aviseringen är bestäms av hur länge CPU-användningen för alla tre kontrollplansnoderna är högre än vad två kontrollplansnoder kan upprätthålla.
Hur brådskande den här aviseringen är bestäms av hur länge noden upprätthåller hög CPU-användning:
- Kritisk
- när CPU-användningen på en enskild kontrollplansnod är större än 90 % i mer än 1 timme.
- Varning
- när CPU-användningen på en enskild kontrollplansnod är större än 90 % i mer än 5 m.
Hur brådskande den här aviseringen är bestäms av hur länge CPU-användningen för alla tre kontrollplansnoderna är högre än vad två kontrollplansnoder kan upprätthålla.
- Varning
- när CPU-användningen för alla tre kontrollplansnoderna är högre än två kontrollplansnoder kan upprätthållas i mer än 10 m.
Résolution
Diagnos:
Kör följande PromQL-frågor på OCP-webbkonsolen för att få hjälp med diagnos (Observera → Metrics → Kör frågor).De 5 främsta containrarna med mest CPU-användning på en viss nod:
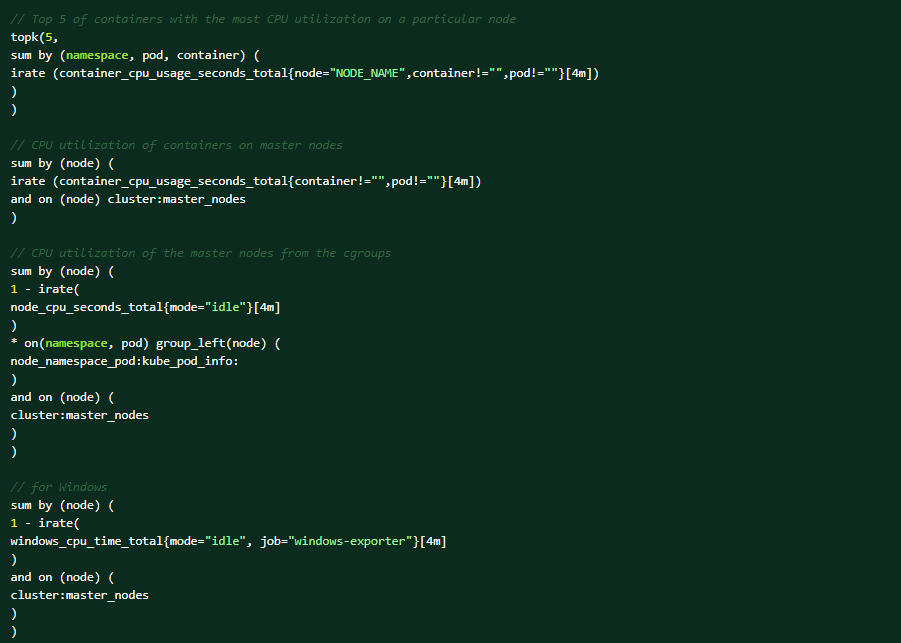
Det här är de villkor som kan utlösa aviseringen:
- det finns en ny arbetsbelastning som genererar fler anrop till apiserver och orsakar hög CPU-användning. I det här fallet ökar du processorn och minnet på kontrollplansnoderna.
- aviseringen utlöses baserat på nodmåtten, så det kan vara så att en komponent på noden orsakar den höga CPU-användningen.
- apiserver/etcd bearbetar fler begäranden på grund av klientåterförsök som orsakas av ett underliggande villkor.
- ojämn fördelning av begäranden till apiserver-instanserna på grund av http2 (den multiplexerar begäranden över en enda TCP-anslutning). Lastbalanserarna finns inte på programnivån och förstår därför inte http2.
Lindring:
- Om en arbetsbelastning genererar belastning till apiserver som orsakar hög CPU-användning ökar du processorn och minnet på kontrollplansnoderna.
- Om den ihållande höga CPU-användningen beror på en klusterförsämring:
- Ta reda på grundorsaken till försämringen och bestäm sedan nästa steg därefter.
Support:
Om inget av stegen ovan kan lösa problemet kontaktar du Dell EMC:s tekniska support för vidare undersökning.
Informations supplémentaires
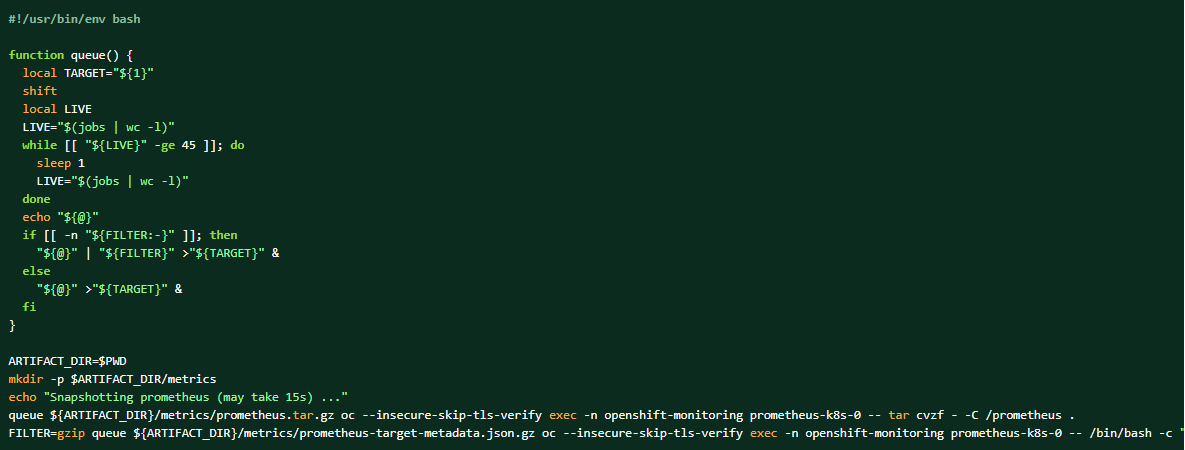
Om loggpaketet samlas in kan Prometheus-data också dumpas som kompletterande material.
Så här tar du en dump av klustrets prometheus-data:
Produits concernés
APEX Cloud Platform for Red Hat OpenShiftPropriétés de l’article
Numéro d’article: 000217405
Type d’article: Solution
Dernière modification: 18 sept. 2026
Version: 4
Trouvez des réponses à vos questions auprès d’autres utilisateurs Dell
Services de support
Vérifiez si votre appareil est couvert par les services de support.