Código de evento de OpenShift: 1030NODO0001
Résumé: Utilización alta sostenida de la CPU en un solo nodo del plano de control, es probable que una mayor presión de la CPU provoque una conmutación por error; aumentar la CPU disponible.
Cet article concerne
Cet article ne concerne pas
Cet article n’est associé à aucun produit spécifique.
Toutes les versions du produit ne sont pas identifiées dans cet article.
Symptômes
La presión extrema de la CPU puede causar una serialización lenta y un rendimiento deficiente de kube-apiserver y etcd. Cuando esto sucede, existe el riesgo de que los clientes vean solicitudes de API que no responden y se vuelven a emitir, lo que causa aún más presión en la CPU.
También puede causar fallas en los sondeos de ejecución debido a la lentitud de la capacidad de respuesta de etcd en el back-end. Si un kube-apiserver falla en esta condición, es probable que experimente una cascada, ya que los kube-apiservers restantes también están infraaprovisionados.
También puede causar fallas en los sondeos de ejecución debido a la lentitud de la capacidad de respuesta de etcd en el back-end. Si un kube-apiserver falla en esta condición, es probable que experimente una cascada, ya que los kube-apiservers restantes también están infraaprovisionados.
Cause
Esta alerta se activa cuando hay una utilización alta sostenida de la CPU en un solo nodo del plano de control.
La urgencia de esta alerta está determinada por el tiempo que el nodo mantiene un alto uso de CPU:
La urgencia de esta alerta se determina por el tiempo que la utilización de CPU en los tres nodos del plano de control es mayor que la que pueden soportar dos nodos del plano de control.
La urgencia de esta alerta está determinada por el tiempo que el nodo mantiene un alto uso de CPU:
- Crítica
- cuando el uso de CPU en un nodo de plano de control individual es superior al 90 % durante más de 1 h.
- Advertencia
- cuando el uso de CPU en un nodo de plano de control individual es superior al 90 % durante más de 5 meses.
La urgencia de esta alerta se determina por el tiempo que la utilización de CPU en los tres nodos del plano de control es mayor que la que pueden soportar dos nodos del plano de control.
- Advertencia
- cuando la utilización de CPU en los tres nodos del plano de control es mayor que la que dos nodos del plano de control pueden sostener durante más de 10 m.
Résolution
Diagnóstico:
Ejecute las siguientes consultas de PromQL en la consola web de OCP para obtener ayuda con el diagnóstico (Observe las métricas de → → ejecute consultas).Los 5 principales contenedores con la mayor utilización de CPU en un nodo en particular:
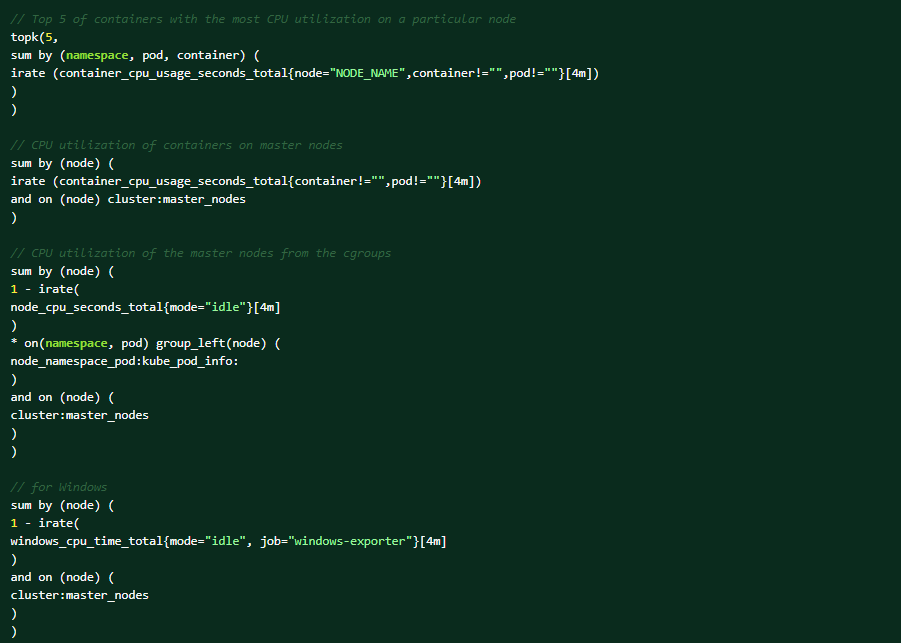
Estas son las condiciones que podrían activar la alerta:
- Hay una nueva carga de trabajo que genera más llamadas al servidor API y causa un alto uso de la CPU. En este caso, aumente la CPU y la memoria en los nodos del plano de control.
- la alerta se activa en función de las métricas del nodo, por lo que podría ser que un componente en el nodo esté causando el alto uso de CPU.
- apiserver/etcd está procesando más solicitudes debido a reintentos del cliente causados por una condición subyacente.
- Distribución desigual de las solicitudes a la(s) instancia(s) de apiserver debido a http2 (multiplexa las solicitudes a través de una única conexión TCP). Los balanceadores de carga no están en el nivel de la aplicación y, por lo tanto, no entienden http2.
Mitigación:
- Si una carga de trabajo genera una carga en el servidor API que provoca un alto uso de la CPU, aumente la CPU y la memoria en los nodos del plano de control.
- Si el alto uso sostenido de la CPU se debe a una degradación del clúster:
- Averigüe la causa raíz de la degradación y, a continuación, determine los próximos pasos en consecuencia.
Soporte:
Si todos los pasos anteriores no pueden resolver el problema, póngase en contacto con el soporte técnico de Dell EMC para una investigación más detallada.
Informations supplémentaires
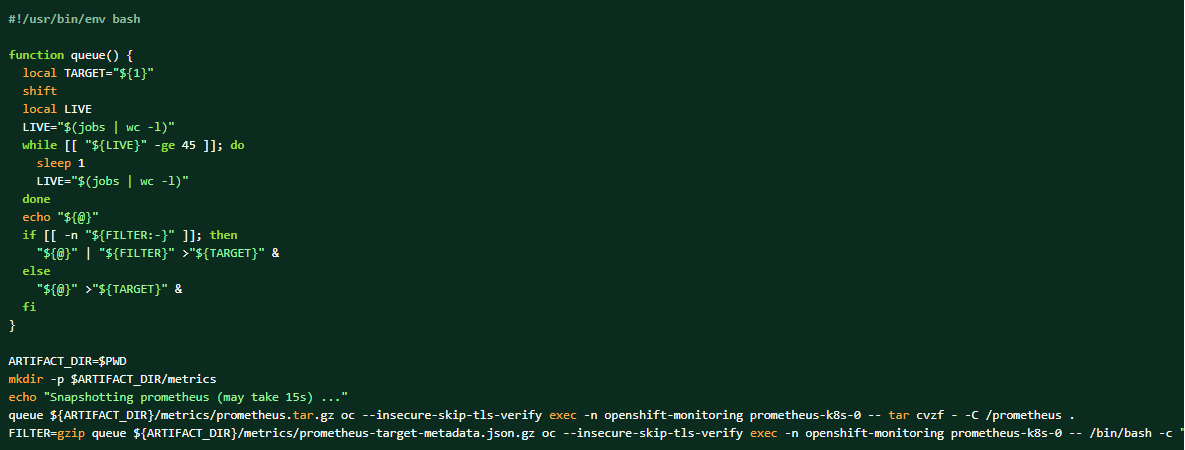
Si se recolecta el paquete de registros, los datos de Prometheus también se pueden volcar como materiales complementarios.
Cómo realizar un volcado de los datos del clúster de Prometheus:
Produits concernés
APEX Cloud Platform for Red Hat OpenShiftPropriétés de l’article
Numéro d’article: 000217405
Type d’article: Solution
Dernière modification: 18 sept. 2026
Version: 4
Trouvez des réponses à vos questions auprès d’autres utilisateurs Dell
Services de support
Vérifiez si votre appareil est couvert par les services de support.