OpenShift: Het clusterimplementatieproces is mislukt vanwege een ongezonde statische podstatus.
Samenvatting: Een probleem met het OpenShift Container Platform dat een fout veroorzaakt bij de implementatie van het cluster, de status van de statische pod wordt gewijzigd in voltooid.
Dit artikel is van toepassing op
Dit artikel is niet van toepassing op
Dit artikel is niet gebonden aan een specifiek product.
Niet alle productversies worden in dit artikel vermeld.
Symptomen
Er kunnen verschillende fouten worden waargenomen tijdens het implementatieproces van het cluster, inclusief maar niet beperkt tot de volgende scenario's:
Scenario 1: Configuratieproces clusterimplementatie mislukt met foutmelding "Kan stap Wachten tot OCP Control Plane gereed is"
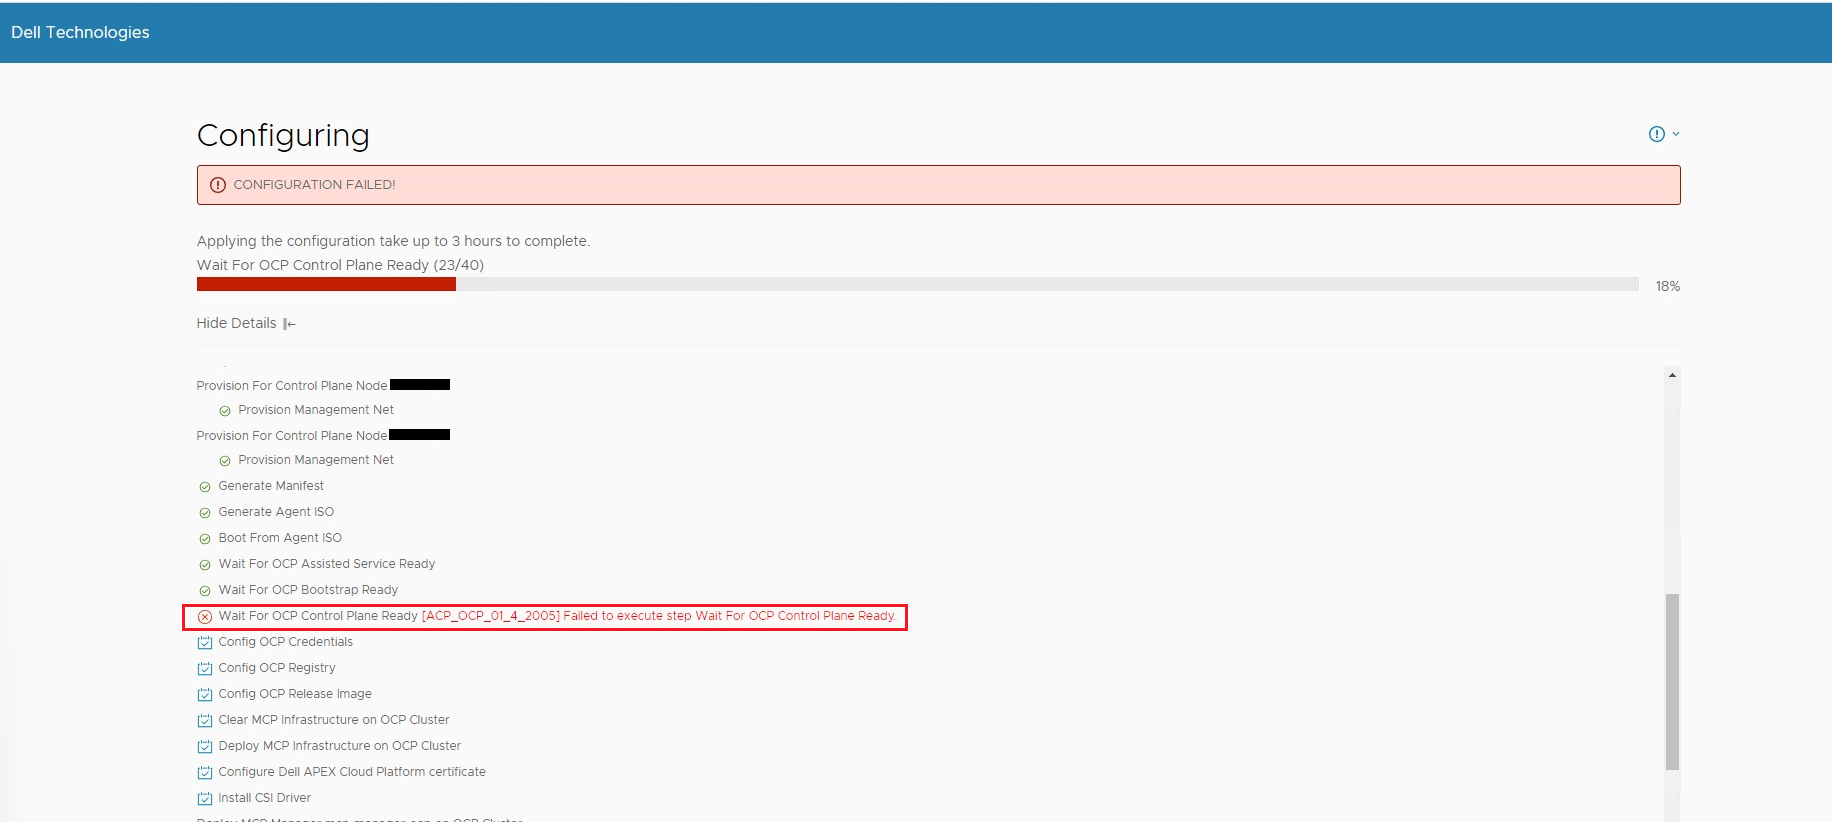
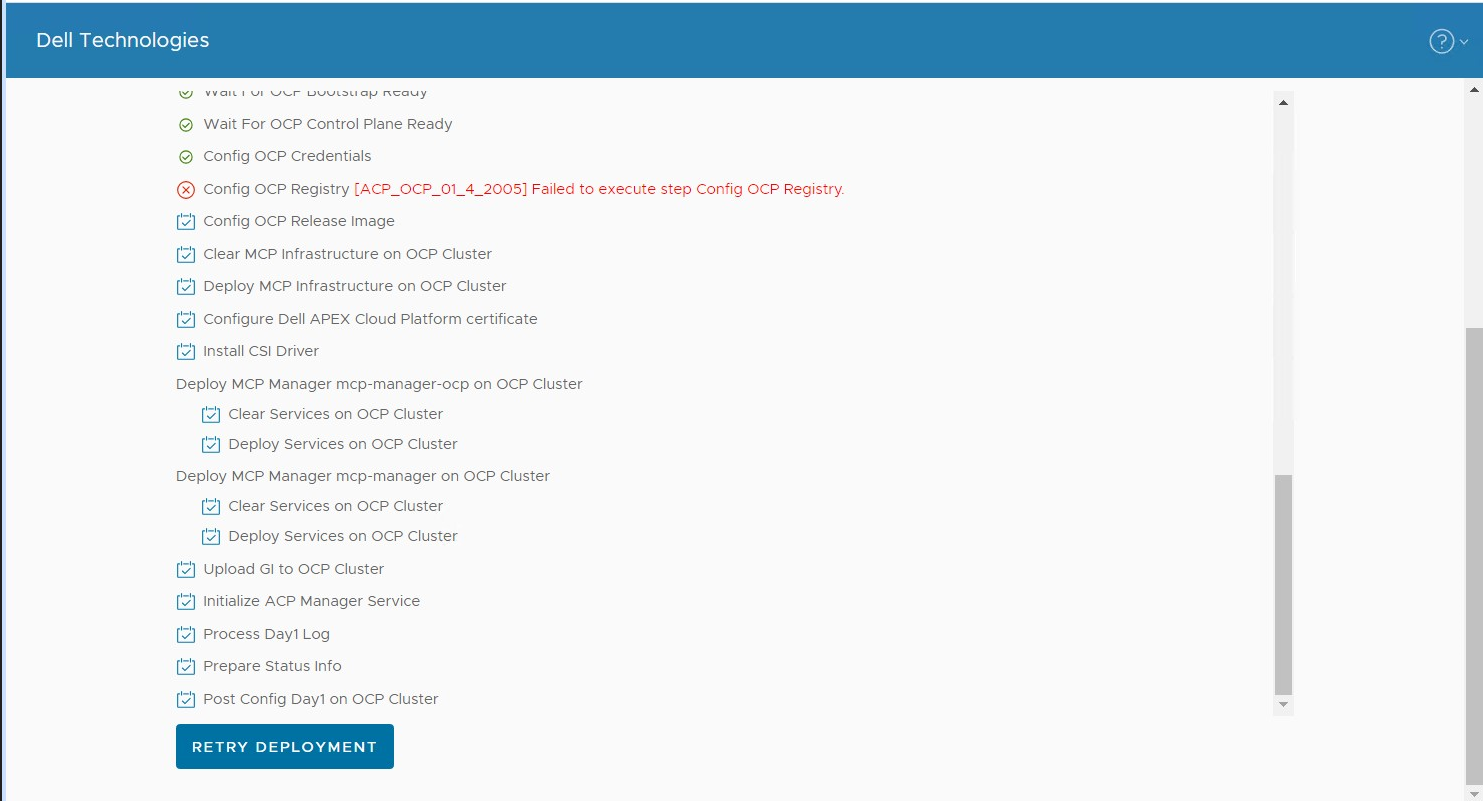
Scenario 2: Configuratieproces voor clusterimplementatie mislukt met foutmelding "Kan stap Config OCP-register niet uitvoeren"
De opdracht retourneert "kube-scheduler is degraded", bijvoorbeeld:
Of het retourneert "kube-controller-manager is degraded", bijvoorbeeld:
2. Voer deze opdracht uit:
Takes kube-controller-manager is degraded, de opdracht shows one kube-controller-manager is degraded met het bericht "GuardControllerDegraded: Ontbrekende operand op knooppunt"
Scenario 1: Configuratieproces clusterimplementatie mislukt met foutmelding "Kan stap Wachten tot OCP Control Plane gereed is"
Scenario 2: Configuratieproces voor clusterimplementatie mislukt met foutmelding "Kan stap Config OCP-register niet uitvoeren"
Meld u aan bij het primaire knooppunt via SSH (standaardreferentie is root/Passw0rd!), voer onderstaande opdrachten uit om de status van clusterversion, clusteroperator en statische pods te controleren.
1. Voer deze opdracht uit:kubectl --kubeconfig="/usr/share/mcp_ocp/pv/mcp-installer-ocp/auth/kubeconfig" get clusterversion
De opdracht retourneert "kube-scheduler is degraded", bijvoorbeeld:
| NAAM VERSIE BESCHIKBAAR PROGRESSIE SINDS STATUS Versie
False False 5h4m Fout bij het afstemmen 4.13.12: De clusteroperator kube-scheduler is gedegradeerd |
Of het retourneert "kube-controller-manager is degraded", bijvoorbeeld:
| NAAM VERSIE BESCHIKBAAR PROGRESSIEF SINDS STATUS Versie
Onwaar Onwaar 5h4m Fout bij het afstemmen 4.13.12: de clusteroperator kube-controller-manager is verslechterd |
2. Voer deze opdracht uit:
kubectl --kubeconfig="/usr/share/mcp_ocp/pv/mcp-installer-ocp/auth/kubeconfig" get co
Takes kube-controller-manager is degraded, de opdracht shows one kube-controller-manager is degraded met het bericht "GuardControllerDegraded: Ontbrekende operand op knooppunt"
|
NAAM, VERSIE BESCHIKBAAR, PROGRESS, VERSLECHTERD SINDS BERICHT ...... kube-controller-manager 4.13.12 True True True 4d7h GuardControllerDegraded: [Ontbrekende operand op knooppunt h01-01-compute-02.p82.local, ontbrekende operand op knooppunt h01-01-compute-03.p82.local]... ...... machine-config 4.13.12 True False True 4d7h Kan 4.13.12 niet opnieuw synchroniseren omdat: error during syncRequiredMachineConfigPools: [Time-out bij wachten op de conditie, fout Pool Master is niet gereed, opnieuw proberen. Status: (pool degraded: true total: 3, gereed 1, bijgewerkt: 1, niet beschikbaar: 2)] |
3. Voer deze opdracht uit:
kubectl --kubeconfig="/usr/share/mcp_ocp/pv/mcp-installer-ocp/auth/kubeconfig" get pods -A | grep kube-controller-manager
Takes kube-controller-manager is degraded, bijvoorbeeld, de opdracht shows one kube-controller-manager is 0/1
|
NAAM GEREED STATUS START LEEFTIJD OPNIEUW OP installer-4-h01-01-compute-03.p82.local 0/1 voltooid 0 4d7h installer-4-h01-01-compute-04.p82.local 0/1 Voltooid 0 4d7h installer-5-h01-01-compute-03.p82.local 0/1 Voltooid 0 4d7h installer-5-h01-01-compute-04.p82.local 0/1 voltooid 0 4d7h installer-6-h01-01-compute-03.p82.local 0/1 Voltooid 0 4d7h kube-controller-manager-guard-h01-01-compute-03.p82.local 0/1 Hardlopen 0 4d7h kube-controller-manager-guard-h01-01-compute-04.p82.local 1/1 uitvoeren 0 4d7h kube-controller-manager-h01-01-compute-04.p82.local 4/4 Running 0 4d7h |
Oorzaak
Dit is een bekend probleem van OCP 4.10, 4.11, 4.12 en 4.13.
De hoofdoorzaak is dat de Kubernetes sommige pods niet verwijdert en dat sommige services niet goed werken.
De hoofdoorzaak is dat de Kubernetes sommige pods niet verwijdert en dat sommige services niet goed werken.
Oplossing
Dit probleem wordt opgelost in toekomstige OCP-versies.
Voor de getroffen OCP-versie volgt u de onderstaande stappen om het probleem te omzeilen:
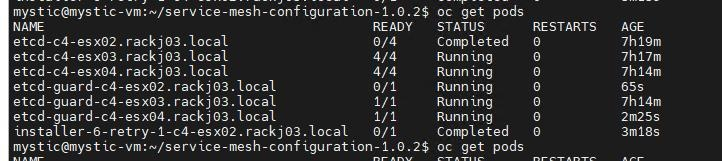
SSH-aanmelding bij het geïdentificeerde knooppunt, in bovenstaand voorbeeld is de geïdentificeerde knooppuntnaam "c4-esx02.rackj03.local".
1. Sla de persoonlijke sleutel op die overeenkomt met de openbare ssh-sleutel die u hebt gegenereerd op de webpagina van de wizard Clusterdeploy.
Bijvoorbeeld:
Run command: ssh-keygen -t ecdsa -b 521
Run command: ssh-keygen -t ecdsa -b 521
- Voer een bestandsnaam in waarvan u de sleutel wilt opslaan of met behulp van de standaardwaarde.
- Voer de wachtwoordzin in of gebruik de standaardwaarde.
De uitvoer van de opdracht is als volgt:
Uw identificatie is opgeslagen in /root/.ssh/id_ecdsa
Uw publieke sleutel is opgeslagen in /root/.ssh/id_ecdsa.pub
Uw publieke sleutel is opgeslagen in /root/.ssh/id_ecdsa.pub
In dit voorbeeld is "/root/.ssh/id_ecdsa" het persoonlijke sleutelbestand. Het bestand wordt gebruikt in de volgende opdracht.
2. Voer de volgende opdracht uit: ssh -l core <node name> -i <private_key_file>
3. Voer opdracht uit: sudo systemctl restart kubelet
4. Probeer het clusterimplementatieproces opnieuw uit te voeren vanaf de webpagina van de wizard
Getroffen producten
APEX Cloud Platform for Red Hat OpenShiftArtikeleigenschappen
Artikelnummer: 000218328
Artikeltype: Solution
Laatst aangepast: 18 sep. 2026
Versie: 5
Vind antwoorden op uw vragen via andere Dell gebruikers
Support Services
Controleer of uw apparaat wordt gedekt door Support Services.