OpenShift OCP-opgradering efter kontrolfejl for node ikke klar eller planlægning deaktiveret
Summary: OCP-opgradering efter kontrolfejl for node, der ikke er klar, eller planlægning deaktiveret på grund af VM konfigureret med ReadWriteOnce(RWO)-lagerdiskenhed, der ikke kan overføres live. ...
This article applies to
This article does not apply to
This article is not tied to any specific product.
Not all product versions are identified in this article.
Symptoms
Under processen med efterkontrol af OCP-opgradering kan der være en fejlmeddelelse, der siger "Kunne ikke køre postkontrol for OCP-klynge. Noden er ikke klar, eller planlægningen er deaktiveret."
Cause
En eller flere VM er, der er konfigureret med ReadWriteOnce(RWO)-lagerdiskenhed, som ikke kan overføres live på fejlrapporteringsnoden.
Se nedenfor Openshift-dokument for at få flere oplysninger om lagerdiskenheder til virtuelle maskiner.
Resolution
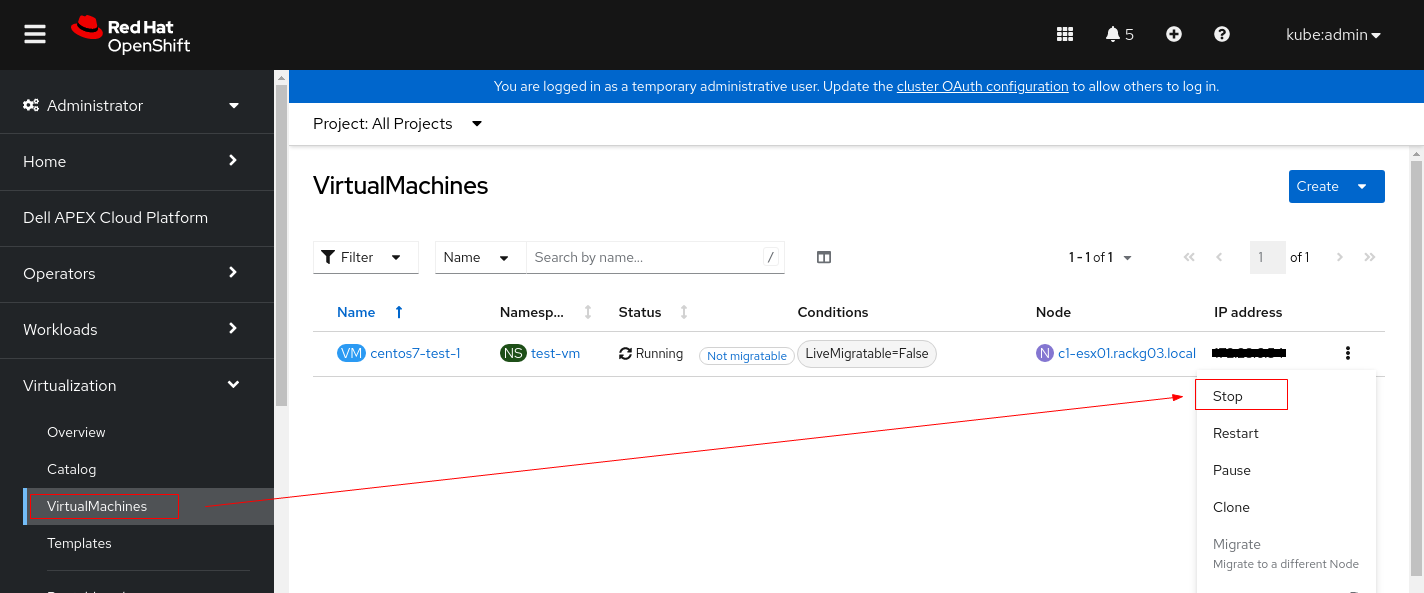
1. Skift indstillingerne for VM PV.
2. Find de noder, hvis status er "Klar,PlanlægningDeaktiveret".
3. Tøm noden for at fjerne løbende pods fra den.
4. Indstil fejlretningstilstand, og genstart noden.
5. Når noden er klar efter genstart, skal du markere den som planlagt.
6. Bekræft, at noden er markeret som planlagt korrekt.
- 1.1stop VM-forekomsten, før du ændrer dens PV-indstillinger.
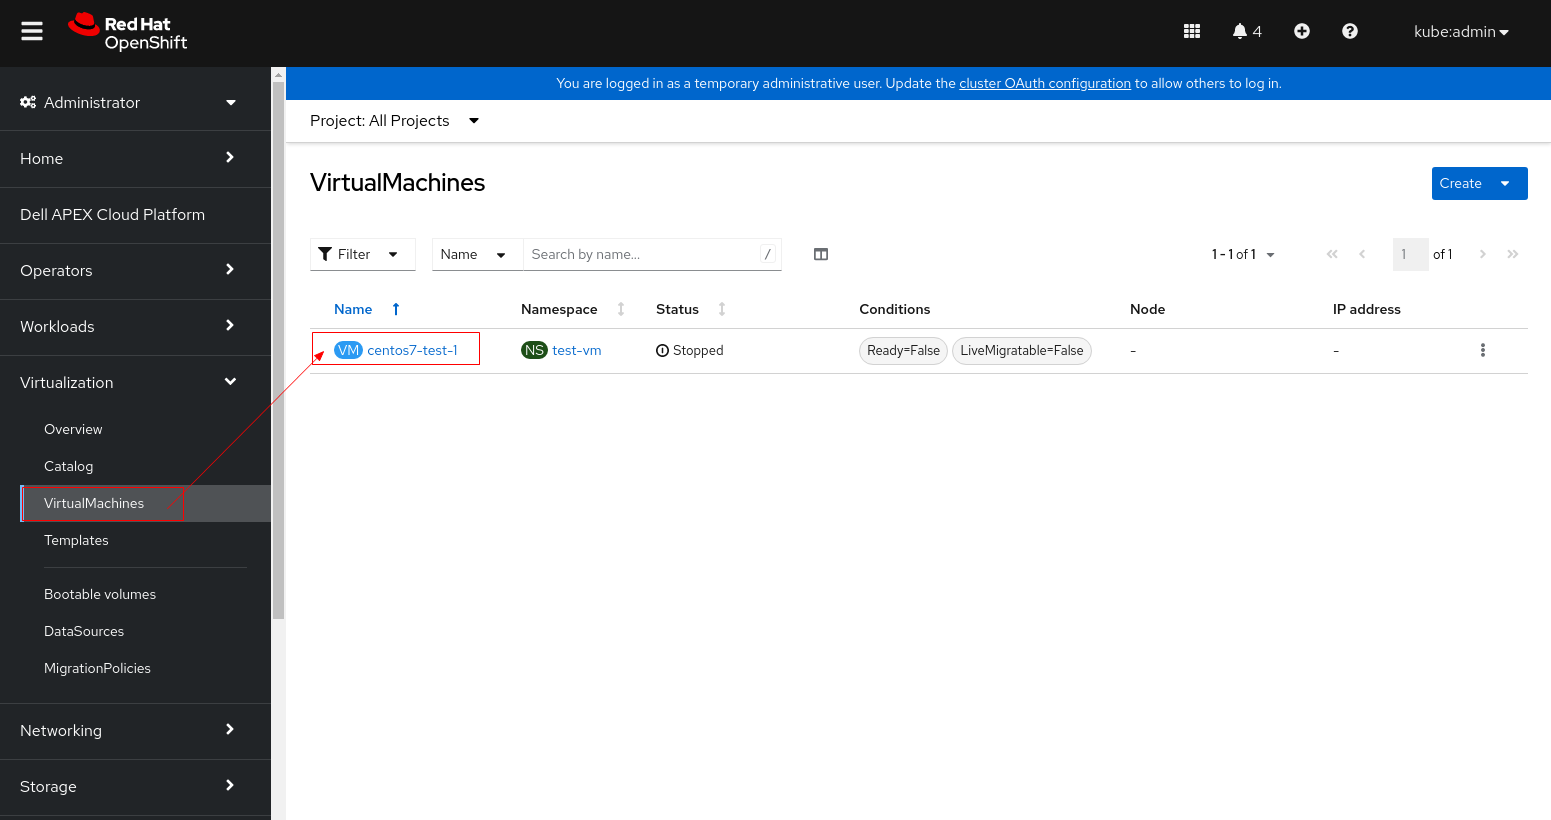
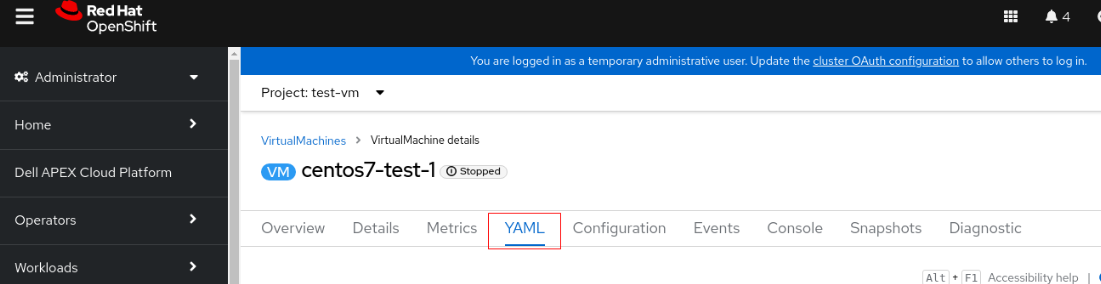
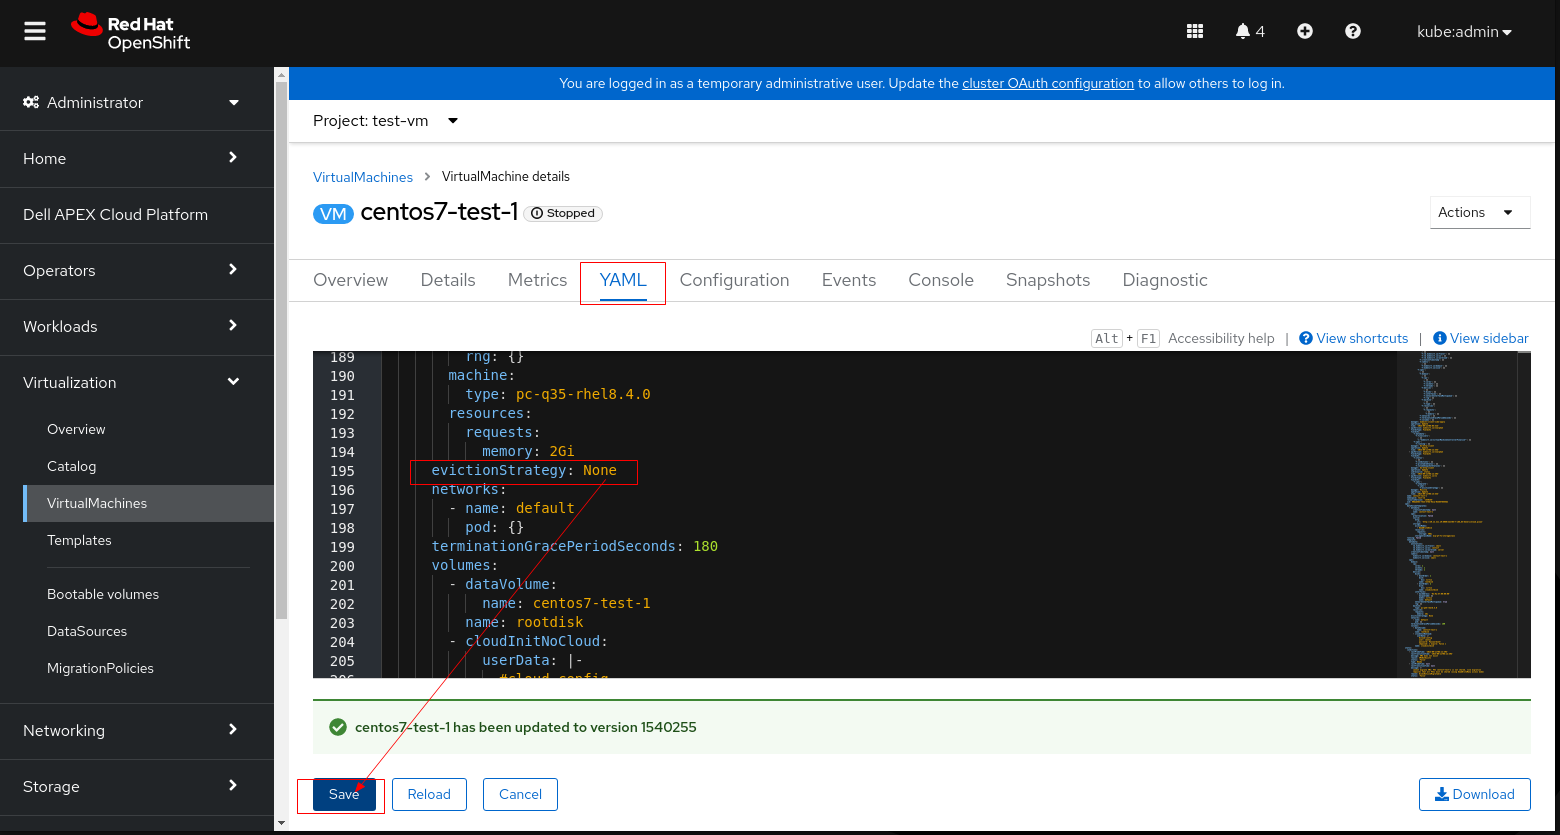
- 1.2 Klik på VM, og skift til fanen YAML
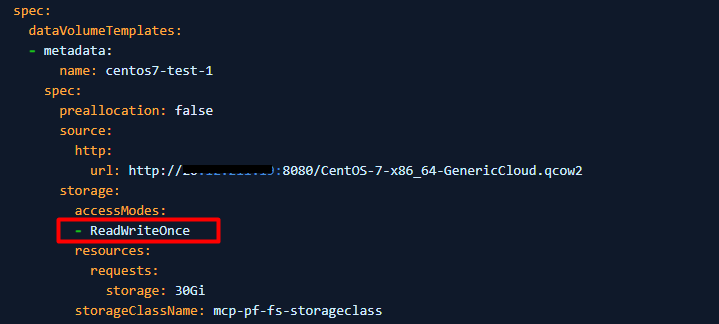
- 1.3 Skift accessModes fra "ReadWriteOnce" til "ReadWriteMany"
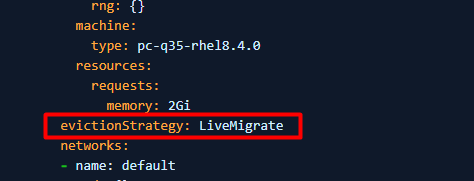
- 1.4 Hvis PV ikke kan indstilles til ReadWriteMany (VM'en kan ikke begynde at bruge ReadWriteMany), skal du indstille fjernelsesstrategi fra LiveMigrate til Ingen
Bemærk: Udfør enten trin 1.3 eller 1.4, der gælder for dit miljø. Du behøver ikke at udføre begge trin.
- 1.5 Klik på Gem og genstart VM'en.
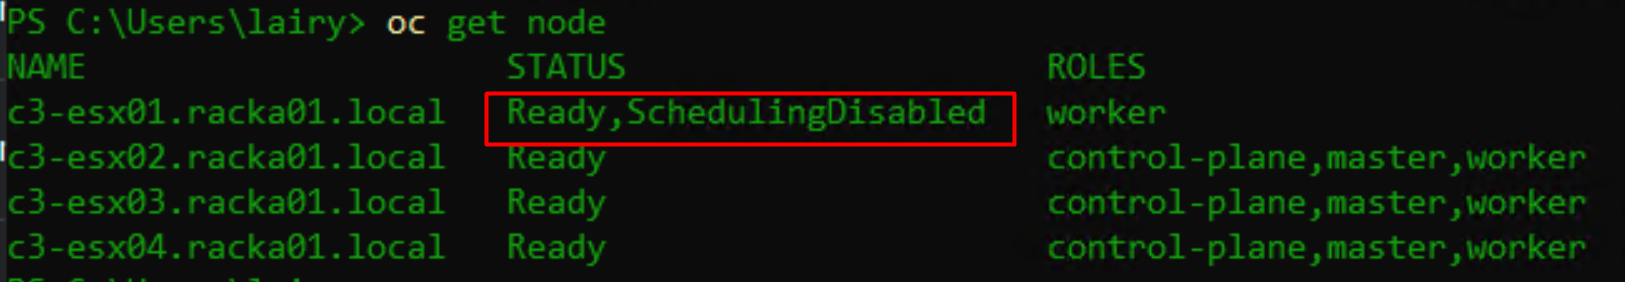
2. Find de noder, hvis status er "Klar,PlanlægningDeaktiveret".
$ oc get nodeFor eksempel:
3. Tøm noden for at fjerne løbende pods fra den.
$ oc adm <node name> --ignore-daemonsets --delete-emptydir-data --forceFor eksempel: oc adm dræn c3-esx01.racka01.local --ignore-daemonsets --delete-emptydir-data --force
4. Indstil fejlretningstilstand, og genstart noden.
$ oc debug node/<node name>

$ sh-4.4# chroot /host

$ sh-4.4# systemctl reboot
5. Når noden er klar efter genstart, skal du markere den som planlagt.
$ oc adm uncordon <node name>
6. Bekræft, at noden er markeret som planlagt korrekt.
$ oc get node
Affected Products
APEX Cloud Platform for Red Hat OpenShiftArticle Properties
Article Number: 000216593
Article Type: Solution
Last Modified: 18 Sept 2026
Version: 4
Find answers to your questions from other Dell users
Support Services
Check if your device is covered by Support Services.