Turno abierto: Error de verificación posterior a la actualización de OCP por nodo no listo o programación deshabilitada
Summary: Error de verificación posterior a la actualización de OCP porque el nodo no está listo o la programación está deshabilitada debido a una VM configurada con el volumen de almacenamiento ReadWriteOnce (RWO) que no se puede migrar en vivo. ...
This article applies to
This article does not apply to
This article is not tied to any specific product.
Not all product versions are identified in this article.
Symptoms
Durante el proceso de verificación posterior a la actualización de OCP, podría haber un mensaje de error que diga "No se pudo ejecutar la verificación posterior para el clúster de OCP. El nodo no está listo o la programación está deshabilitada".
Cause
Una o más VM configuradas con el volumen de almacenamiento ReadWriteOnce (RWO) que no se pueden migrar en vivo en el nodo de generación de informes de errores.
Consulte el siguiente documento de Openshift para obtener más información sobre los volúmenes de almacenamiento para discos de máquinas virtuales.
Resolution
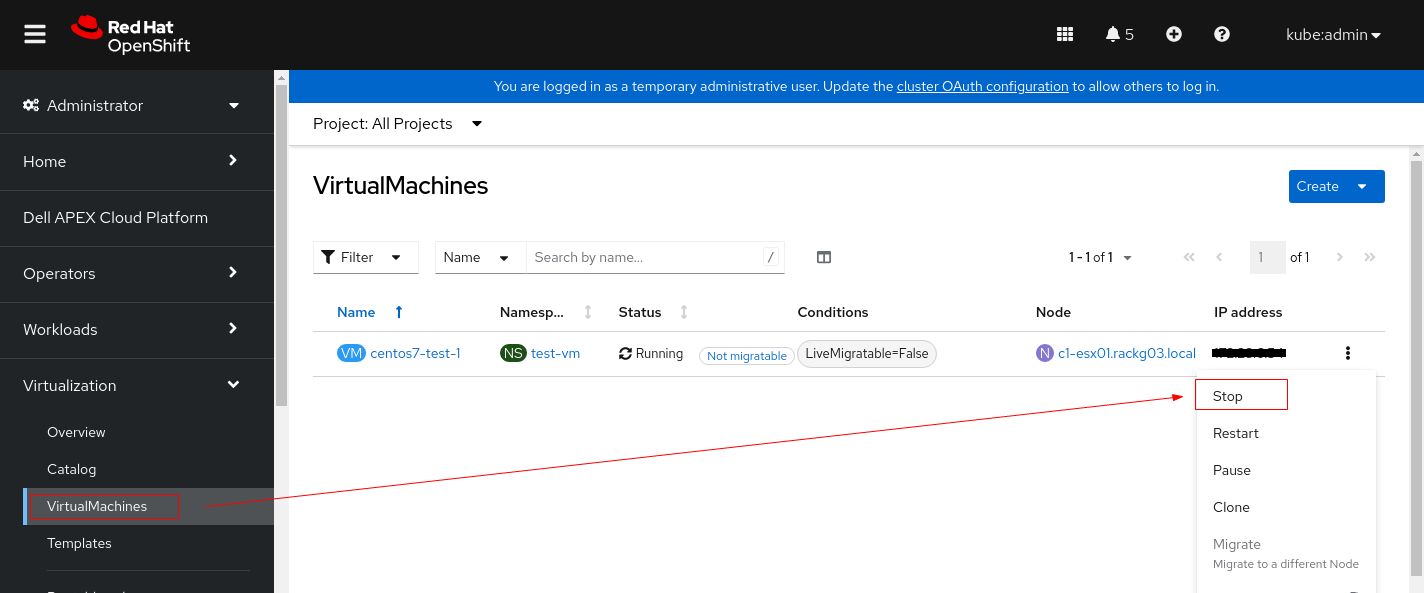
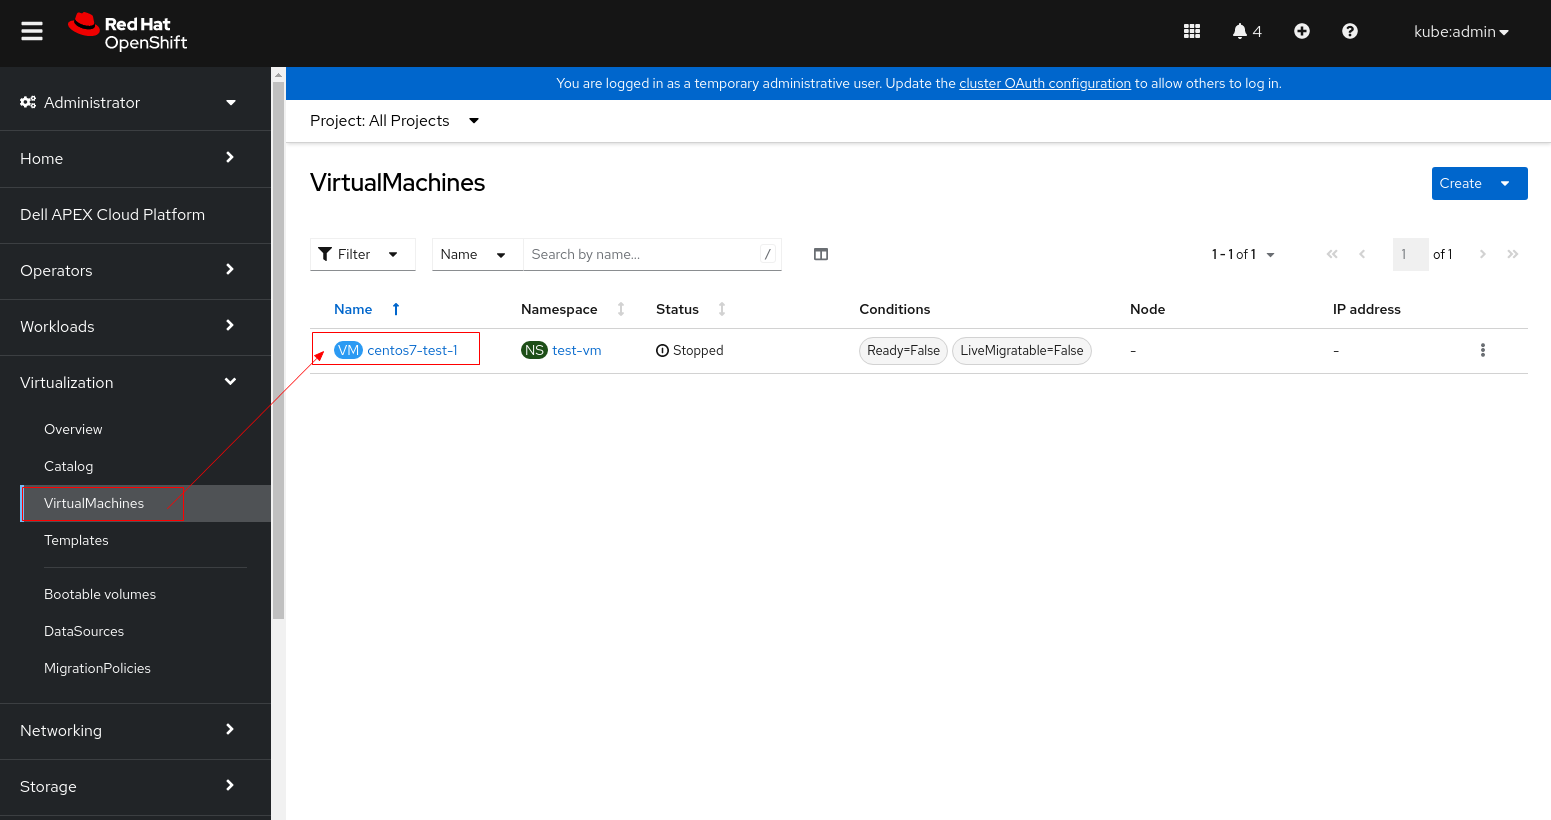
1. Cambie los ajustes de PV de VM.
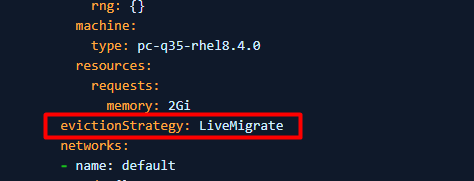
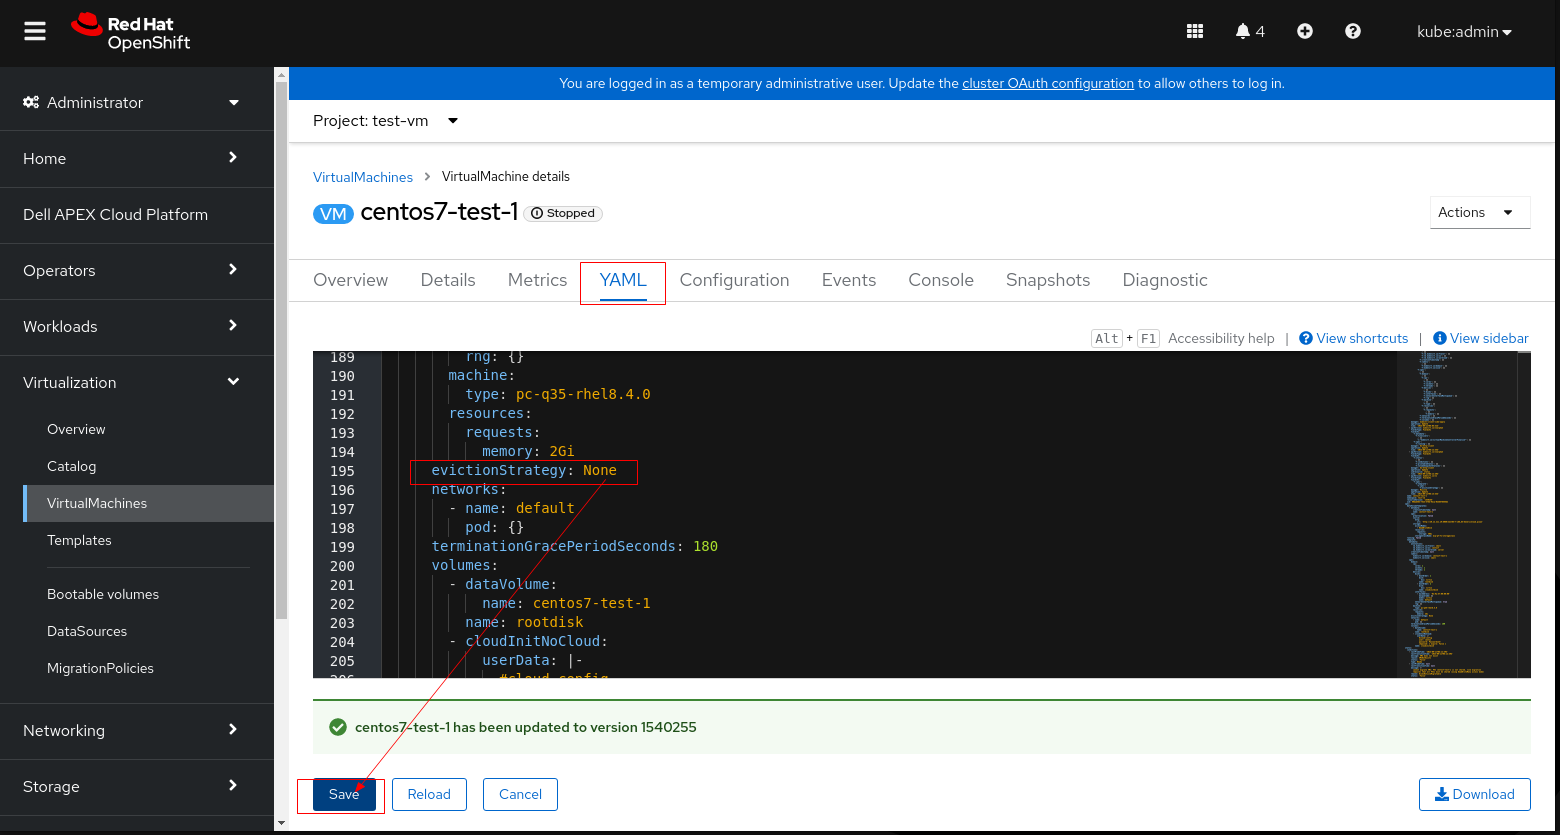
2. Busque los nodos cuyo estado sea "Ready,SchedulingDisabled".
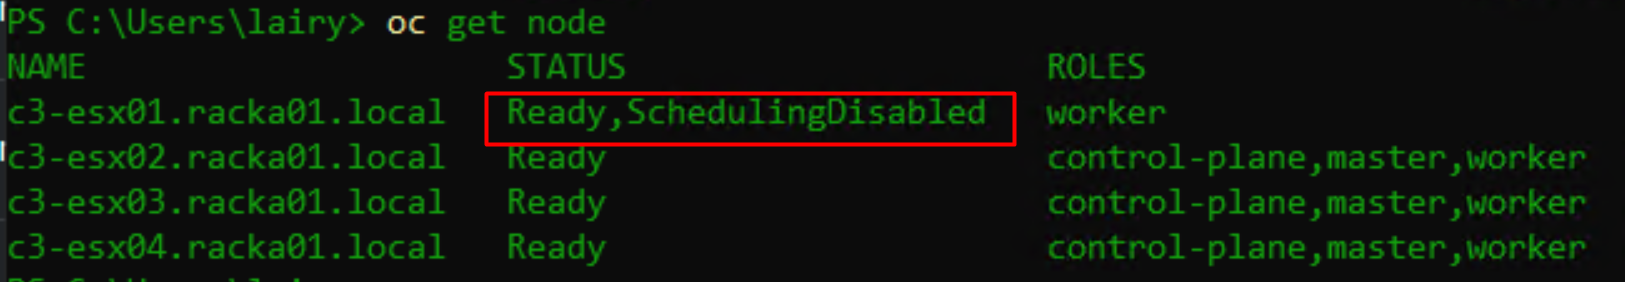
3. Drene el nodo para eliminar los pods en ejecución.
4. Configure el modo de depuración y reinicie el nodo.
5. Una vez que el nodo esté listo después del reinicio, márquelo como programable.
6. Verifique que el nodo se haya marcado correctamente como programable.
- 1.1 Detenga la instancia de VM antes de cambiar su configuración de PV.
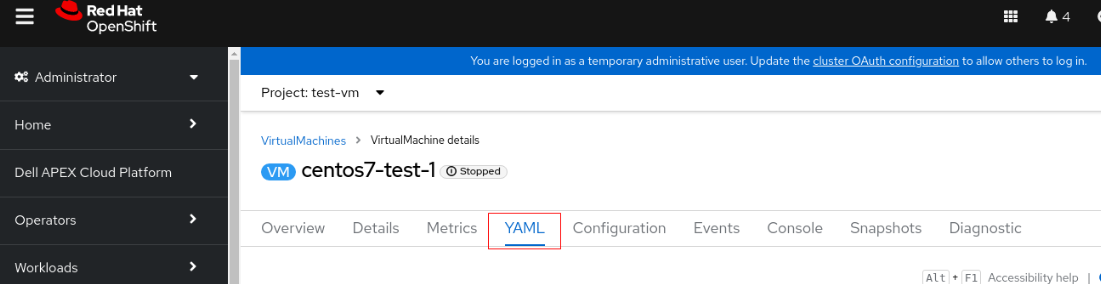
- 1.2 Haga clic en la VM y cambie a la pestaña YAML
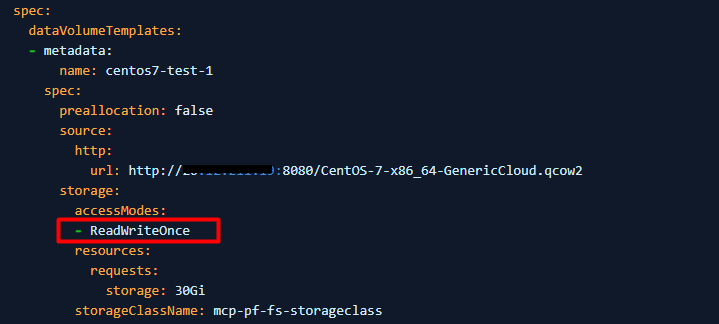
- 1.3 Cambie accessModes de "ReadWriteOnce" a "ReadWriteMany"
- 1.4 Si PV no se puede configurar en ReadWriteMany (la VM no puede comenzar a usar ReadWriteMany), configure evictionStrategy de LiveMigrate en None
Nota: Realice el paso 1.3 o 1.4 que corresponda a su entorno, no es necesario realizar ambos pasos.
- 1.5 Haga clic en Guardar y reinicie la máquina virtual.
2. Busque los nodos cuyo estado sea "Ready,SchedulingDisabled".
$ oc get nodePor ejemplo:
3. Drene el nodo para eliminar los pods en ejecución.
$ oc adm <node name> --ignore-daemonsets --delete-emptydir-data --forcePor ejemplo: oc adm drain c3-esx01.racka01.local --ignore-daemonsets --delete-emptydir-data --force
4. Configure el modo de depuración y reinicie el nodo.
$ oc debug node/<node name>

$ sh-4.4# chroot /host

$ sh-4.4# systemctl reboot
5. Una vez que el nodo esté listo después del reinicio, márquelo como programable.
$ oc adm uncordon <node name>
6. Verifique que el nodo se haya marcado correctamente como programable.
$ oc get node
Affected Products
APEX Cloud Platform for Red Hat OpenShiftArticle Properties
Article Number: 000216593
Article Type: Solution
Last Modified: 18 Sept 2026
Version: 4
Find answers to your questions from other Dell users
Support Services
Check if your device is covered by Support Services.