Openshift : Erreur post-vérification de la mise à niveau d’OCP car le nœud n’est pas prêt ou la planification est désactivée
Summary: Erreur post-vérification de la mise à niveau OCP car le nœud n’est pas prêt ou la planification est désactivée en raison d’une machine virtuelle configurée avec un volume de stockage ReadWriteOnce (RWO) qui ne peut pas être migré en direct. ...
This article applies to
This article does not apply to
This article is not tied to any specific product.
Not all product versions are identified in this article.
Symptoms
Au cours du processus de post-vérification de la mise à niveau OCP, le message d’erreur « Échec de l’exécution de la post-vérification pour le cluster OCP peut s’afficher. Le nœud n’est pas prêt ou la planification est désactivée. »
Cause
Une ou plusieurs machines virtuelles configurées avec un volume de stockage ReadWriteOnce (RWO) qui ne peuvent pas être migrées en direct sur le nœud de rapport d’erreur.
Consultez le document Openshift ci-dessous pour plus d’informations sur les volumes de stockage des disques de machine virtuelle.
Resolution
1. Modifiez les paramètres PV de la machine virtuelle.
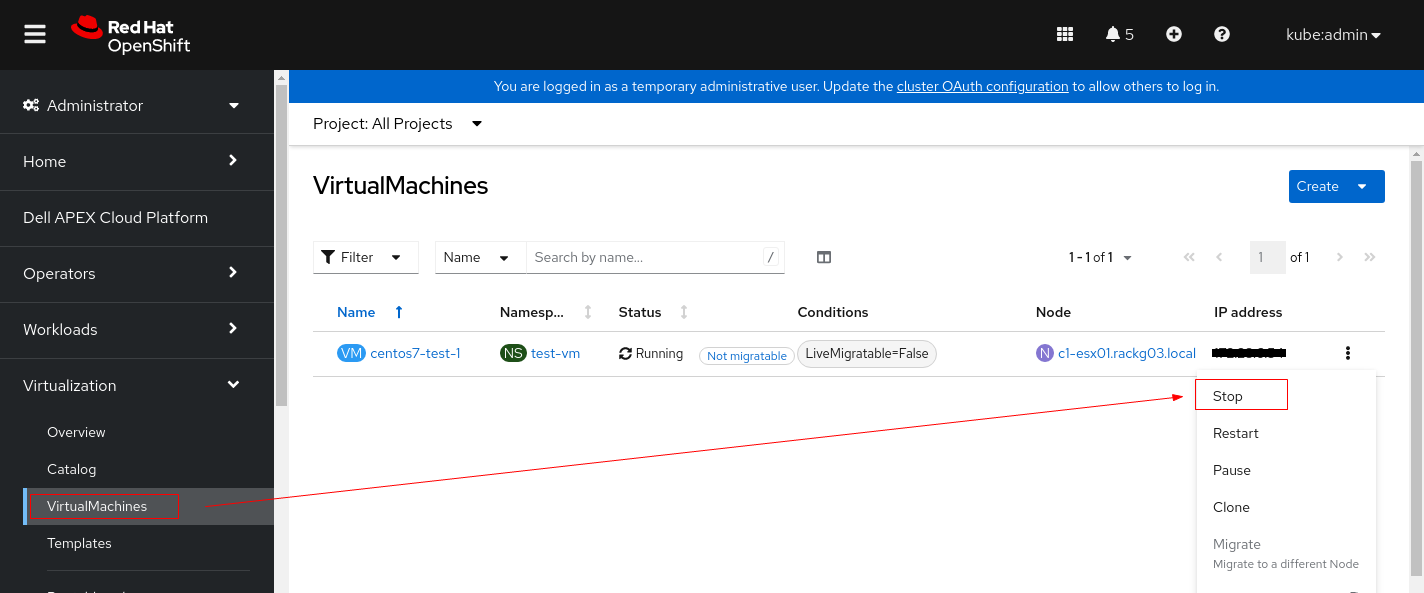
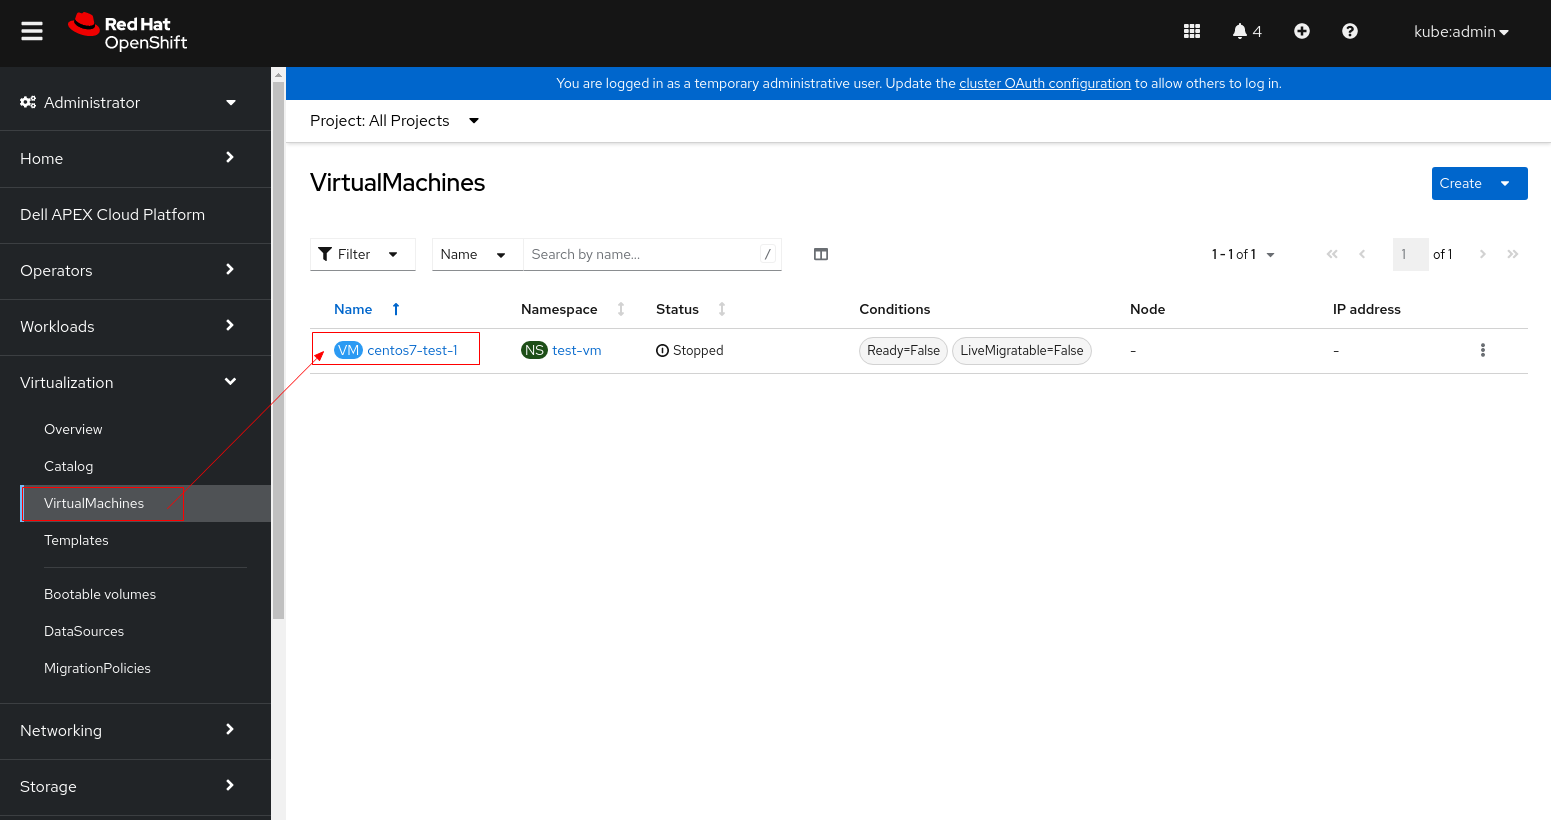
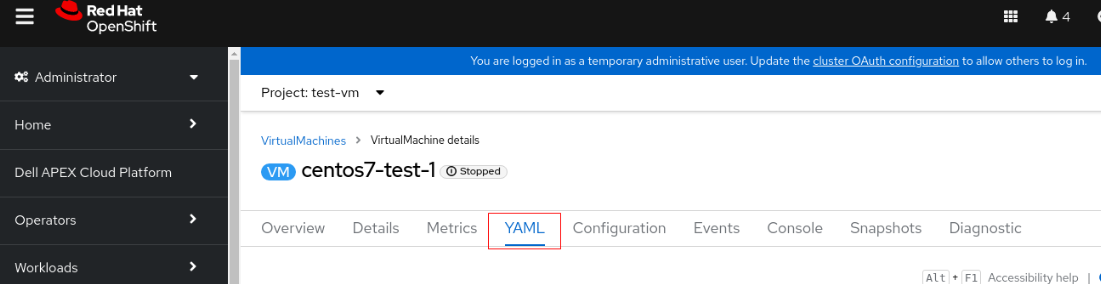
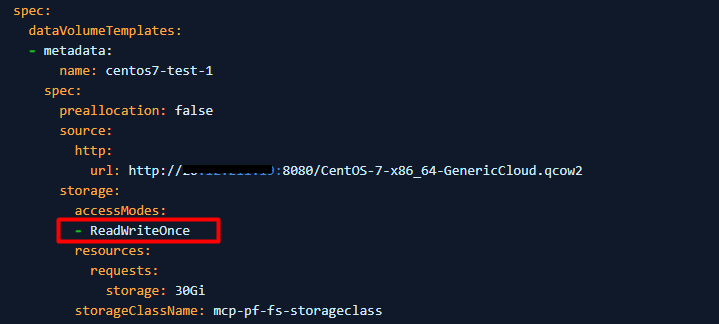
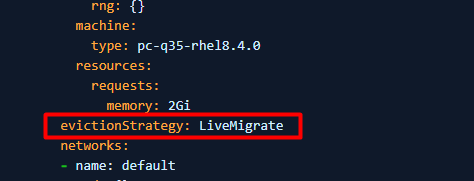
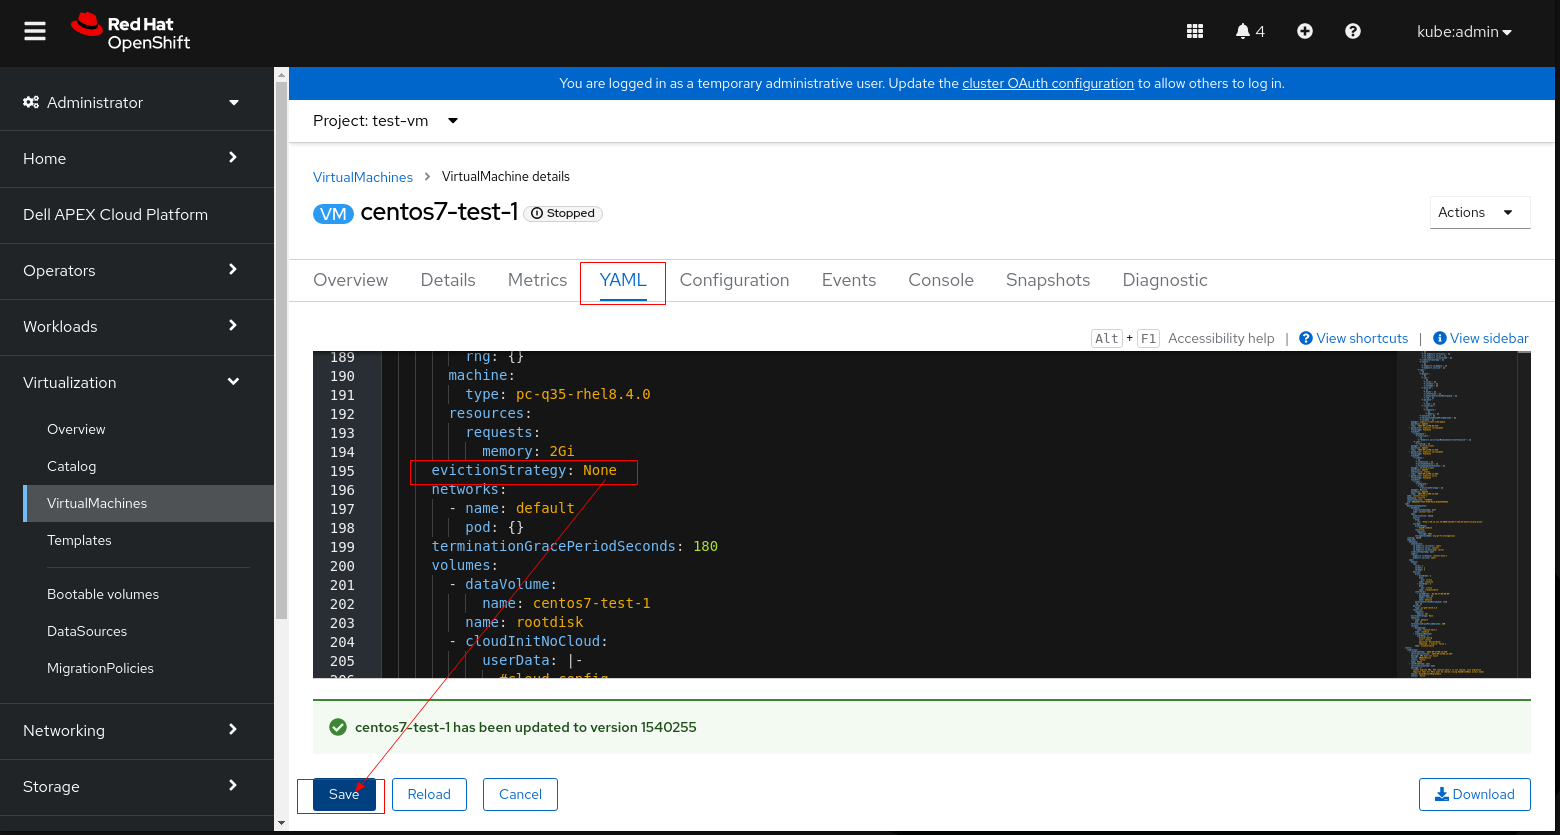
2. Recherchez les nœuds dont l’état est « Ready,SchedulingDisabled ».
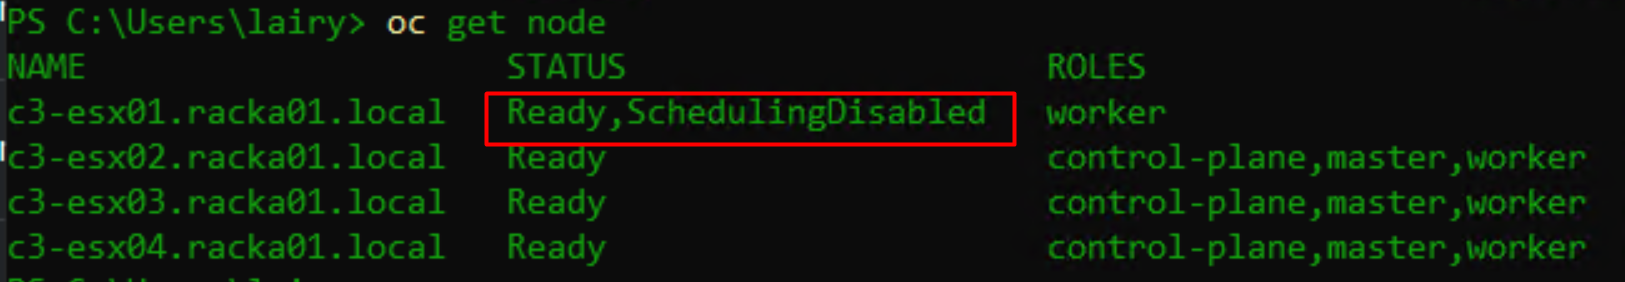
3. Videz le nœud pour en retirer les pods en cours d’exécution.
4. Définissez le mode de débogage et redémarrez le nœud.
5. Une fois que le nœud est prêt après le redémarrage, marquez-le comme pouvant être planifié.
6. Vérifiez que le nœud est correctement marqué comme pouvant être programmé.
- 1.1arrêtez l’instance de VM avant de modifier ses paramètres PV.
- 1.2 Cliquez sur la machine virtuelle et passez à l’onglet YAML
- 1.3 Changer accessModes de « ReadWriteOnce » à « ReadWriteMany »
- 1.4 Si PV ne peut pas être défini sur ReadWriteMany (la machine virtuelle ne peut pas commencer à utiliser ReadWriteMany), définissez evictionStrategy de LiveMigrate sur Aucun
Remarque : Veuillez effectuer l’étape 1.3 ou 1.4 qui s’applique à votre environnement. Vous n’avez pas besoin d’effectuer les deux étapes.
- 1.5 Cliquez sur Save et redémarrez la machine virtuelle.
2. Recherchez les nœuds dont l’état est « Ready,SchedulingDisabled ».
$ oc get nodePar exemple :
3. Videz le nœud pour en retirer les pods en cours d’exécution.
$ oc adm <node name> --ignore-daemonsets --delete-emptydir-data --forcePar exemple : oc adm drain c3-esx01.racka01.local --ignore-daemonsets --delete-emptydir-data --force
4. Définissez le mode de débogage et redémarrez le nœud.
$ oc debug node/<node name>

$ sh-4.4# chroot /host

$ sh-4.4# systemctl reboot
5. Une fois que le nœud est prêt après le redémarrage, marquez-le comme pouvant être planifié.
$ oc adm uncordon <node name>
6. Vérifiez que le nœud est correctement marqué comme pouvant être programmé.
$ oc get node
Affected Products
APEX Cloud Platform for Red Hat OpenShiftArticle Properties
Article Number: 000216593
Article Type: Solution
Last Modified: 18 Sept 2026
Version: 4
Find answers to your questions from other Dell users
Support Services
Check if your device is covered by Support Services.