Turno aperto: Errore di aggiornamento post-controllo OCP per nodo non pronto o pianificazione disabilitata
Summary: Errore di post-controllo dell'aggiornamento OCP per nodo non pronto o pianificazione disabilitata a causa di una macchina virtuale configurata con volume di storage ReadWriteOnce (RWO) che non può essere migrato in tempo reale. ...
This article applies to
This article does not apply to
This article is not tied to any specific product.
Not all product versions are identified in this article.
Symptoms
Durante il processo di post-controllo dell'aggiornamento OCP, potrebbe essere visualizzato il messaggio di errore "Impossibile eseguire il controllo post per il cluster OCP. Il nodo non è pronto o la pianificazione è disabilitata."
Cause
Una o più VM configurate con volume di storage ReadWriteOnce (RWO) di cui non è possibile eseguire la migrazione in tempo reale sul nodo di segnalazione degli errori.
Per ulteriori informazioni sui volumi di storage per i dischi delle macchine virtuali, consultare il documento Openshift riportato di seguito.
Resolution
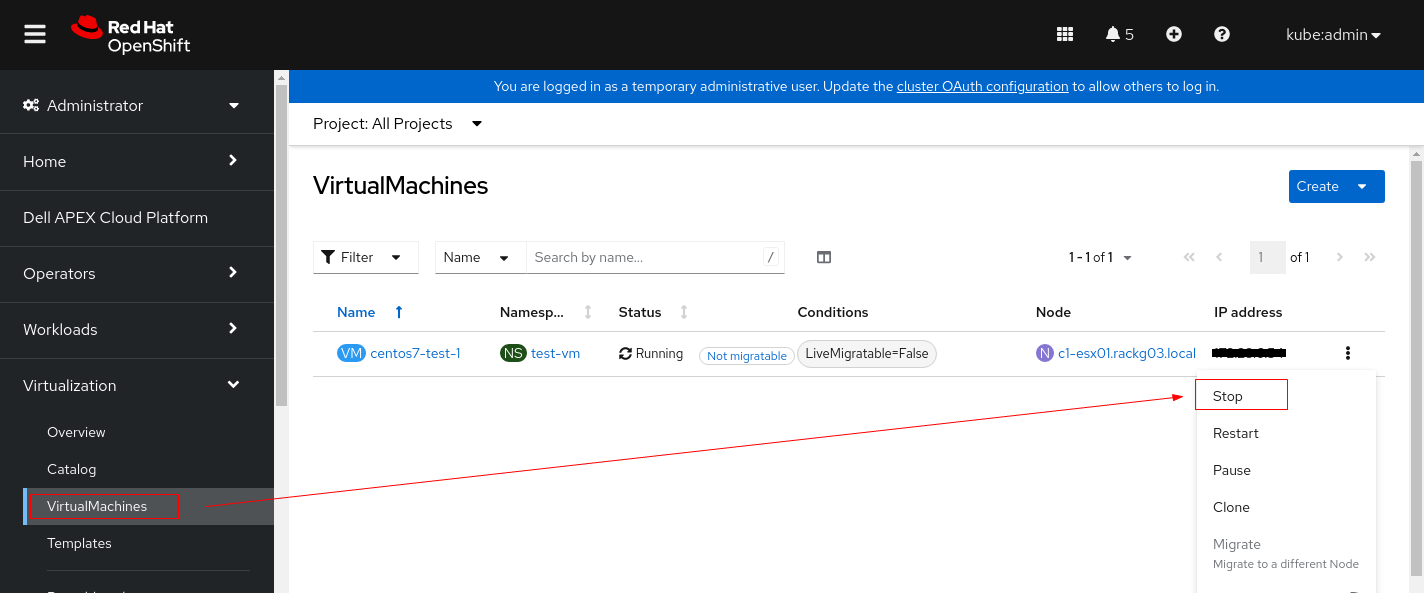
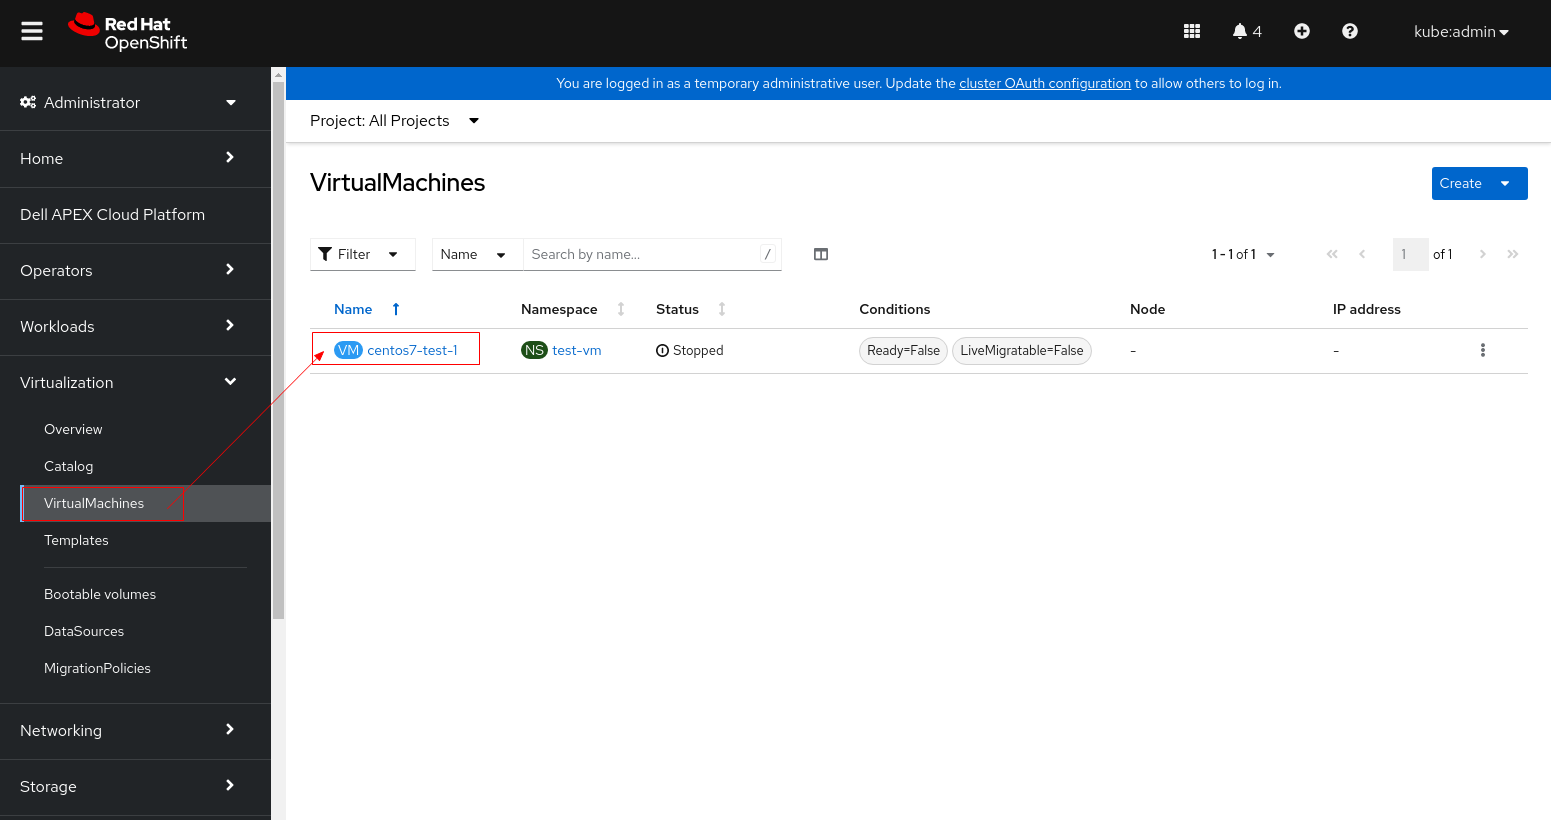
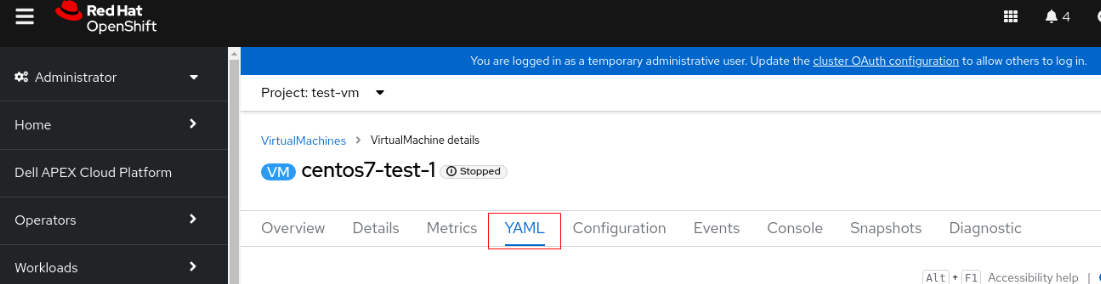
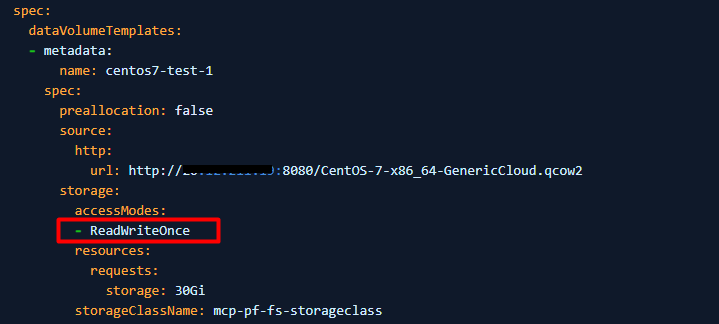
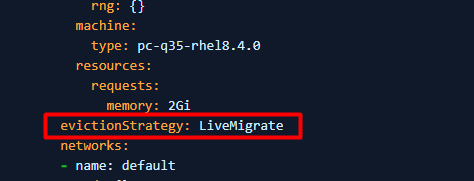
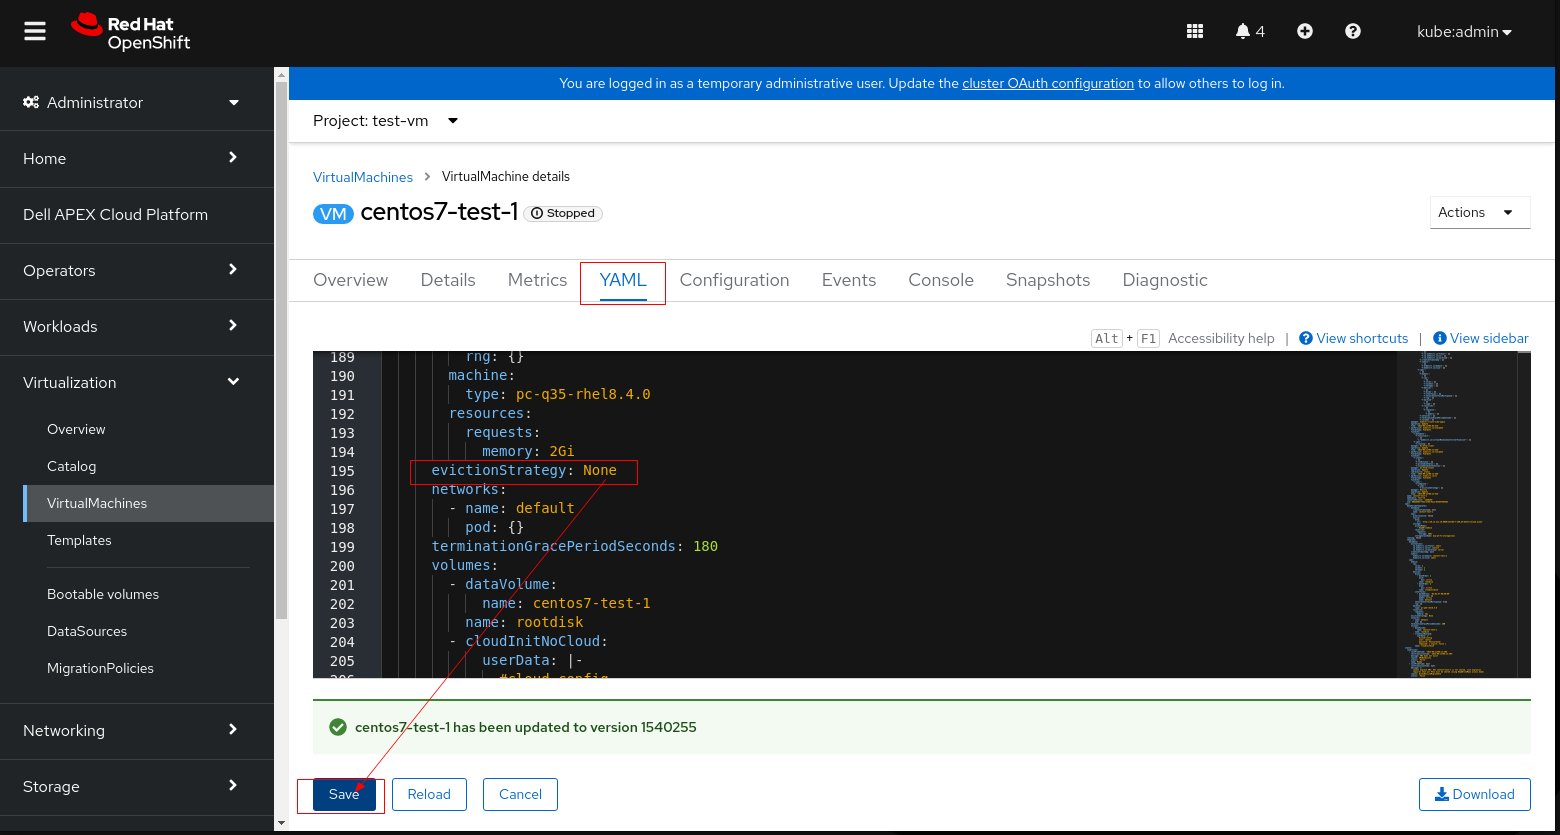
1. Modificare le impostazioni del VM PV.
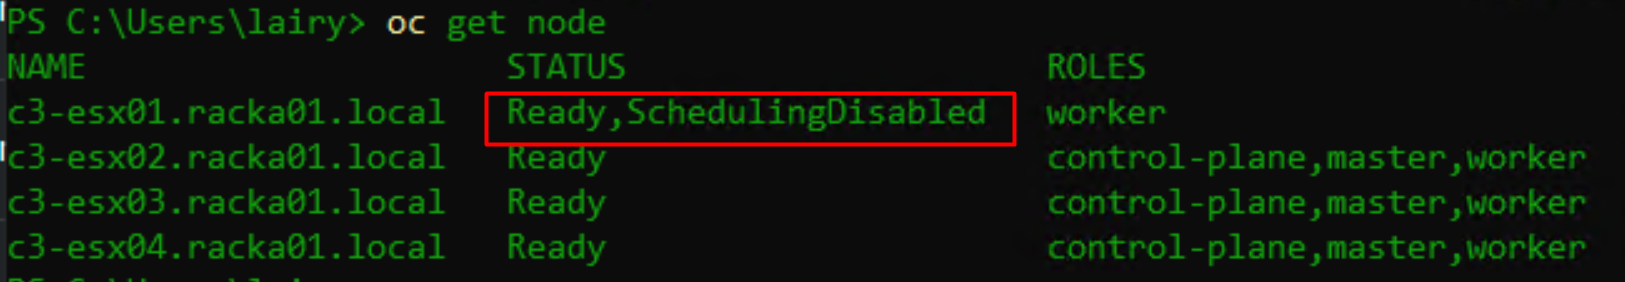
2. Individuare i nodi il cui stato è "Ready,SchedulingDisabled".
3. Svuotare il nodo per rimuovere i pod in esecuzione da esso.
4. Impostare la modalità di debug e riavviare il nodo.
5. Una volta che il nodo è pronto dopo il riavvio, contrassegnarlo come pianificabile.
6. Verificare che il nodo sia stato contrassegnato correttamente come pianificabile.
- 1.1arrestare l'istanza della VM prima di modificarne le impostazioni PV.
- 1.2 Cliccare sulla VM e passare alla scheda YAML
- 1.3 Modificare accessModes da "ReadWriteOnce" a "ReadWriteMany"
- 1.4 Se PV non può essere impostato su ReadWriteMany (la macchina virtuale non può iniziare a utilizzare ReadWriteMany), impostare evictionStrategy da LiveMigrate a None
Nota: Eseguire il passaggio 1.3 o 1.4 che si applica al proprio ambiente, non è necessario eseguire entrambi i passaggi.
- 1.5 Fare clic su Salva e riavviare la macchina virtuale.
2. Individuare i nodi il cui stato è "Ready,SchedulingDisabled".
$ oc get nodeAd esempio:
3. Svuotare il nodo per rimuovere i pod in esecuzione da esso.
$ oc adm <node name> --ignore-daemonsets --delete-emptydir-data --forceAd esempio: oc adm drain c3-esx01.racka01.local --ignore-daemonsets --delete-emptydir-data --force
4. Impostare la modalità di debug e riavviare il nodo.
$ oc debug node/<node name>

$ sh-4.4# chroot /host

$ sh-4.4# systemctl reboot
5. Una volta che il nodo è pronto dopo il riavvio, contrassegnarlo come pianificabile.
$ oc adm uncordon <node name>
6. Verificare che il nodo sia stato contrassegnato correttamente come pianificabile.
$ oc get node
Affected Products
APEX Cloud Platform for Red Hat OpenShiftArticle Properties
Article Number: 000216593
Article Type: Solution
Last Modified: 18 Sept 2026
Version: 4
Find answers to your questions from other Dell users
Support Services
Check if your device is covered by Support Services.