Openshift: OCP-upgrade postcheckfout voor knooppunt niet gereed of planning uitgeschakeld
Summary: OCP-upgrade postcheckfout voor knooppunt niet gereed of planning uitgeschakeld vanwege VM geconfigureerd met ReadWriteOnce (RWO) storagevolume dat niet live kan worden gemigreerd.
This article applies to
This article does not apply to
This article is not tied to any specific product.
Not all product versions are identified in this article.
Symptoms
Tijdens het controleproces na de OCP-upgrade kan er een foutmelding zijn met de tekst "Kan postcontrole voor OCP-cluster niet uitvoeren. Knooppunt is niet gereed of planning uitgeschakeld."
Cause
Een of meer VM's die zijn geconfigureerd met een ReadWriteOnce (RWO)-storagevolume die niet live kunnen worden gemigreerd op het foutrapportageknooppunt.
Raadpleeg onderstaand Openshift-document voor meer informatie over storagevolumes voor virtuele machineschijven.
Resolution
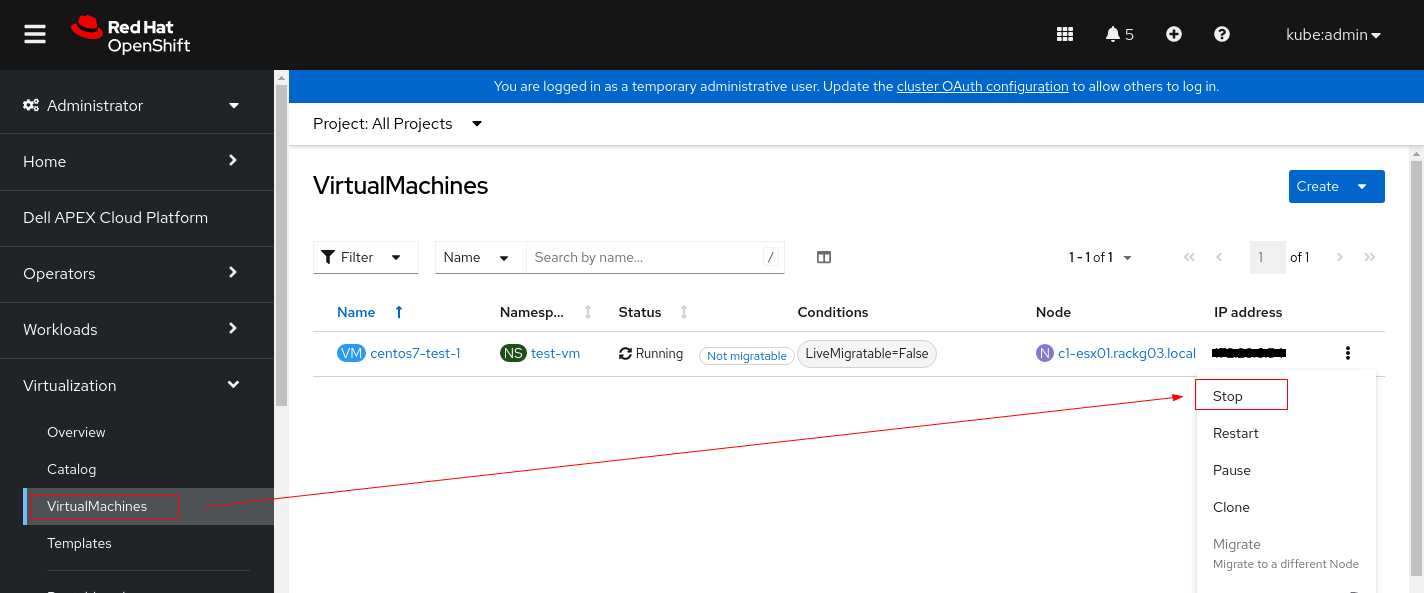
1. Wijzig de VM PV-instellingen.
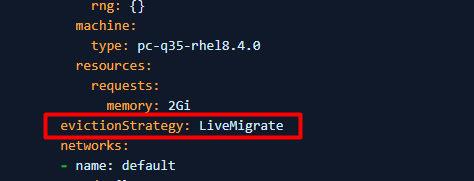
2. Zoek de knooppunten met de status "Ready,SchedulingDisabled".
3. Laat het knooppunt leeglopen om er actieve pods uit te verwijderen.
4. Stel de foutopsporingsmodus in en start het knooppunt opnieuw op.
5. Zodra het knooppunt gereed is na het opnieuw opstarten, markeert u het als planbaar.
6. Controleer of het knooppunt met succes is gemarkeerd als planbaar.
- 1.1Stop de VM-instantie voordat u de PV-instellingen wijzigt.
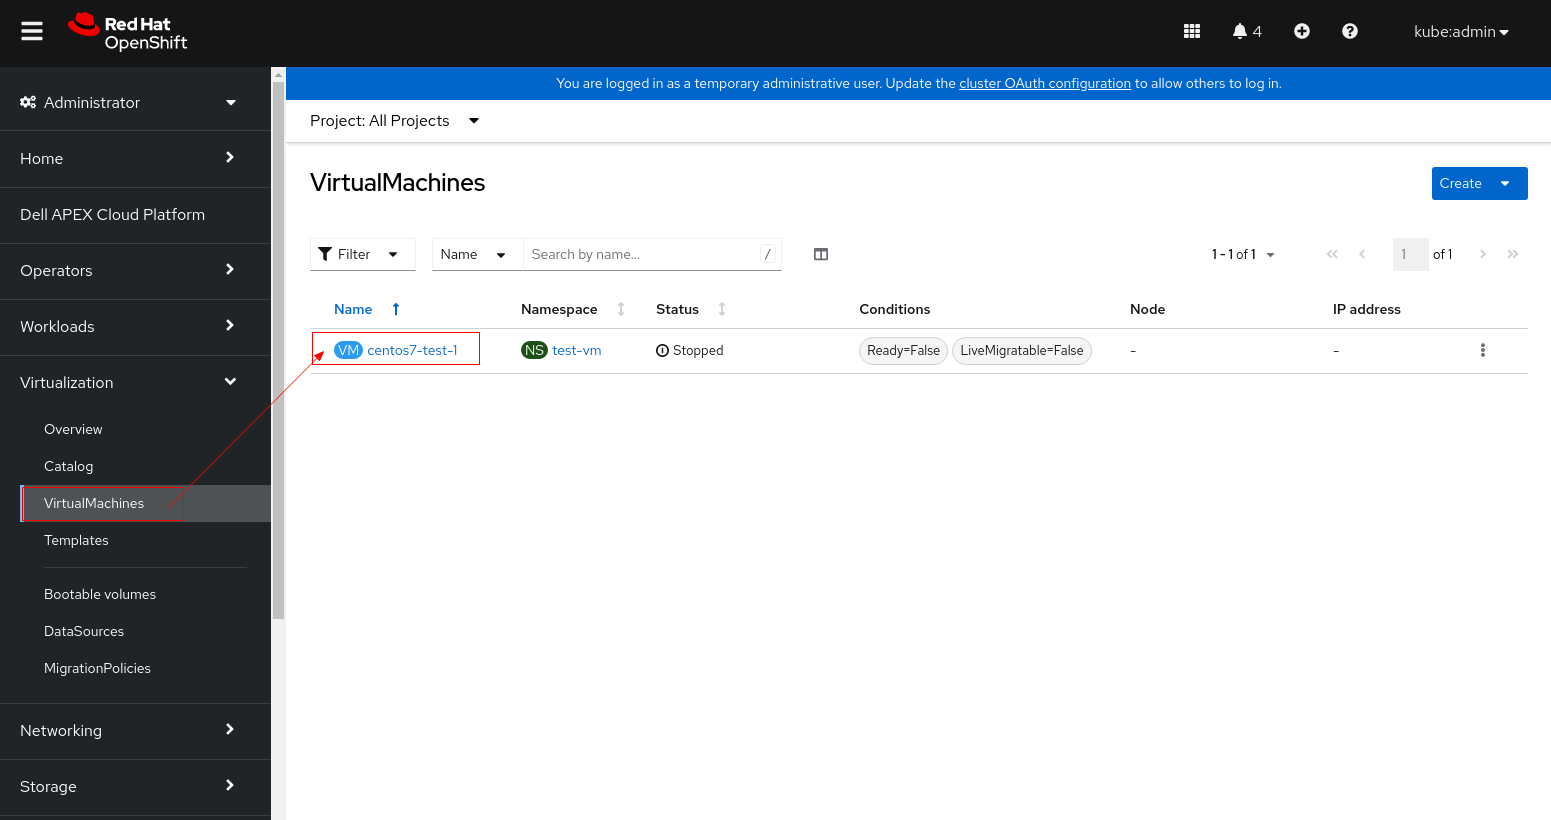
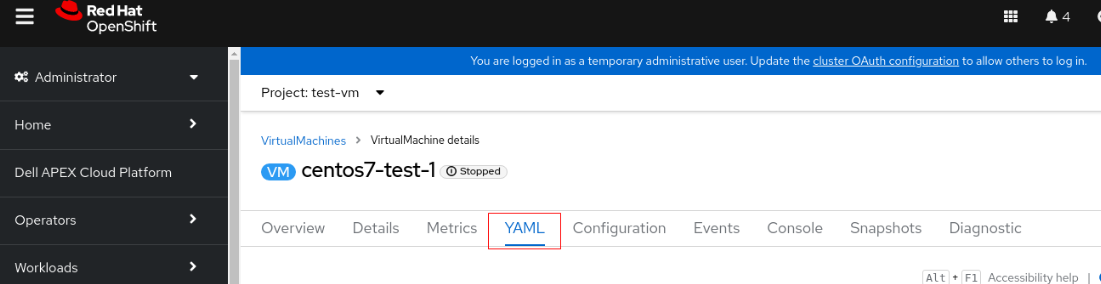
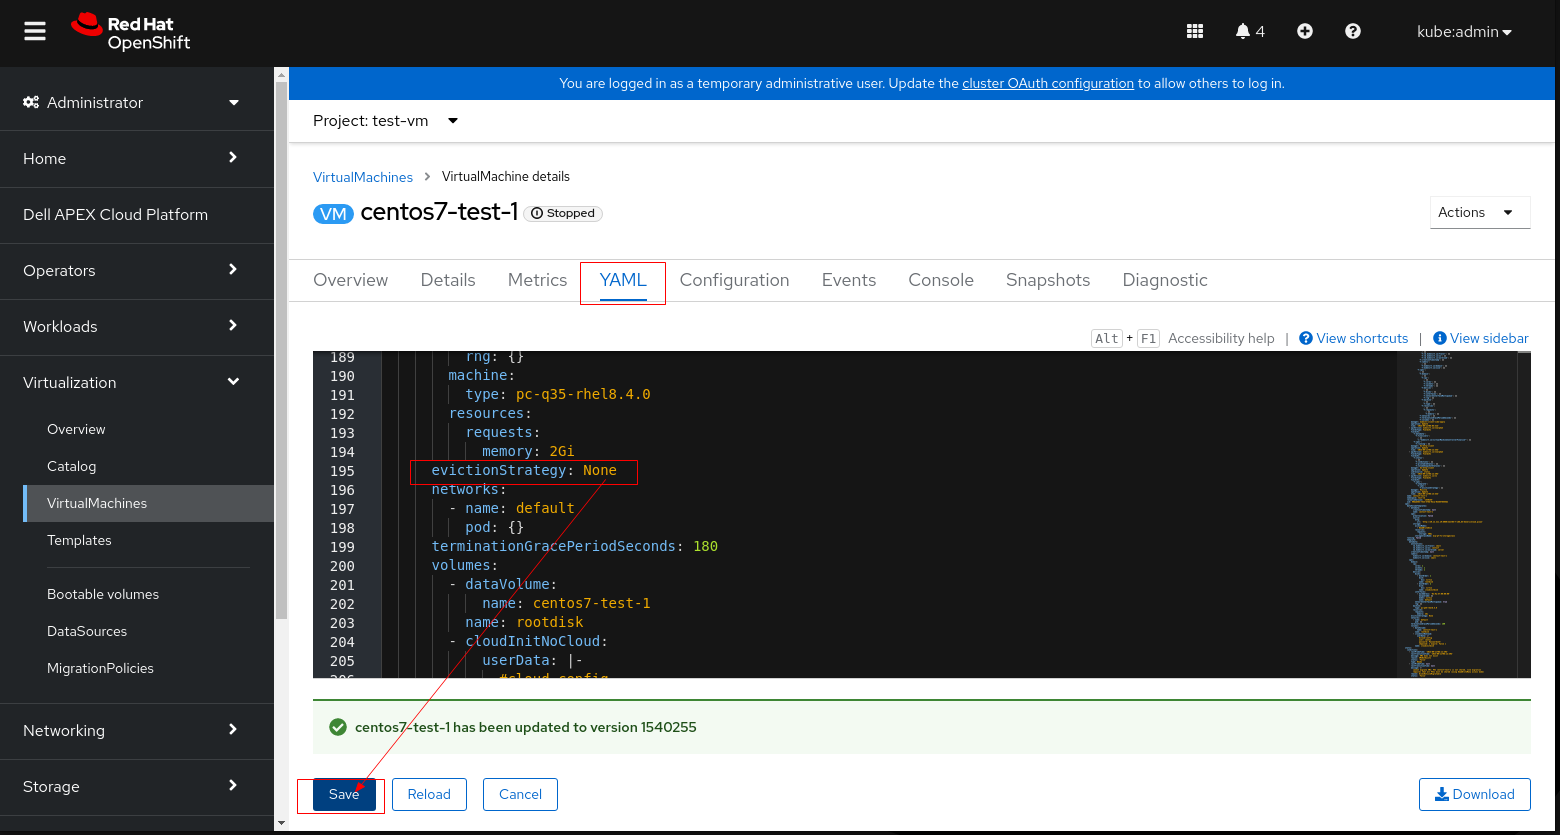
- 1.2 Klik op de VM en ga naar het tabblad YAML
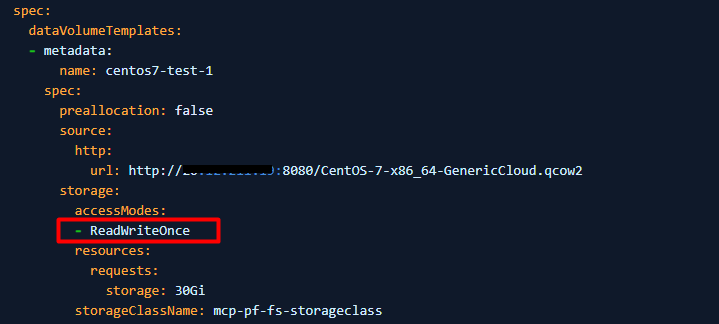
- 1.3 Wijzig accessModes van "ReadWriteOnce" naar "ReadWriteMany"
- 1.4 Als PV niet kan worden ingesteld op ReadWriteMany (de VM kan ReadWriteMany niet starten), stel dan evictionStrategy van LiveMigrate in op Geen
Opmerking: Voer stap 1.3 of 1.4 uit die van toepassing is op uw omgeving. U hoeft niet beide stappen uit te voeren.
- 1.5 Klik op Save en start de VM opnieuw.
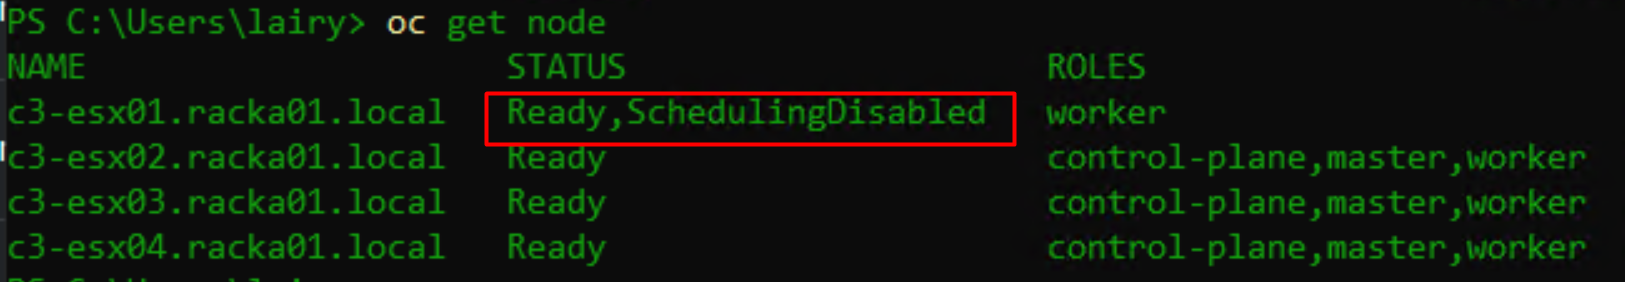
2. Zoek de knooppunten met de status "Ready,SchedulingDisabled".
$ oc get nodeBijvoorbeeld:
3. Laat het knooppunt leeglopen om er actieve pods uit te verwijderen.
$ oc adm <node name> --ignore-daemonsets --delete-emptydir-data --forceBijvoorbeeld: oc adm drain c3-esx01.racka01.local --ignore-daemonsets --delete-emptydir-data --force
4. Stel de foutopsporingsmodus in en start het knooppunt opnieuw op.
$ oc debug node/<node name>

$ sh-4.4# chroot /host

$ sh-4.4# systemctl reboot
5. Zodra het knooppunt gereed is na het opnieuw opstarten, markeert u het als planbaar.
$ oc adm uncordon <node name>
6. Controleer of het knooppunt met succes is gemarkeerd als planbaar.
$ oc get node
Affected Products
APEX Cloud Platform for Red Hat OpenShiftArticle Properties
Article Number: 000216593
Article Type: Solution
Last Modified: 18 Sept 2026
Version: 4
Find answers to your questions from other Dell users
Support Services
Check if your device is covered by Support Services.