Turno aberto: Erro de pós-verificação do upgrade do OCP para nó não pronto ou agendamento desativado
Summary: Erro pós-verificação do upgrade do OCP para nó não pronto ou agendamento desativado devido a VM configurada com volume de armazenamento ReadWriteOnce(RWO) que não pode ser migrado em tempo real. ...
This article applies to
This article does not apply to
This article is not tied to any specific product.
Not all product versions are identified in this article.
Symptoms
Durante o processo de pós-verificação do upgrade do OCP, pode ser exibida uma mensagem de erro dizendo "Falha ao executar a verificação de após o cluster do OCP. O nó não está pronto ou a programação está desativada."
Cause
Uma ou mais VMs configuradas com o volume de armazenamento ReadWriteOnce(RWO) que não pode ser migrado em tempo real no nó de geração de relatórios de erros.
Verifique abaixo o documento do Openshift para obter mais informações sobre volumes de armazenamento para discos de máquina virtual.
Resolution
1. Altere as configurações do PV da VM.
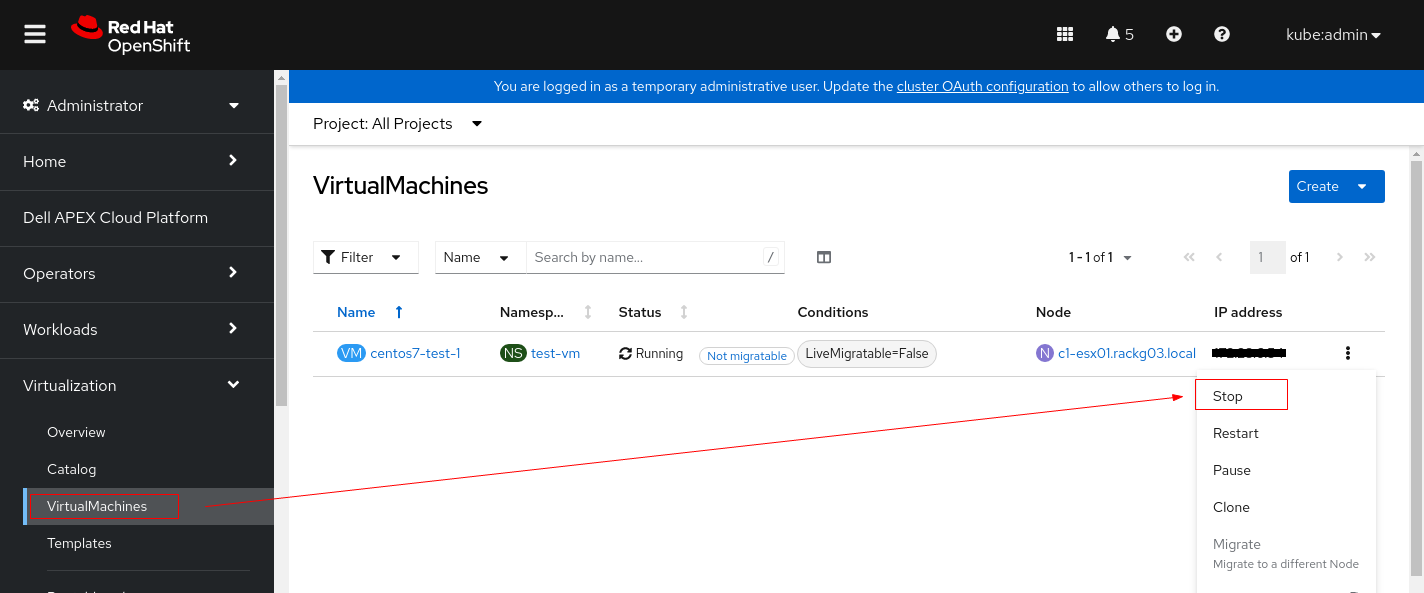
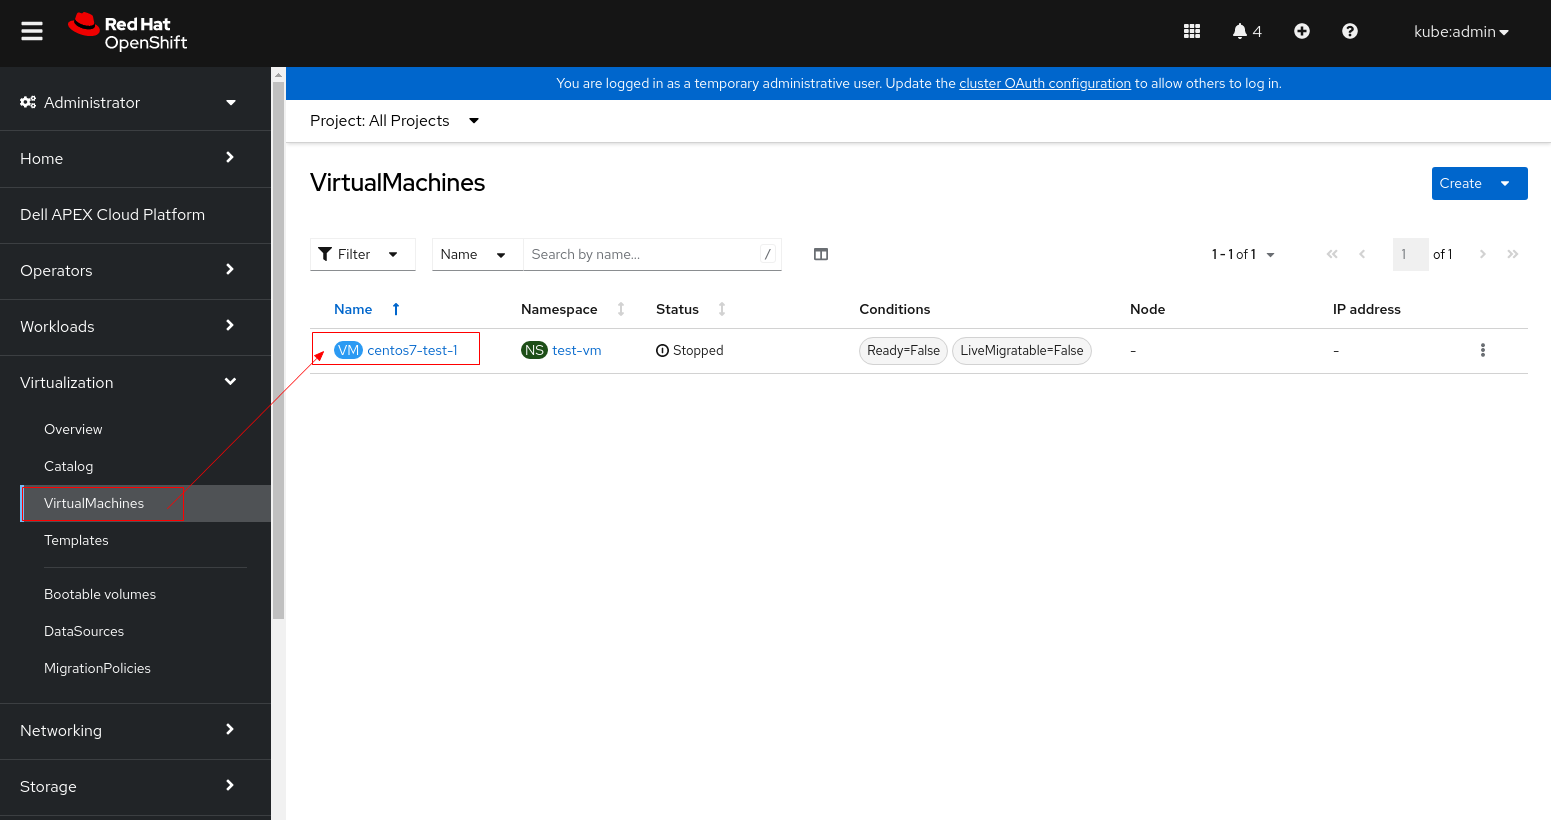
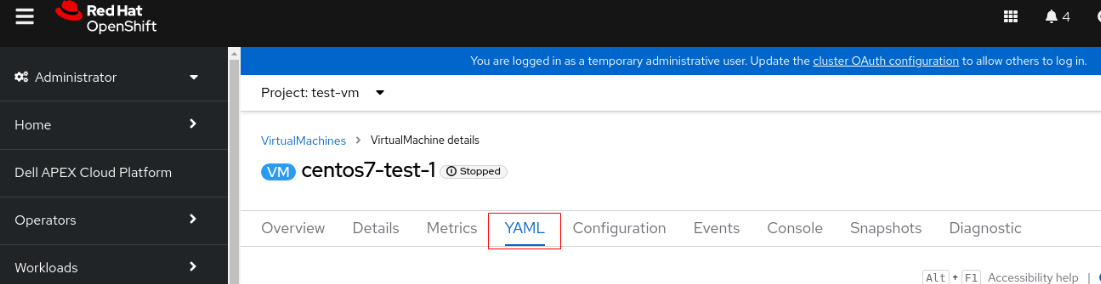
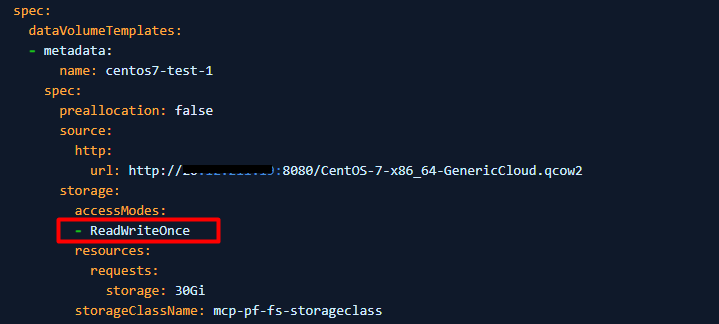
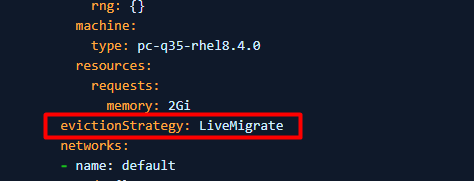
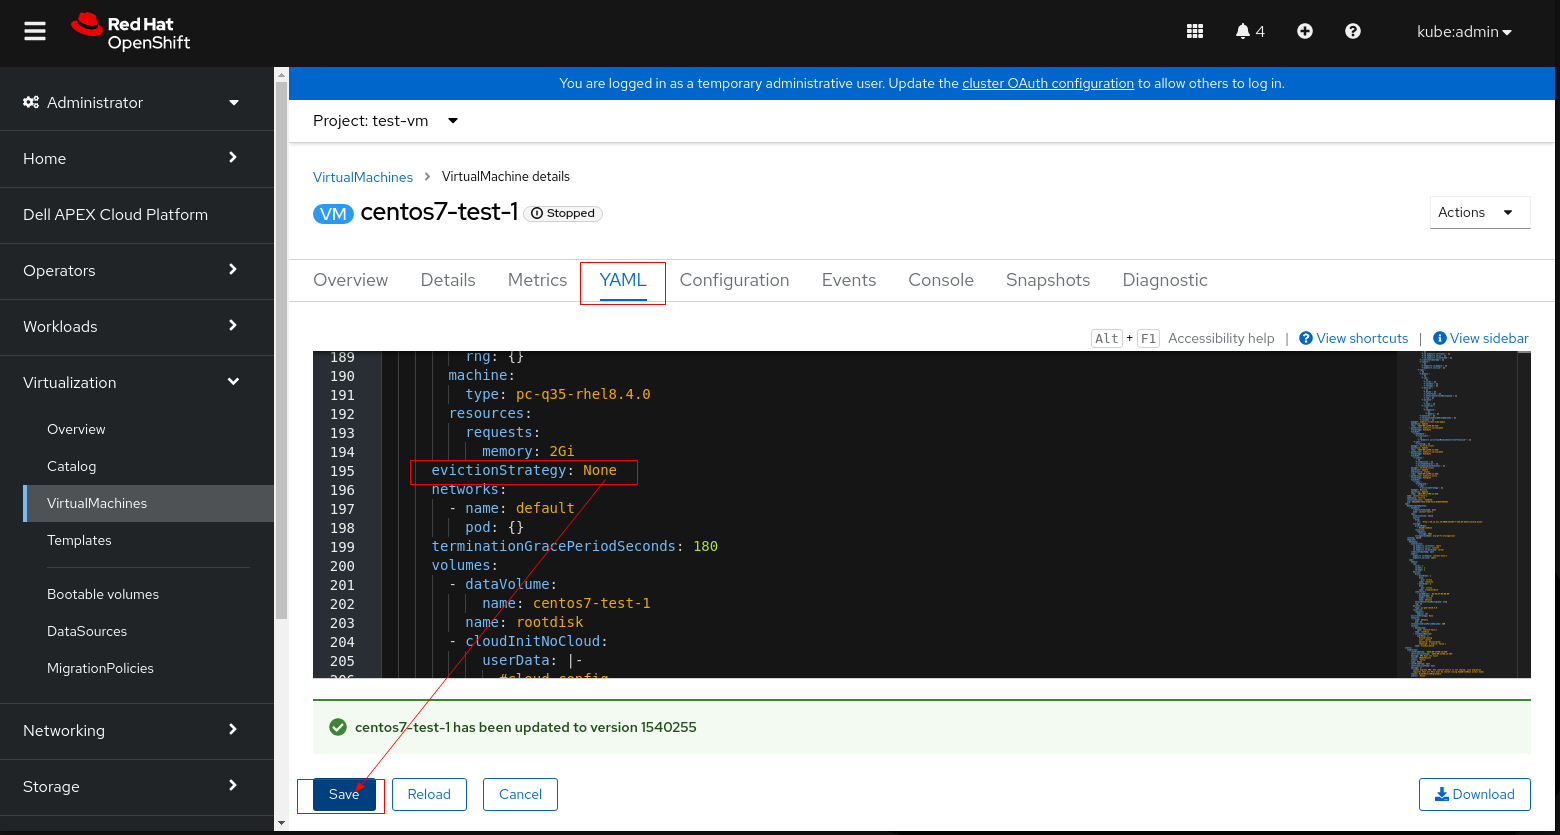
2. Localize os nós cujo status é "Ready,SchedulingDisabled".
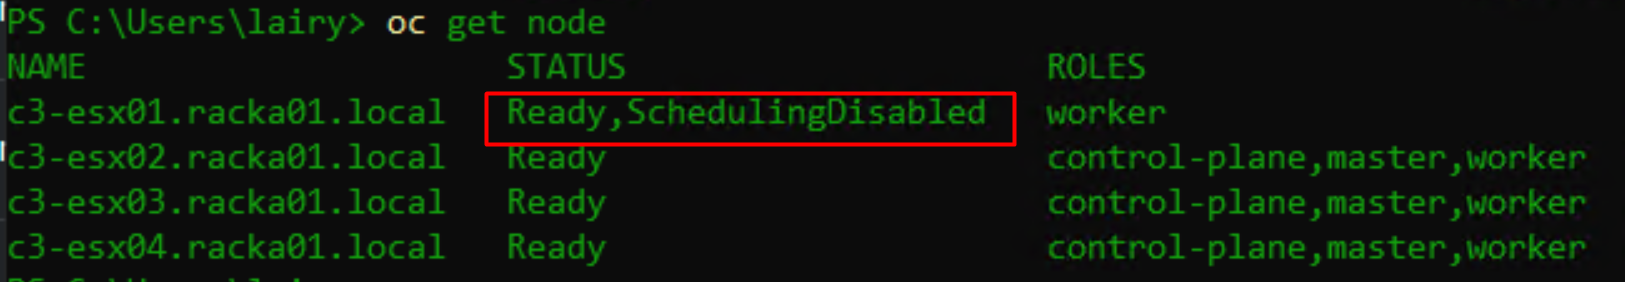
3. Drene o nó para remover pods em execução dele.
4. Defina o modo de depuração e reinicialize o nó.
5. Quando o nó estiver pronto após a reinicialização, marque-o como ativo.
6. Verifique se o nó foi marcado com sucesso como ativo.
- 1.1 interrompa a instância da VM antes de alterar suas configurações de PV.
- 1.2 Clique na VM e alterne para a guia YAML
- 1.3 Altere accessModes de "ReadWriteOnce" para "ReadWriteMany"
- 1.4 Se o PV não puder ser definido como ReadWriteMany (a VM não pode começar a usar ReadWriteMany), defina a evictionStrategy de LiveMigrate como None
Nota: Execute a etapa 1.3 ou 1.4 que se aplica ao seu ambiente, não precisa executar as duas etapas.
- 1.5 Clique em Save e reinicie a VM.
2. Localize os nós cujo status é "Ready,SchedulingDisabled".
$ oc get nodePor exemplo:
3. Drene o nó para remover pods em execução dele.
$ oc adm <node name> --ignore-daemonsets --delete-emptydir-data --forcePor exemplo: oc adm drain c3-esx01.racka01.local --ignore-daemonsets --delete-emptydir-data --force
4. Defina o modo de depuração e reinicialize o nó.
$ oc debug node/<node name>

$ sh-4.4# chroot /host

$ sh-4.4# systemctl reboot
5. Quando o nó estiver pronto após a reinicialização, marque-o como ativo.
$ oc adm uncordon <node name>
6. Verifique se o nó foi marcado com sucesso como ativo.
$ oc get node
Affected Products
APEX Cloud Platform for Red Hat OpenShiftArticle Properties
Article Number: 000216593
Article Type: Solution
Last Modified: 18 Sept 2026
Version: 4
Find answers to your questions from other Dell users
Support Services
Check if your device is covered by Support Services.