오픈 시프트: 비정상 정적 포드 상태로 인해 클러스터 배포 프로세스에 실패했습니다.
요약: 클러스터 배포 실패를 유발하는 OpenShift Container Platform 문제로 정적 Pod 상태가 완료됨으로 변경되었습니다.
이 문서는 다음에 적용됩니다.
이 문서는 다음에 적용되지 않습니다.
이 문서는 특정 제품과 관련이 없습니다.
모든 제품 버전이 이 문서에 나와 있는 것은 아닙니다.
증상
클러스터 배포 프로세스 중에 다음 시나리오를 포함하되 이에 국한되지 않는 다양한 오류가 관찰될 수 있습니다.
시나리오 1: 클러스터 배포 구성 프로세스가 실패하고 "OCP 컨트롤 플레인 준비될 때까지 기다리는 단계를 실행하지 못함"
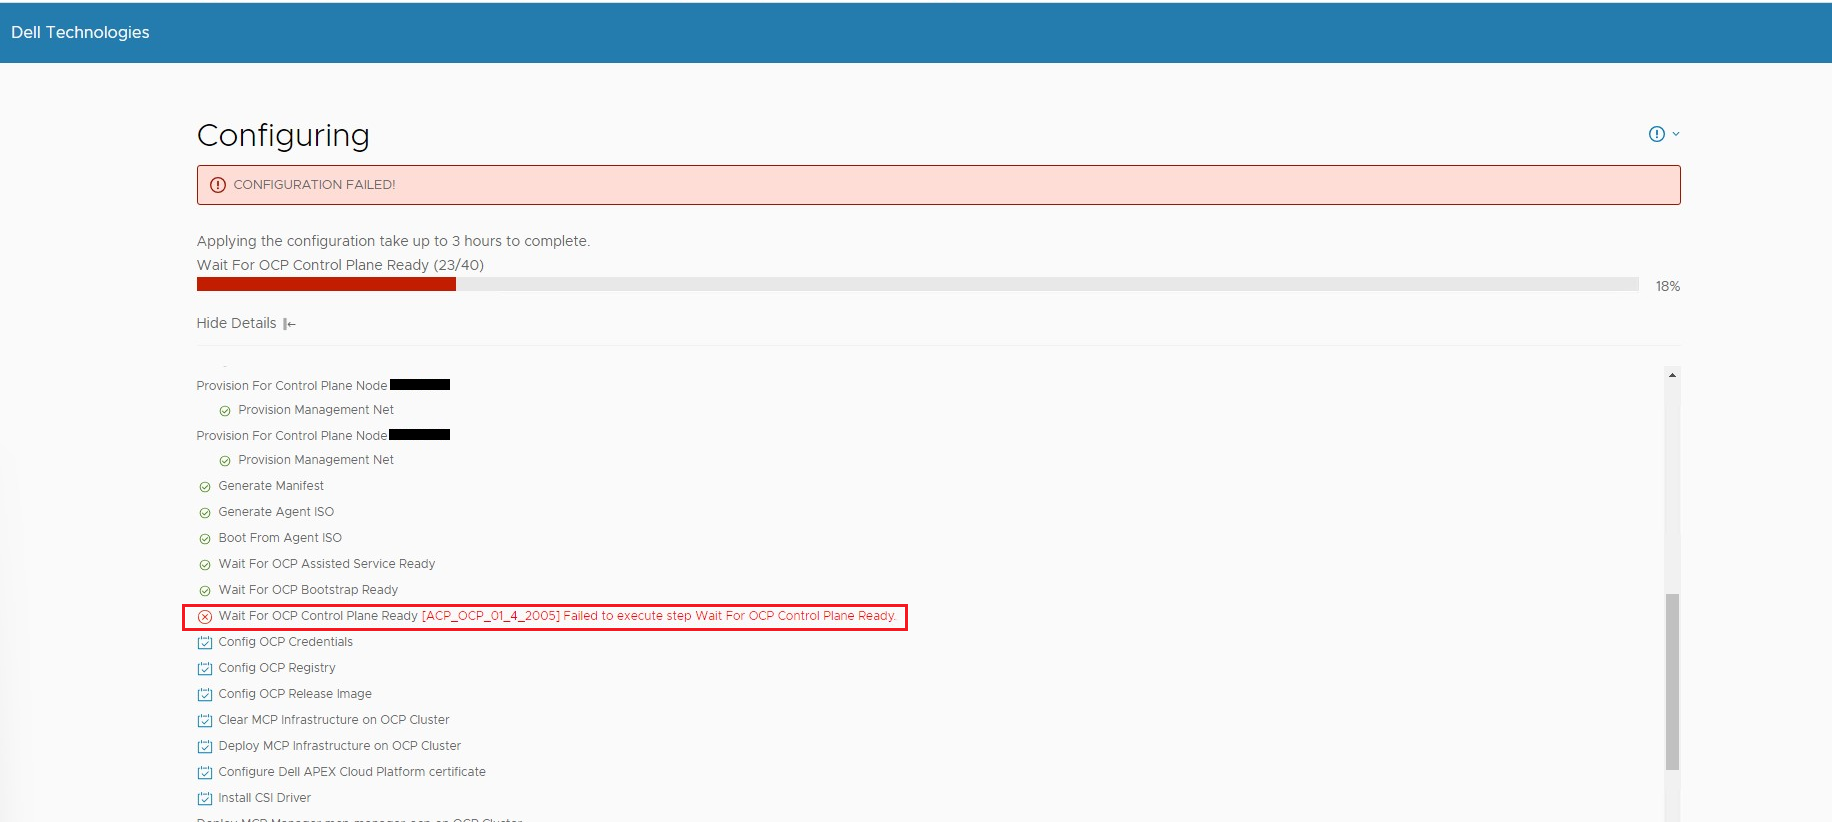
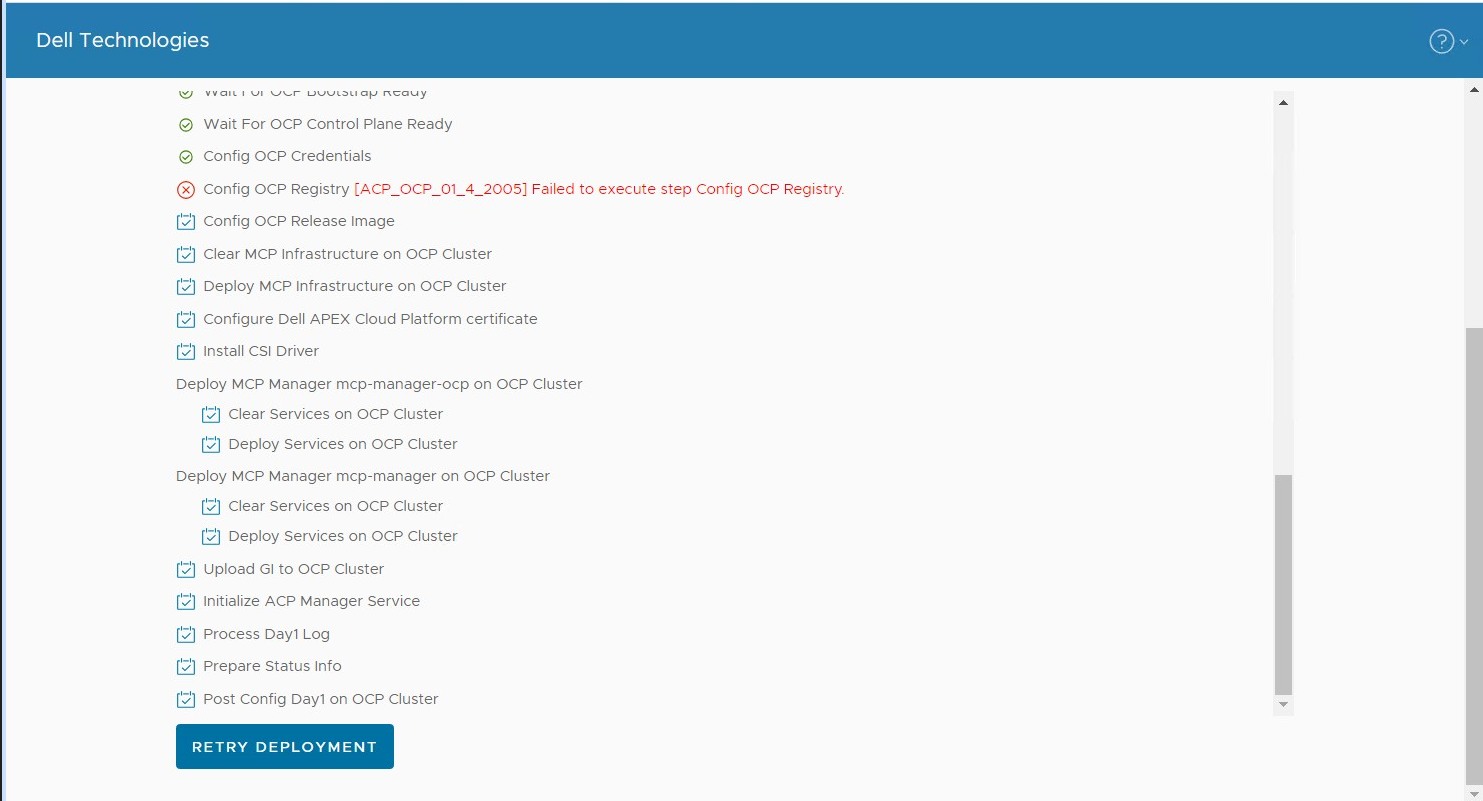
오류가 발생했습니다.시나리오 2: 클러스터 배포 구성 프로세스가 실패하고 "OCP 레지스트리 구성 단계 실행 실패" 오류가 표시됩니다.
이 명령은 "kube-scheduler is degraded"를 반환합니다.
또는 "kube-controller-manager is degraded"를 반환합니다.
2. 다음 명령을 실행합니다.
예를 들어 kube-controller-manager is degraded를 사용합니다. 이 명령은 "GuardControllerDegraded: 노드에서 피연산자가 누락되었습니다."
시나리오 1: 클러스터 배포 구성 프로세스가 실패하고 "OCP 컨트롤 플레인 준비될 때까지 기다리는 단계를 실행하지 못함"
오류가 발생했습니다.시나리오 2: 클러스터 배포 구성 프로세스가 실패하고 "OCP 레지스트리 구성 단계 실행 실패" 오류가 표시됩니다.
SSH를 통해 기본 노드에 로그인하고(기본 자격 증명은 root/Passw0rd!), 아래 명령을 실행하여 clusterversion, clusteroperator 및 정적 Pod 상태를 확인합니다.
1. 다음 명령을 실행합니다.kubectl --kubeconfig="/usr/share/mcp_ocp/pv/mcp-installer-ocp/auth/kubeconfig" get clusterversion
이 명령은 "kube-scheduler is degraded"를 반환합니다.
| 이름 버전 사용 가능 이후 진행 중 상태
버전 거짓 거짓 5h4m 조정 중 오류 발생 4.13.12: 클러스터 운영자 kube-scheduler의 성능이 저하됨 |
또는 "kube-controller-manager is degraded"를 반환합니다.
| 이름 버전 사용 가능 이후 진행 중 상태
버전 거짓 거짓 5h4m 조정 중 오류 발생 4.13.12: 클러스터 운영자 kube-controller-manager 성능이 저하됨 |
2. 다음 명령을 실행합니다.
kubectl --kubeconfig="/usr/share/mcp_ocp/pv/mcp-installer-ocp/auth/kubeconfig" get co
예를 들어 kube-controller-manager is degraded를 사용합니다. 이 명령은 "GuardControllerDegraded: 노드에서 피연산자가 누락되었습니다."
|
사용 가능한 이름 버전 다음 이후로 성능 저하 진행 중 메시지 ...... kube-controller-manager 4.13.12 True True True 4d7h GuardControllerDegraded: [노드 h01-01-compute-02.p82.local에서 피연산자 누락, 노드 h01-01-compute-03.p82.local에서 피연산자 누락] ... ...... machine-config 4.13.12 True False True 4d7h 4.13.12를 다시 동기화하지 못했는데 그 이유는 syncRequiredMachineConfigPools 중 오류가 발생했습니다. [조건을 기다리는 동안 시간이 초과되었습니다. 오류 풀 마스터가 준비되지 않았습니다. 다시 시도합니다. Status: (풀 성능 저하: 실제 합계: 3, Ready 1, 업데이트됨: 1, 사용할 수 없음: 2)] |
3. 다음 명령을 실행합니다.
kubectl --kubeconfig="/usr/share/mcp_ocp/pv/mcp-installer-ocp/auth/kubeconfig" get pods -A | grep kube-controller-manager
예를 들어 kube-controller-manager의 성능이 저하된 경우 명령은 하나의 kube-controller-manager가 0/1임을 표시합니다.
|
이름 준비 상태 재시작 기간 installer-4-h01-01-compute-03.p82.local 0/1 완료 0 4d7h installer-4-h01-01-compute-04.p82.local 0/1 완료 0 4d7h installer-5-h01-01-compute-03.p82.local 0/1 완료 0 4d7h installer-5-h01-01-compute-04.p82.local 0/1 완료 0 4d7h installer-6-h01-01-compute-03.p82.local 0/1 완료 0 4d7h kube-controller-manager-guard-h01-01-compute-03.p82.local 0/1 실행 0 4d7h kube-controller-manager-guard-h01-01-compute-04.p82.local 1/1 실행 0 4d7h kube-controller-manager-h01-01-compute-04.p82.local 4/4 실행 0 4d7h |
원인
이것은 OCP 4.10, 4.11, 4.12 및 4.13의 알려진 문제입니다.
근본 원인은 쿠버네티스가 일부 파드를 삭제하지 못해 일부 서비스가 비정상 상태가 되기 때문이다.
근본 원인은 쿠버네티스가 일부 파드를 삭제하지 못해 일부 서비스가 비정상 상태가 되기 때문이다.
해결
이 문제는 향후 OCP 버전에서 수정될 예정입니다.
영향을 받는 OCP 버전의 경우 아래 단계에 따라 문제를 해결하십시오.
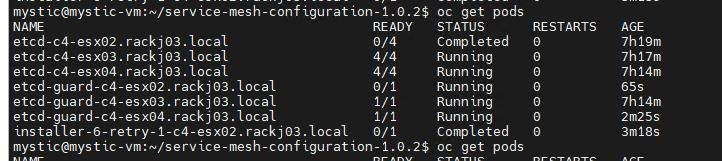
식별된 노드에 SSH 로그인, 위의 예에서 식별된 노드 이름은 "c4-esx02.rackj03.local"입니다.
1. 클러스터 구축 마법사 웹 페이지에서 생성한 ssh 공개 키에 해당하는 개인 키를 저장합니다.
예:
명령 실행: ssh-keygen -t ecdsa -b 521
명령 실행: ssh-keygen -t ecdsa -b 521
- 키를 저장할 파일 이름을 입력하거나 기본값을 사용합니다.
- 암호문구를 입력하거나 기본값을 사용합니다.
명령 출력은 다음과 같습니다.
ID가 /root/.ssh/id_ecdsa
에 저장되었습니다. 공개 키가 /root/.ssh/id_ecdsa.pub에 저장되었습니다.
에 저장되었습니다. 공개 키가 /root/.ssh/id_ecdsa.pub에 저장되었습니다.
이 예에서 "/root/.ssh/id_ecdsa"는 개인 키 파일이며 다음 명령에 사용됩니다.
2. ssh -l core <node name> -i <private_key_file>
3 명령을 실행합니다. sudo systemctl restart kubelet
4 명령을 실행합니다. 마법사 웹 페이지에서 클러스터 배포 프로세스 재시도
해당 제품
APEX Cloud Platform for Red Hat OpenShift문서 속성
문서 번호: 000218328
문서 유형: Solution
마지막 수정 시간: 18 9월 2026
버전: 5
다른 Dell 사용자에게 질문에 대한 답변 찾기
지원 서비스
디바이스에 지원 서비스가 적용되는지 확인하십시오.