Openshift:节点未就绪或计划被禁用的 OCP 升级后检查出错
摘要: 由于无法实时迁移配置了 ReadWriteOnce (RWO) 存储卷的虚拟机,节点未就绪或计划被禁用,因此出现 OCP 升级后检查错误。
本文适用于
本文不适用于
本文并非针对某种特定的产品。
本文并非包含所有产品版本。
症状
在 OCP 升级后检查过程中,可能会显示一条错误消息“无法为 OCP 群集运行后检查。节点未就绪或计划已禁用。”
原因
配置了 ReadWriteOnce (RWO) 存储卷的一个或多个虚拟机无法在错误报告节点上进行实时迁移。
查看以下 Openshift 文档,了解有关虚拟机磁盘存储卷的更多信息。
解决方案
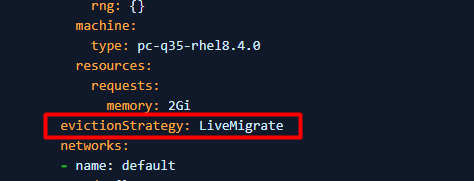
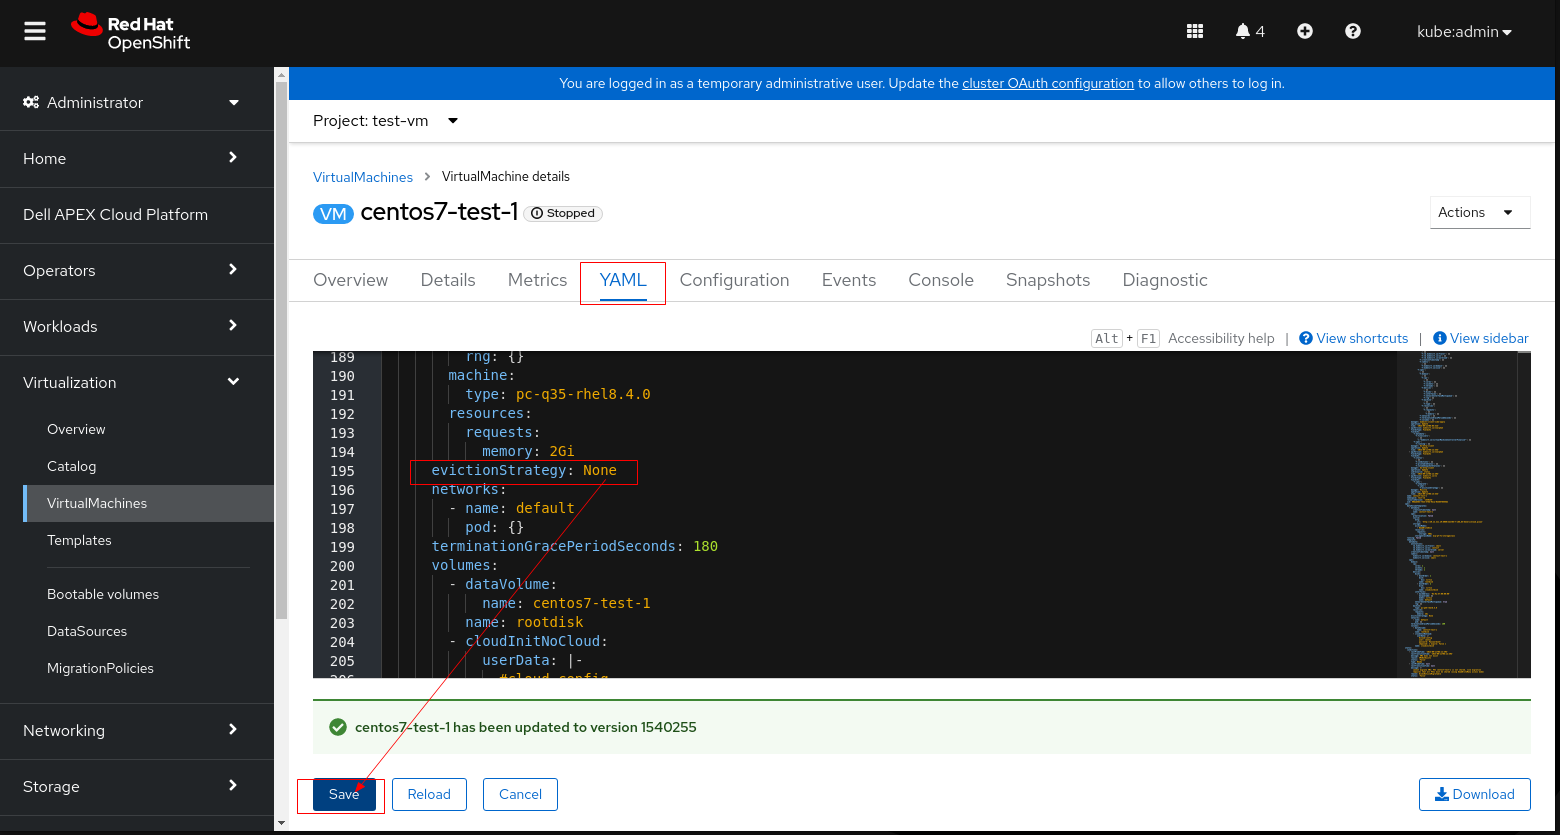
1.更改虚拟机 PV 设置。
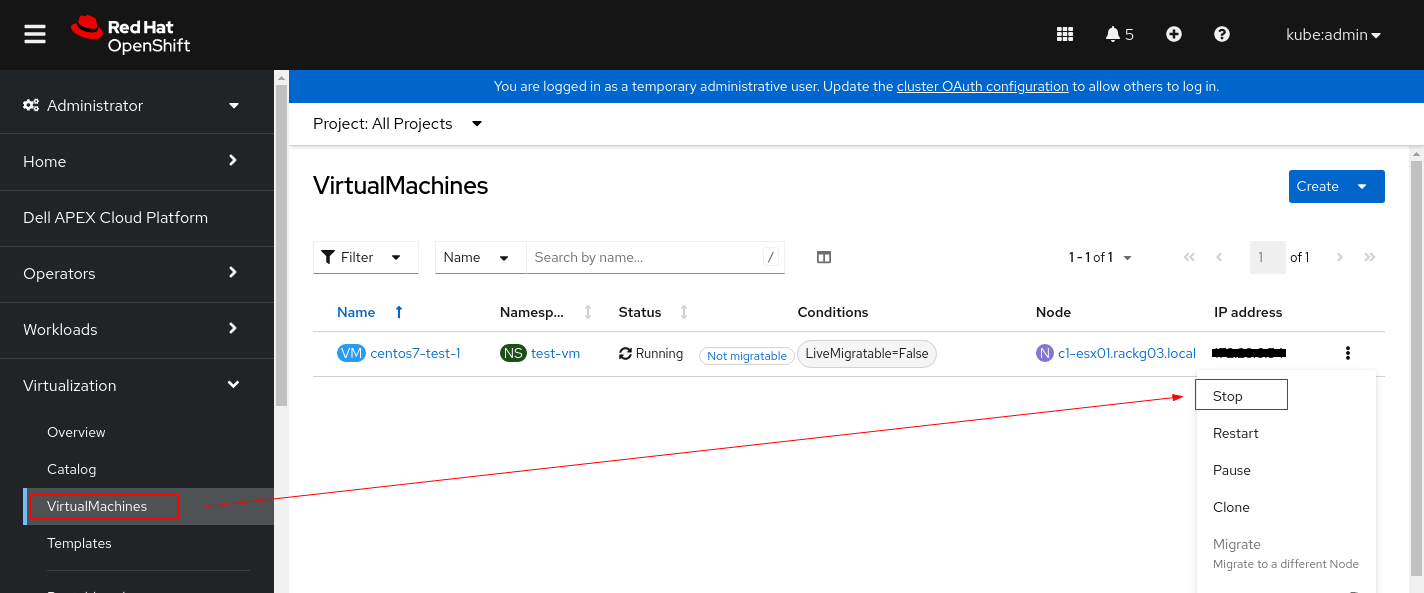
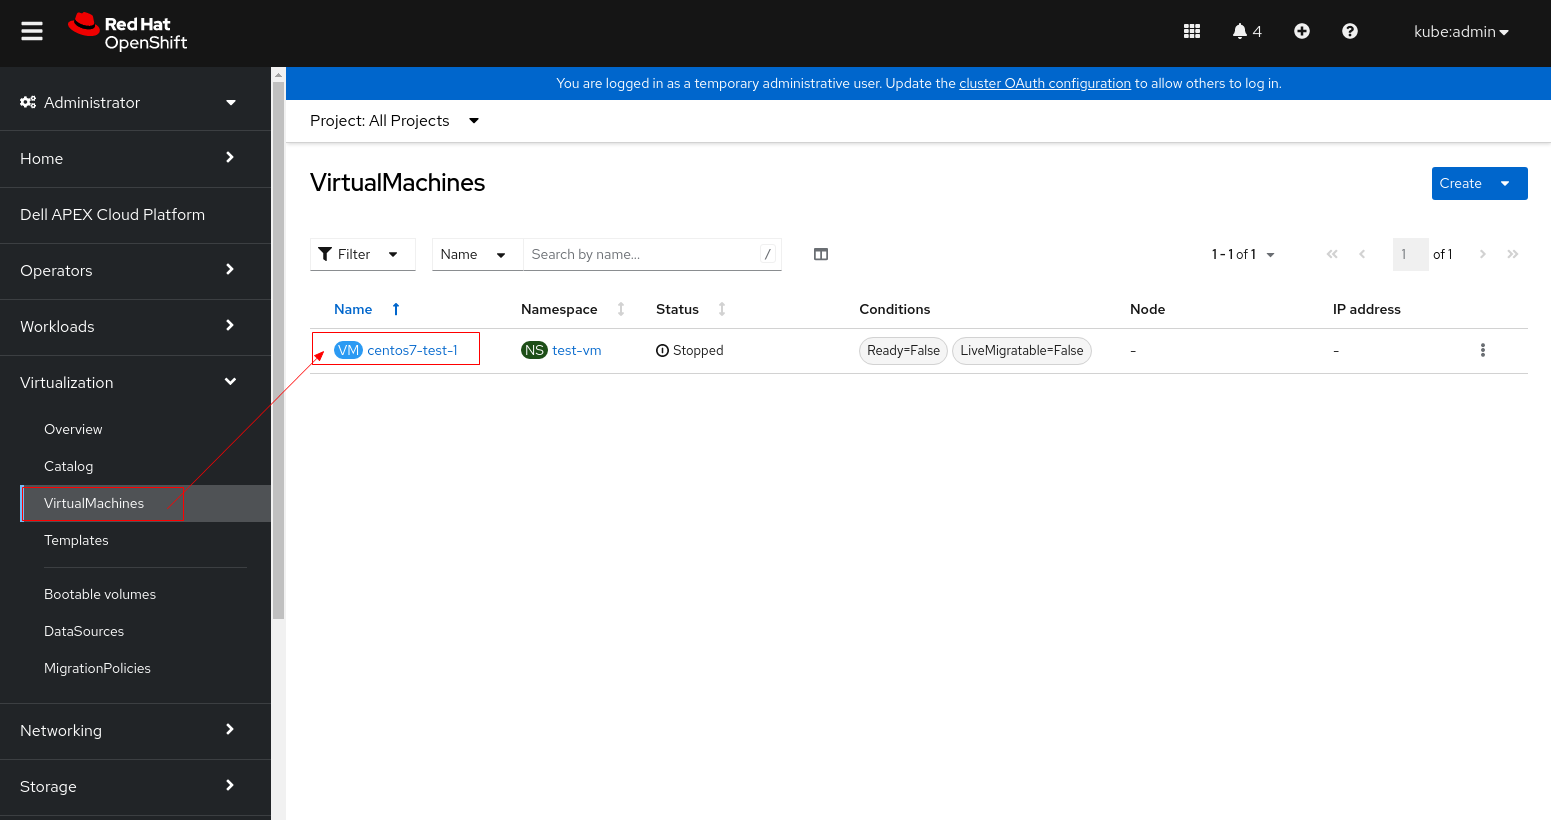
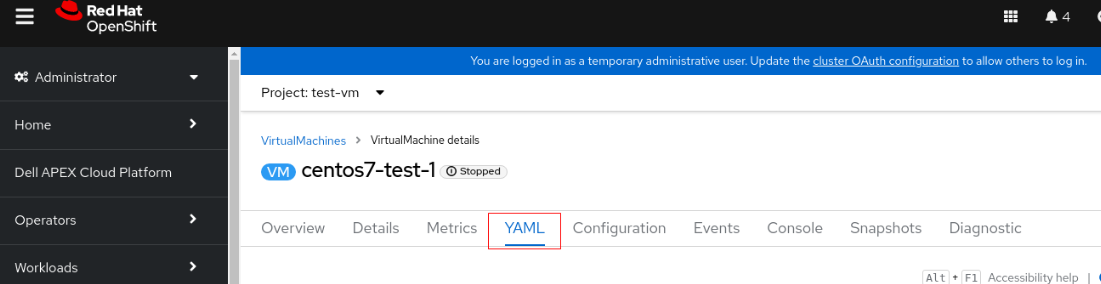
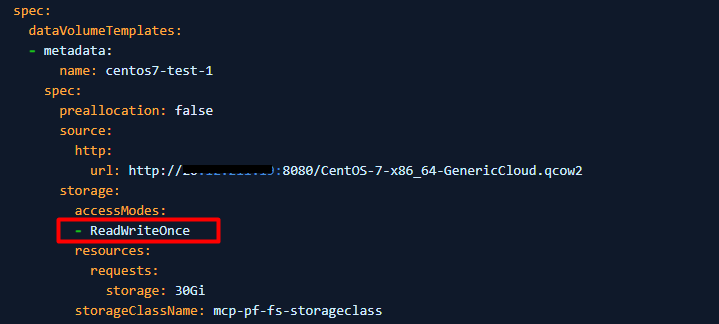
2.查找状态为“Ready,SchedulingDisabled”的节点。
3。清空节点以从中删除正在运行的 Pod。
4。设置调试模式并重新启动节点。
5.节点在重新启动后准备就绪后,将其标记为可计划。
6.验证节点是否已成功标记为可计划。
- 1.1在更改虚拟机实例的 PV 设置之前停止该虚拟机实例。
- 1.2 单击 VM 并切换到 YAML 选项卡
- 1.3 将 accessModes 从 “ReadWriteOnce” 更改为 “ReadWriteMany”
- 1.4 如果 PV 无法设置为 ReadWriteMany(虚拟机无法开始使用 ReadWriteMany),则将 LiveMigrate 的逐出策略设置为“无”
提醒:请执行适用于您的环境的步骤 1.3 或 1.4,不需要同时执行这两个步骤。
- 1.5 单击“保存”并重新启动虚拟机。
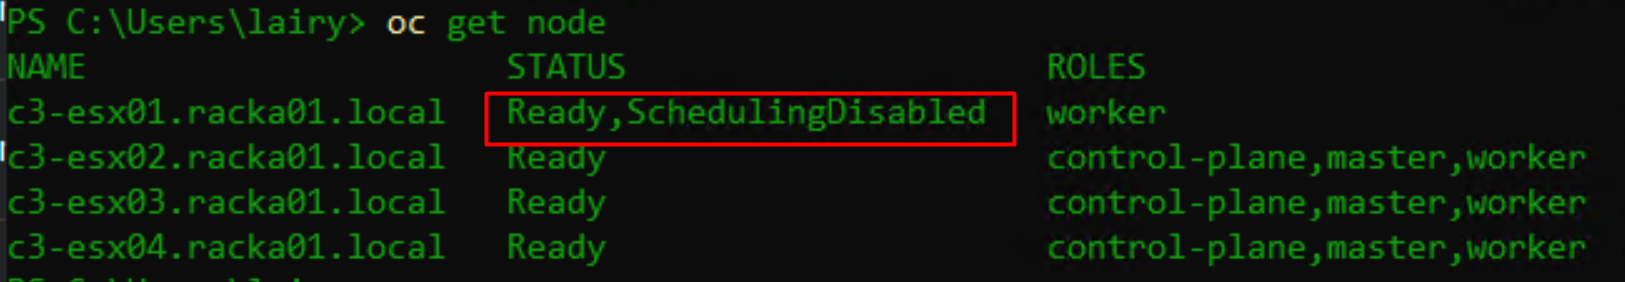
2.查找状态为“Ready,SchedulingDisabled”的节点。
$ oc get node例如:
3。清空节点以从中删除正在运行的 Pod。
$ oc adm <node name> --ignore-daemonsets --delete-emptydir-data --force例如:oc adm drain c3-esx01.racka01.local --ignore-daemonsets --delete-emptydir-data --force
4。设置调试模式并重新启动节点。
$ oc debug node/<node name>

$ sh-4.4# chroot /host

$ sh-4.4# systemctl reboot
5.节点在重新启动后准备就绪后,将其标记为可计划。
$ oc adm uncordon <node name>
6.验证节点是否已成功标记为可计划。
$ oc get node
受影响的产品
APEX Cloud Platform for Red Hat OpenShift文章属性
文章编号: 000216593
文章类型: Solution
上次修改时间: 18 9月 2026
版本: 4
从其他戴尔用户那里查找问题的答案
支持服务
检查您的设备是否在支持服务涵盖的范围内。