Openshift:在一个控制平面节点上执行重启后,群集无法正常运行
摘要: 一个控制平面节点非正常关闭,开机后,它将进入“未就绪”状态,导致群集无法运行。
本文适用于
本文不适用于
本文并非针对某种特定的产品。
本文并非包含所有产品版本。
症状
直接重启一个控制平面节点,节点启动后,群集不会恢复。
UI 页面将显示错误或空白信息,例如:
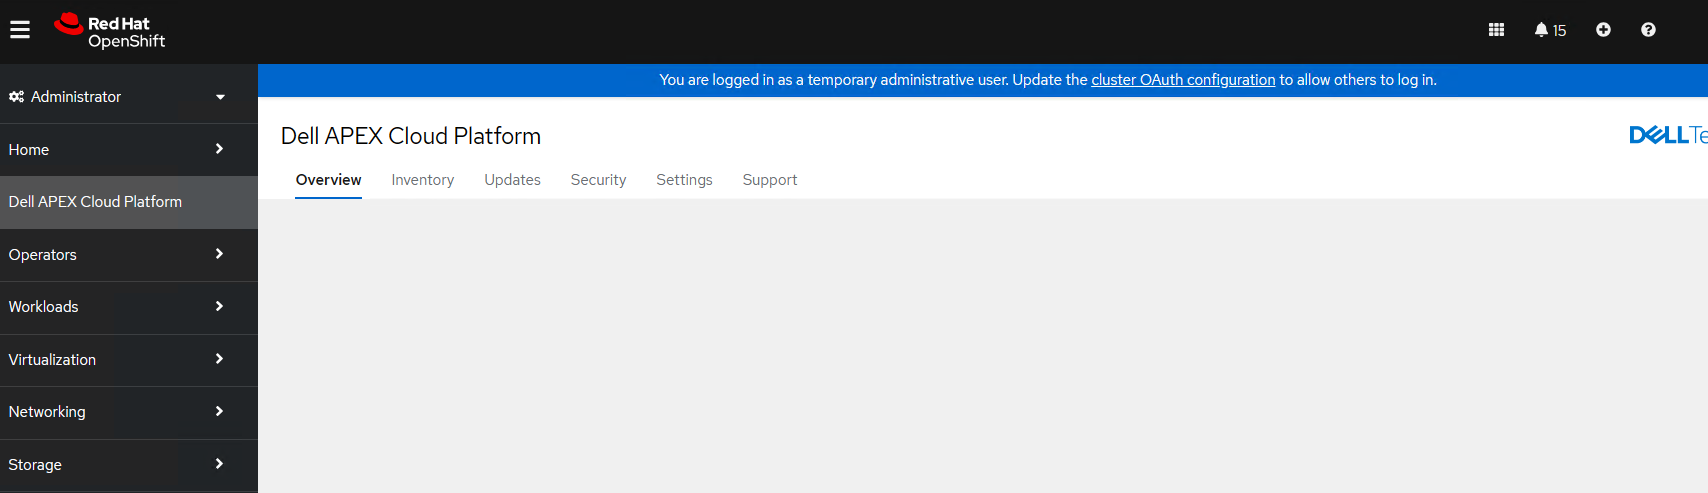
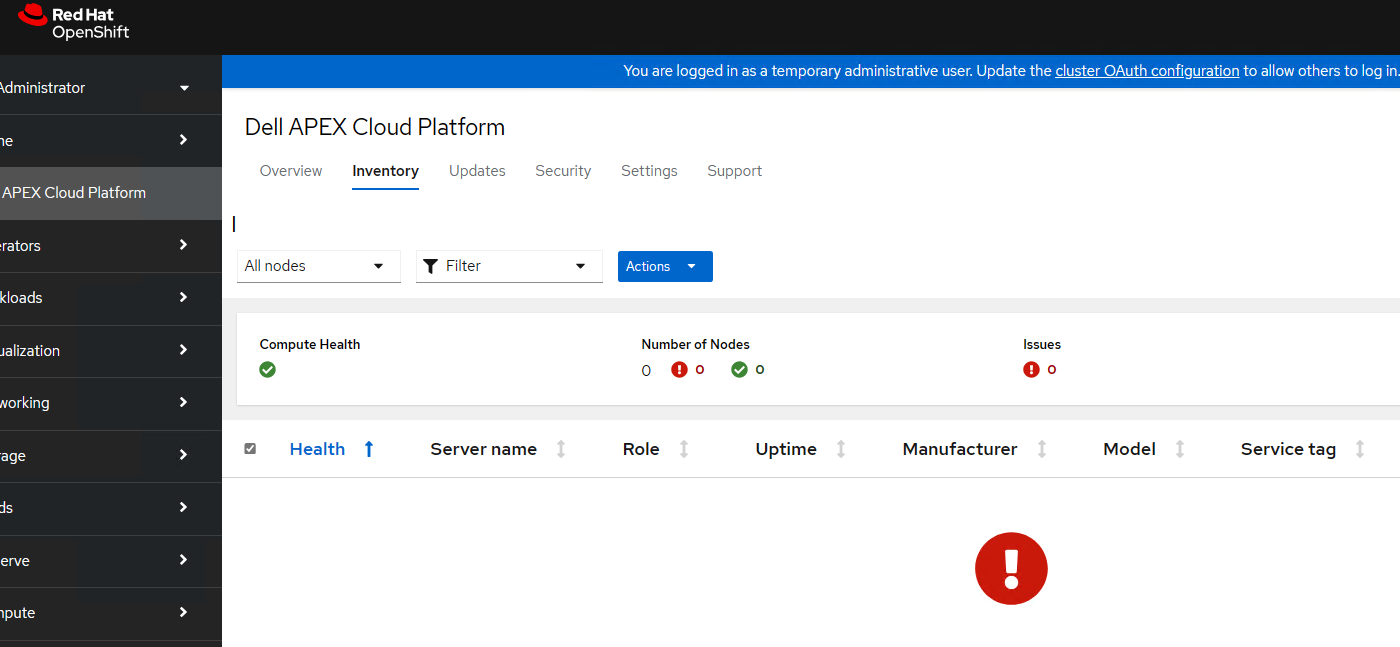
UI 页面将显示错误或空白信息,例如:
原因
不支持直接重启一个控制平面节点。这是一个灾难恢复情形。
当控制平面节点非正常关闭时,容器存储接口 (CSI) 驱动程序不会自动分离卷,这将导致 Pod 处于“Container Creating”状态。当控制平面节点在非正常关机后启动时,它将丢失任何 docker 映像本地高速缓存并尝试从 depo manager 检索,而在控制平面节点电源重启后,depo Manager Pod 未处于正在运行状态,因此控制平面节点将进入“未就绪”状态并导致群集无法运行。
当控制平面节点非正常关闭时,容器存储接口 (CSI) 驱动程序不会自动分离卷,这将导致 Pod 处于“Container Creating”状态。当控制平面节点在非正常关机后启动时,它将丢失任何 docker 映像本地高速缓存并尝试从 depo manager 检索,而在控制平面节点电源重启后,depo Manager Pod 未处于正在运行状态,因此控制平面节点将进入“未就绪”状态并导致群集无法运行。
解决方案
按照以下说明在节点非正常关闭后分离 CSI 卷。
1.检测到节点运行状况不佳后,关闭工作机节点。
2.通过运行以下命令并检查状态为“未就绪”,确保节点已关闭
3.通过运行以下命令,使相应的节点对象受到污染:
5.通过运行以下命令删除污点:
提醒:在上述命令中, <节点名称> = 非正常关闭节点的名称
1.检测到节点运行状况不佳后,关闭工作机节点。
2.通过运行以下命令并检查状态为“未就绪”,确保节点已关闭
oc get node <node name>重要提示:如果节点未完全关闭,请勿继续污染节点。如果节点仍处于正常运行状态并且应用了污点,则可能会发生文件系统损坏。
3.通过运行以下命令,使相应的节点对象受到污染:
oc adm taint node <node name> node.kubernetes.io/out-of-service=nodeshutdown:NoExecute4.重新启动节点。
5.通过运行以下命令删除污点:
oc adm taint node <node name> node.kubernetes.io/out-of-service-
提醒:在上述命令中, <节点名称> = 非正常关闭节点的名称
受影响的产品
APEX Cloud Platform for Red Hat OpenShift文章属性
文章编号: 000217678
文章类型: Solution
上次修改时间: 18 9月 2026
版本: 4
从其他戴尔用户那里查找问题的答案
支持服务
检查您的设备是否在支持服务涵盖的范围内。