OpenShift:由于静态 Pod 状态不佳,群集部署过程失败。
摘要: OpenShift Container Platform 问题导致群集部署失败,静态 Pod 状态更改为“已完成”。
本文适用于
本文不适用于
本文并非针对某种特定的产品。
本文并非包含所有产品版本。
症状
在群集部署过程中可能会观察到各种错误,包括但不限于以下情形:
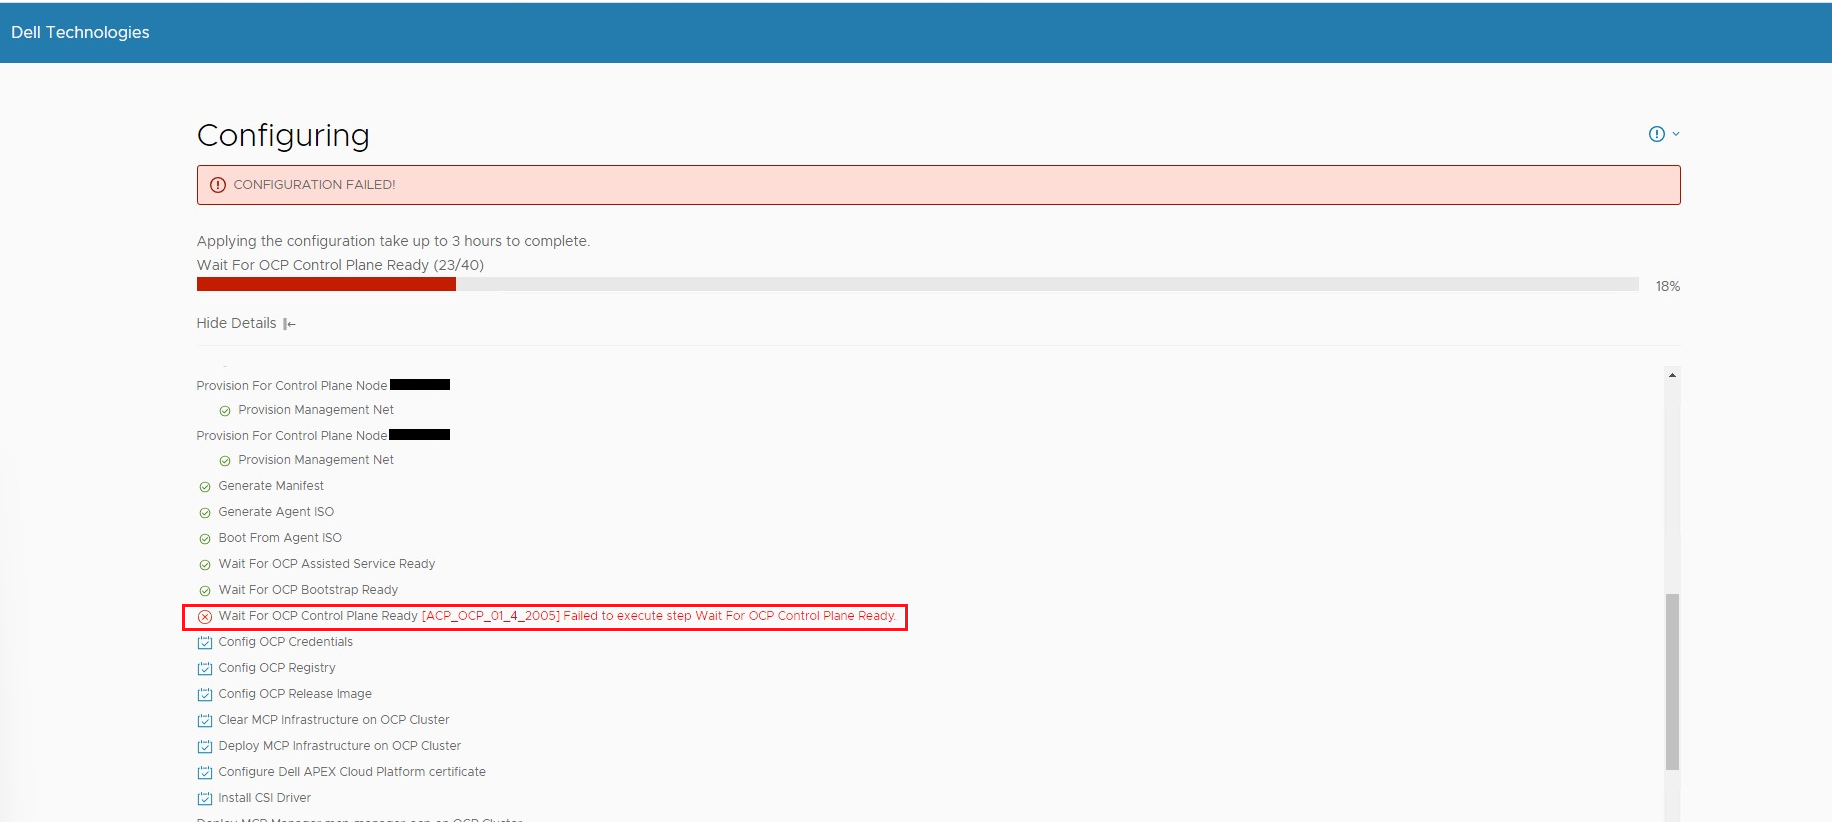
情景 1:群集部署配置过程失败,并显示错误“无法执行步骤,等待 OCP 控制平面就绪”
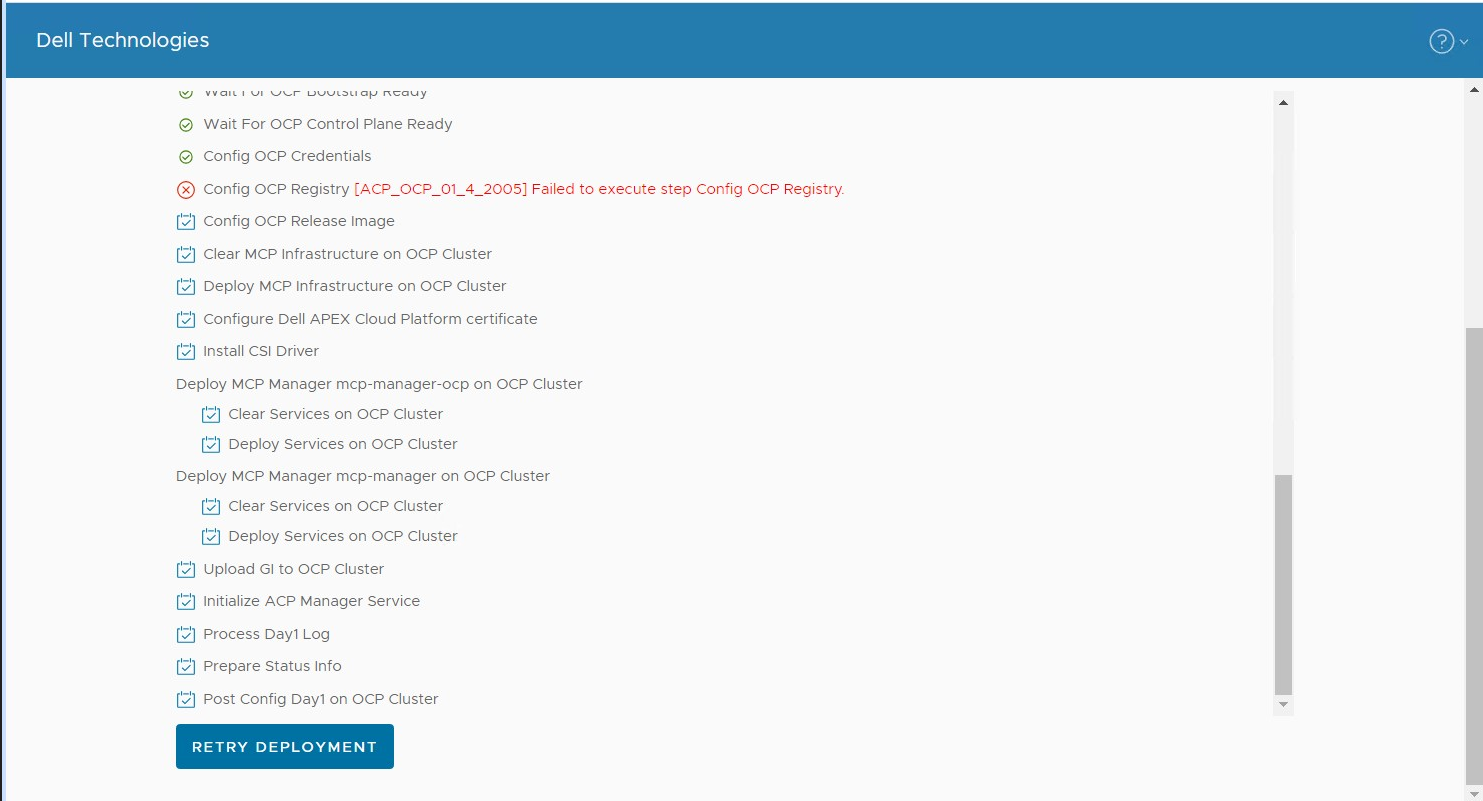
情景 2:群集部署配置过程失败,并显示错误“无法执行步骤配置 OCP 注册表”
命令返回“kube-scheduler is degraded”,例如:
或者返回“kube-controller-manager is degraded”,例如:
2.运行命令:
以 kube-controller-manager 降级为例,命令显示一个 kube-controller-manager 已降级,并显示消息“GuardControllerDegraded:节点上缺少操作数”
情景 1:群集部署配置过程失败,并显示错误“无法执行步骤,等待 OCP 控制平面就绪”
情景 2:群集部署配置过程失败,并显示错误“无法执行步骤配置 OCP 注册表”
通过 SSH 登录主节点(默认凭据为 root/Passw0rd!),运行以下命令以检查 clusterversion、clusteroperator 和静态 pod 状态。
1.运行命令:kubectl --kubeconfig="/usr/share/mcp_ocp/pv/mcp-installer-ocp/auth/kubeconfig" get clusterversion
命令返回“kube-scheduler is degraded”,例如:
| NAME VERSION AVAILABLE PROGRESSING SINCE STATUS
version False False 5h4m 调整 4.13.12 时出错:集群操作员 kube-scheduler 已降级 |
或者返回“kube-controller-manager is degraded”,例如:
| NAME VERSION AVAILABLE PROGRESSING SINCE
version False False 5h4m 调整 4.13.12 时出错:集群操作员 kube-controller-manager 已降级 |
2.运行命令:
kubectl --kubeconfig="/usr/share/mcp_ocp/pv/mcp-installer-ocp/auth/kubeconfig" get co
以 kube-controller-manager 降级为例,命令显示一个 kube-controller-manager 已降级,并显示消息“GuardControllerDegraded:节点上缺少操作数”
|
NAME VERSION AVAILABLE, PROGRESSING DEGRADED SINCE MESSAGE ...... kube-controller-manager 4.13.12 True True True 4d7h GuardControllerDegraded:[Missing operand on node h01-compute-02.p82.local, Missing operand on node h01-01-compute-03.p82.local]... ...... machine-config 4.13.12 True False True 4d7h Failed to resync 4.13.12 because: error during syncRequiredMachineConfigPools:[等待条件超时,出错池主服务器未就绪,正在重试。Status:(pool degraded: true total:3, ready 1, updated:1, unavailable:2)] |
3.运行命令:
kubectl --kubeconfig="/usr/share/mcp_ocp/pv/mcp-installer-ocp/auth/kubeconfig" get pods -A | grep kube-controller-manager
以 kube-controller-manager 降级为例,命令显示一个 kube-controller-manager 为 0/1
|
NAME READY STATUS RESTARTS AGE installer-4-h01-01-compute-03.p82.local 0/1 Completed 0 4d7h installer-4-h01-01-compute-04.p82.local 0/1 Completed 0 4d7h installer-5-h01-01-compute-03.p82.local 0/1 Completed 0 4d7h installer-5-h01-01-compute-04.p82.local 0/1 Completed 0 4d7h installer-6-h01-01-compute-03.p82.local 0/1 Completed 0 4d7h kube-controller-manager-guard-h01-01-compute-03.p82.local 0/1 Running 0 4d7h kube-controller-manager-guard-h01-01-compute-04.p82.local 1/1 Running 0 4d7h kube-controller-manager-h01-01-compute-04.p82.local 4/4 Running 0 4d7h |
原因
这是 OCP 4.10、4.11、4.12 和 4.13 的已知问题。
根本原因是 Kubernetes 无法删除某些 Pod,并导致某些服务运行进入不正常状态。
根本原因是 Kubernetes 无法删除某些 Pod,并导致某些服务运行进入不正常状态。
解决方案
此问题将在未来的 OCP 版本中得到修复。
对于受影响的 OCP 版本,请按照以下步骤解决此问题:
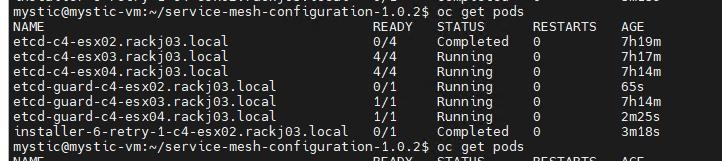
通过 SSH 登录到标识的节点,在上面的示例中标识的节点名称是“c4-esx02.rackj03.local”。
1.保存与您在群集部署向导网页上生成的 ssh 公钥对应的私钥。
例如:
运行命令: ssh-keygen -t ecdsa -b 521
运行命令: ssh-keygen -t ecdsa -b 521
- 输入要保存密钥的文件名,或者使用默认值。
- 输入密码或使用默认值。
命令输出如下所示:
您的身份证明已保存在 /root/.ssh/id_ecdsa
您的公钥已保存在 /root/.ssh/id_ecdsa.pub 中
您的公钥已保存在 /root/.ssh/id_ecdsa.pub 中
在此示例中,“/root/.ssh/id_ecdsa”是私钥文件,它将在下一个命令中使用。
2.运行命令:ssh -l core <node name-i <> private_key_file>
3.运行命令: sudo systemctl restart kubelet
4。从向导网页重试群集部署过程
受影响的产品
APEX Cloud Platform for Red Hat OpenShift文章属性
文章编号: 000218328
文章类型: Solution
上次修改时间: 18 9月 2026
版本: 5
从其他戴尔用户那里查找问题的答案
支持服务
检查您的设备是否在支持服务涵盖的范围内。