OpenShift:叢集部署程序失敗,因為靜態 Pod 狀態不正常。
摘要: OpenShift 容器平台問題導致叢集部署失敗,靜態 Pod 狀態變更為已完成。
本文章適用於
本文章不適用於
本文無關於任何特定產品。
本文未識別所有產品版本。
症狀
在叢集部署過程中可能會發現各種錯誤,包括但不限於以下情況:
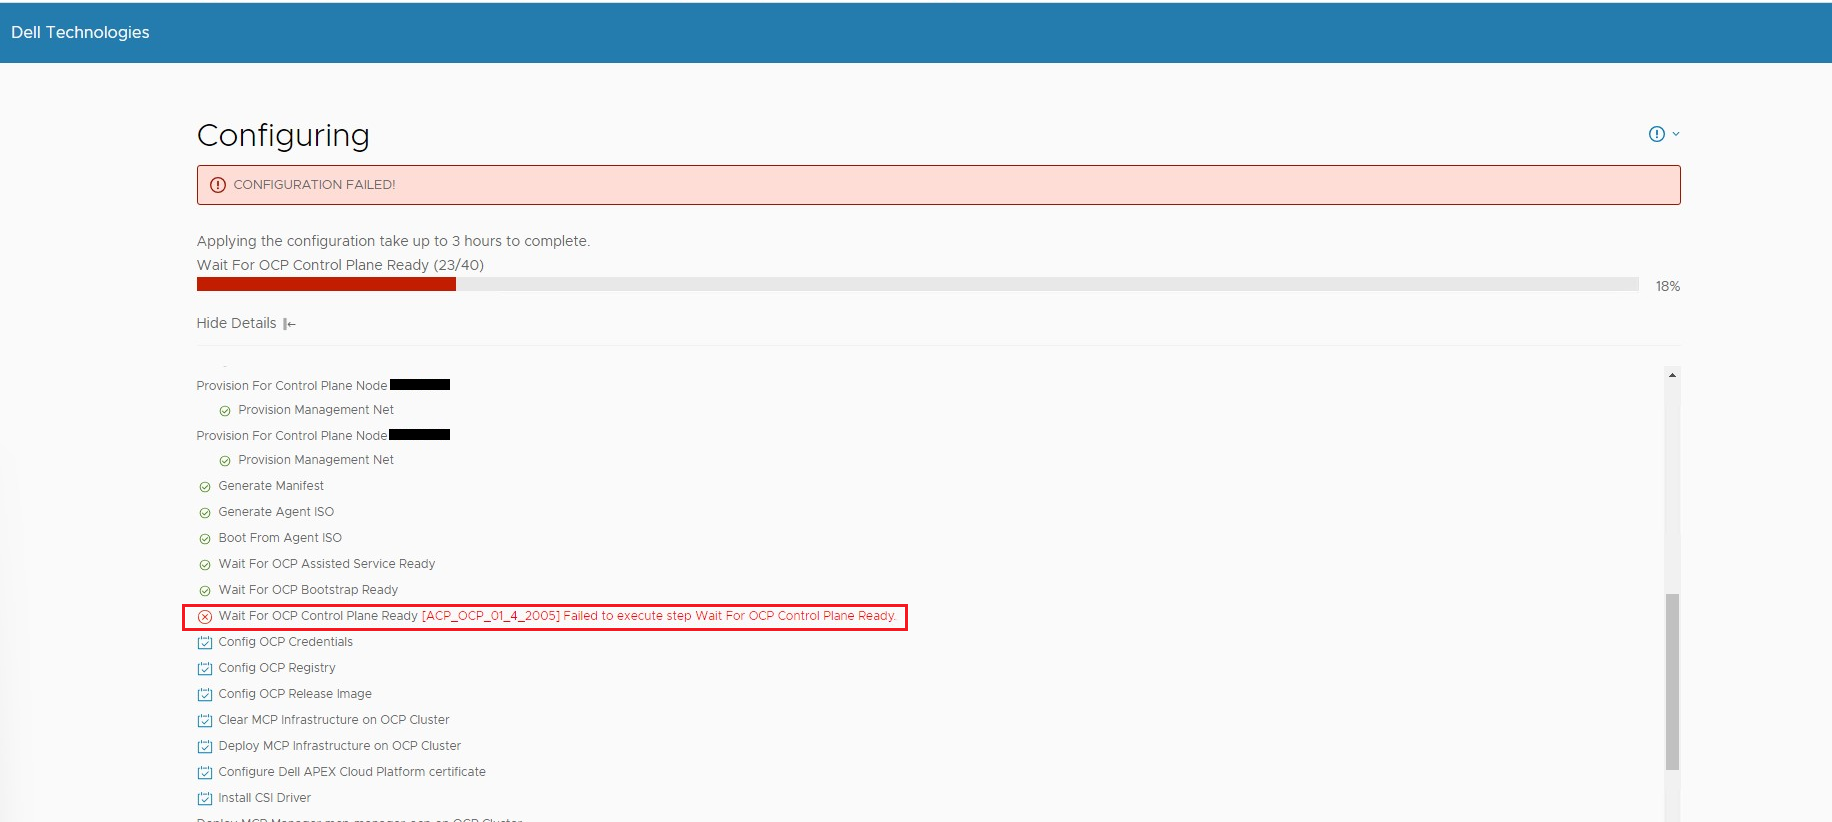
案例 1:叢集部署組態程序失敗,並顯示錯誤「無法執行步驟等待 OCP 控制平面就緒」
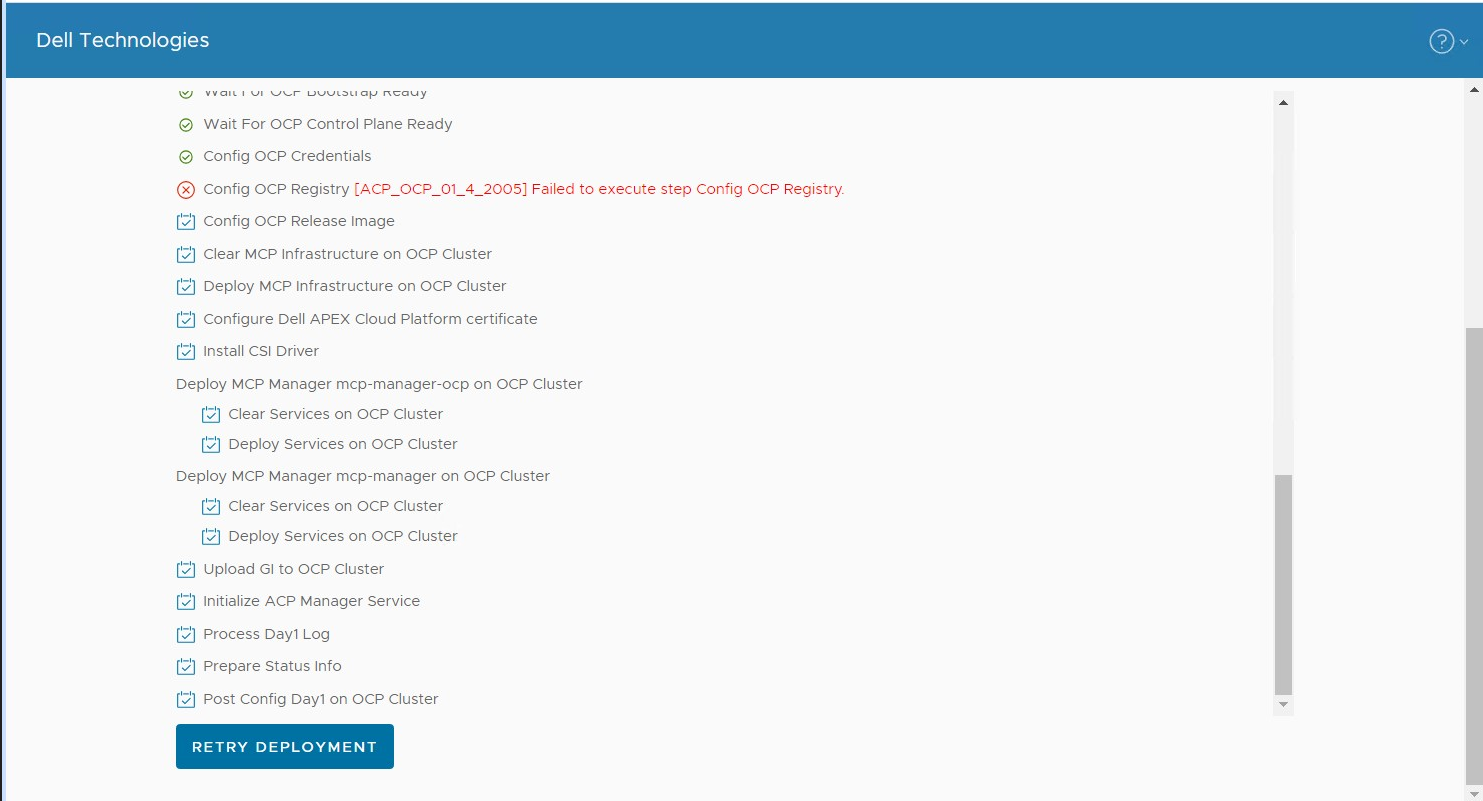
案例 2:叢集部署組態程序失敗,錯誤訊息「無法執行步驟 Config OCP Registry」
命令傳回「kube-scheduler is degraded」,例如:
或者它返回「kube-controller-manager is degraded」,例如:
2.執行命令:
將 kube-controller-manager 降級例如,命令顯示一個 kube-controller-manager 降級,並顯示訊息「GuardControllerDegraded:節點上缺少操作數”
案例 1:叢集部署組態程序失敗,並顯示錯誤「無法執行步驟等待 OCP 控制平面就緒」
案例 2:叢集部署組態程序失敗,錯誤訊息「無法執行步驟 Config OCP Registry」
透過 SSH 登入主要節點 (預設登入資料為 root/Passw0rd!),執行以下命令以檢查叢集版本、clusteroperator 和靜態 pod 狀態。
1.執行命令:kubectl --kubeconfig="/usr/share/mcp_ocp/pv/mcp-installer-ocp/auth/kubeconfig" get clusterversion
命令傳回「kube-scheduler is degraded」,例如:
| 名稱版本 可用 進行開始於狀態
版本 False 5h4m 協調時發生錯誤 4.13.12: 叢集操作員 kube-scheduler 降級 |
或者它返回「kube-controller-manager is degraded」,例如:
| 名稱版本 可用 正在進行「開始於狀態
」版本 False 5h4m 協調 4.13.12 時發生錯誤:叢集操作員 kube-controller-manager 降級 |
2.執行命令:
kubectl --kubeconfig="/usr/share/mcp_ocp/pv/mcp-installer-ocp/auth/kubeconfig" get co
將 kube-controller-manager 降級例如,命令顯示一個 kube-controller-manager 降級,並顯示訊息「GuardControllerDegraded:節點上缺少操作數”
|
可用名稱版本 進度 降級至今訊息 ...... kube-controller-manager 4.13.12 True True True 4d7h GuardControllerDegraded:[節點 h01-01-compute-02.p82.local 上缺少操作數,節點 h01-01-compute-03.p82.local 上缺少操作數]... ...... 機器組態 4.13.12 True False True 4D7h 無法重新同步 4.13.12,因為: syncRequiredMachineConfigPools 期間發生錯誤:[等待狀況逾時,錯誤集區主機尚未就緒,正在重試。狀態:(池已降級:True 總計:3、就緒 1、已更新:1、無法使用:2)] |
3.執行命令:
kubectl --kubeconfig="/usr/share/mcp_ocp/pv/mcp-installer-ocp/auth/kubeconfig" get pods -A | grep kube-controller-manager
以 kube-controller-manager 降級為例,命令顯示一個 kube-controller-manager 為 0/1
|
名稱就緒狀態重新起始期限 安裝程式-4-H01-01-compute-03.p82.local 0/1 已完成 0 4d7h 安裝程式-4-H01-01-compute-04.p82.local 0/1 已完成 0 4d7h 安裝程式-5-H01-01-compute-03.p82.local 0/1 已完成 0 4d7h 安裝程式-5-H01-01-compute-04.p82.local 0/1 已完成 0 4d7h 安裝程式-6-H01-01-compute-03.p82.local 0/1 已完成 0 4d7h kube-controller-manager-guard-h01-01-compute-03.p82.local 0/1 執行 0 4d7h kube-controller-manager-guard-h01-01-compute-04.p82.local 1/1 執行 0 4d7h kube-controller-manager-h01-01-compute-04.p82.local 4/4 執行 0 4d7h |
原因
這是 OCP 4.10、4.11、4.12 和 4.13 的已知問題。
根本原因是 Kubernetes 無法刪除某些 Pod,並導致某些服務運行到不正常狀態。
根本原因是 Kubernetes 無法刪除某些 Pod,並導致某些服務運行到不正常狀態。
解析度
此問題將於未來的 OCP 版本中修正。
針對受影響的 OCP 版本,請遵循以下步驟解決問題:
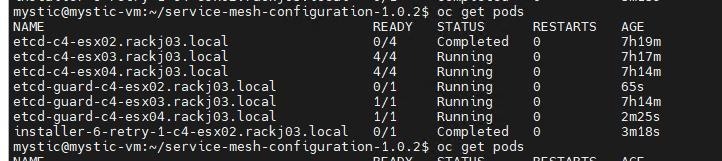
SSH 登入已識別的節點,在上述範例中,已識別的節點名稱為「c4-esx02.rackj03.local」。
1.儲存與您在叢集部署精靈網頁上產生的 ssh 公開金鑰對應的私密金鑰。
例如:
執行命令: ssh-keygen -t ecdsa -b 521
執行命令: ssh-keygen -t ecdsa -b 521
- 輸入要保存金鑰的檔名或使用預設值。
- 輸入密碼片語或使用預設值。
命令輸出如下:
您的身分已儲存在 /root/.ssh/id_ecdsa
您的公開金鑰已儲存在 /root/.ssh/id_ecdsa.pub 中
您的公開金鑰已儲存在 /root/.ssh/id_ecdsa.pub 中
在此範例中,「/root/.ssh/id_ecdsa」是私密金鑰檔案,將在下一個命令中使用。
2.執行命令: ssh -l core <node name> -i <private_key_file>
3.執行命令: sudo systemctl restart kubelet
4.從精靈網頁重試叢集部署程序
受影響的產品
APEX Cloud Platform for Red Hat OpenShift文章屬性
文章編號: 000218328
文章類型: Solution
上次修改時間: 18 9月 2026
版本: 5
向其他 Dell 使用者尋求您問題的答案
支援服務
檢查您的裝置是否在支援服務的涵蓋範圍內。