Openshift: OCP-Upgrade-Nachprüfungsfehler für Node nicht bereit oder Planung deaktiviert
Summary: OCP-Upgrade-Nachprüfungsfehler für Node nicht bereit oder Planung deaktiviert, da die VM mit ReadWriteOnce(RWO)-Storage-Volume konfiguriert ist und nicht live migriert werden kann.
Acest articol se aplică pentru
Acest articol nu se aplică pentru
Acest articol nu este legat de un produs specific.
Acest articol nu acoperă toate versiunile de produs existente.
Symptoms
Während des OCP-Upgrade-Nachprüfungsprozesses kann die Fehlermeldung "Nachprüfung für OCP-Cluster konnte nicht ausgeführt werden. Der Node ist nicht bereit oder die Planung ist deaktiviert."
Cause
Eine oder mehrere VMs, die mit ReadWriteOnce(RWO)-Speicher-Volume konfiguriert sind und nicht live auf den Fehlerberichts-Node migriert werden können.
Weitere Informationen zu Storage-Volumes für VM-Festplatten finden Sie im folgenden Openshift-Dokument.
Resolution
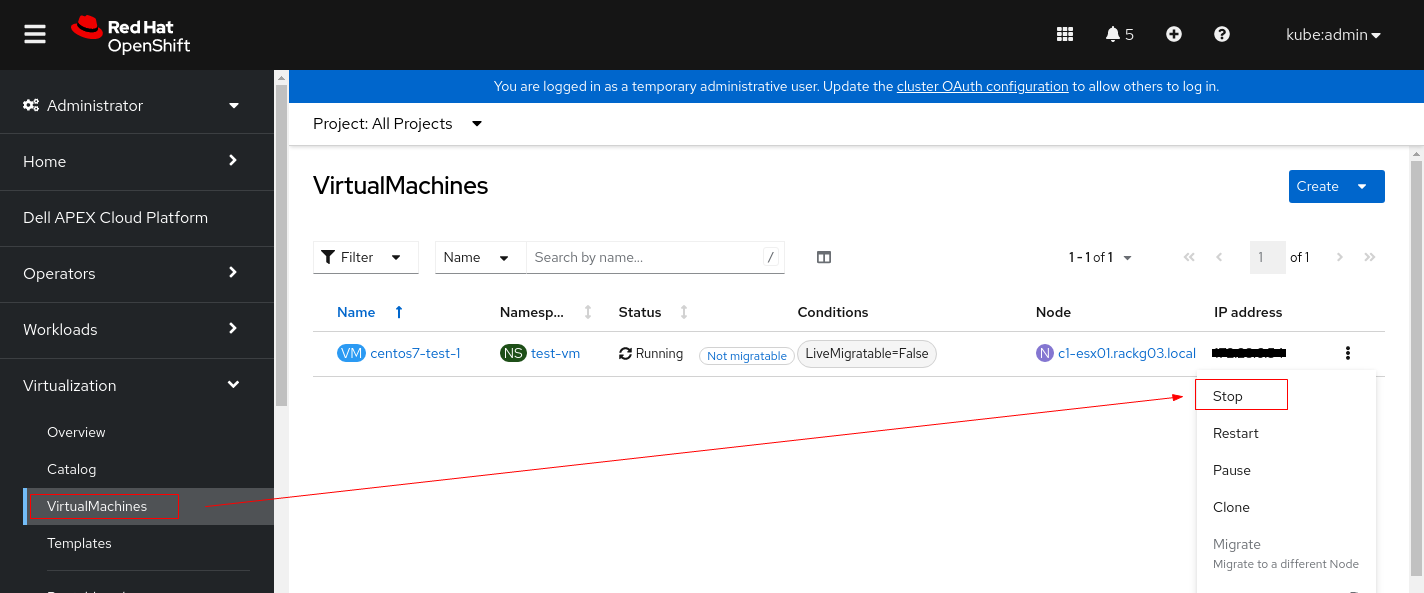
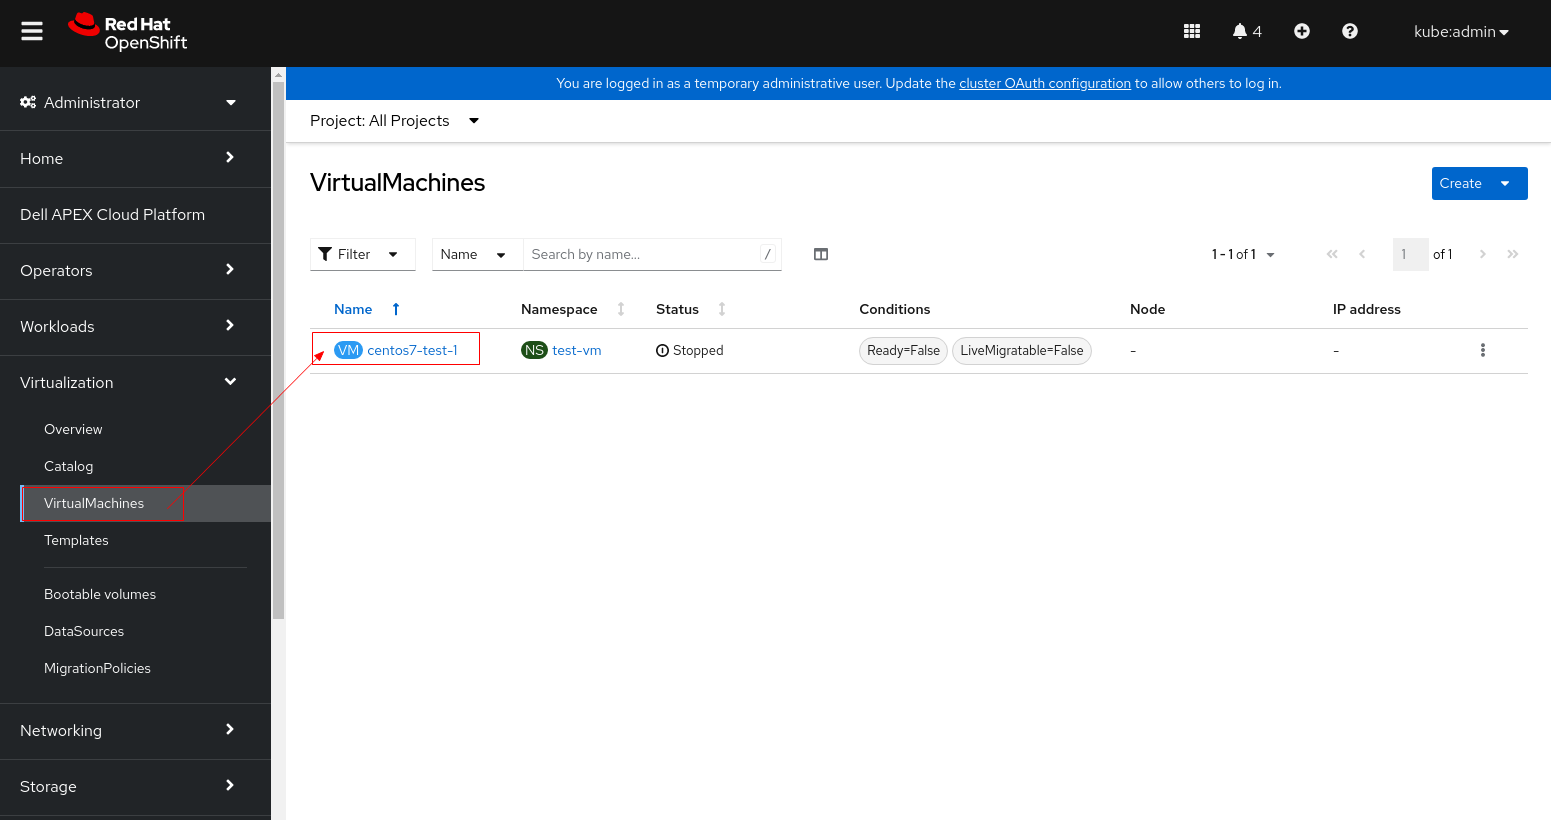
1. Ändern Sie die VM-PV-Einstellungen.
2. Suchen Sie die Nodes, deren Status "Ready,SchedulingDisabled" ist.
3. Entladen Sie den Node, um ausgeführte Pods daraus zu entfernen.
4. Stellen Sie den Debug-Modus ein und starten Sie den Node neu.
5. Sobald der Node nach dem Neustart bereit ist, markieren Sie ihn als planbar.
6. Überprüfen Sie, ob der Node erfolgreich als schedulable markiert wurde.
- 1.1Beenden Sie die VM-Instanz, bevor Sie ihre PV-Einstellungen ändern.
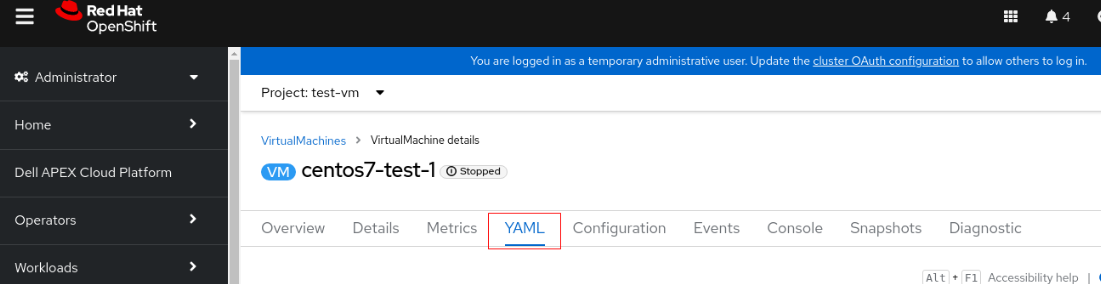
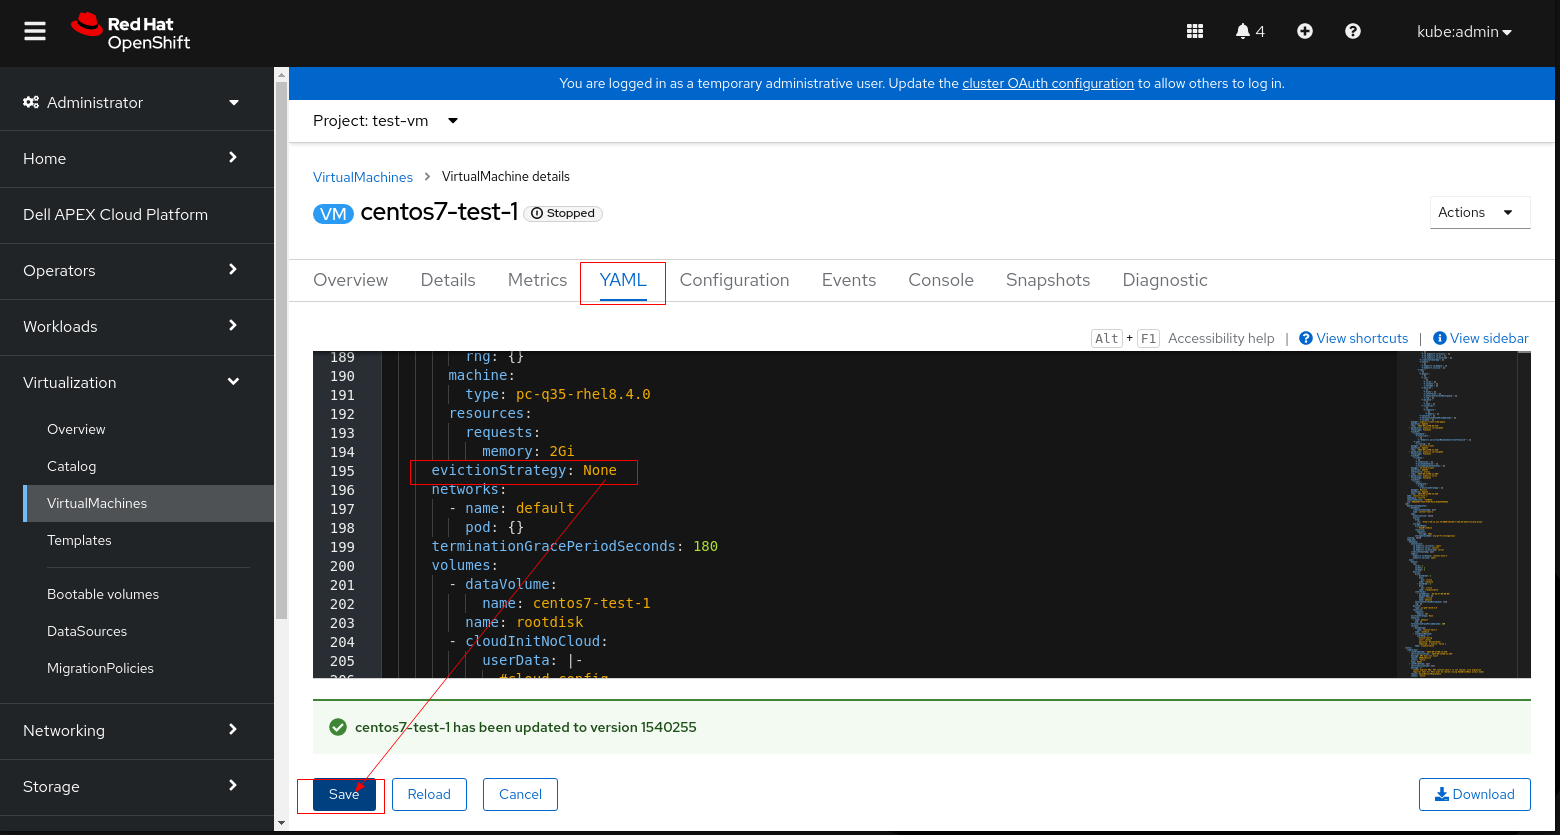
- 1.2 Klicken Sie auf die VM und wechseln Sie zur Registerkarte YAML
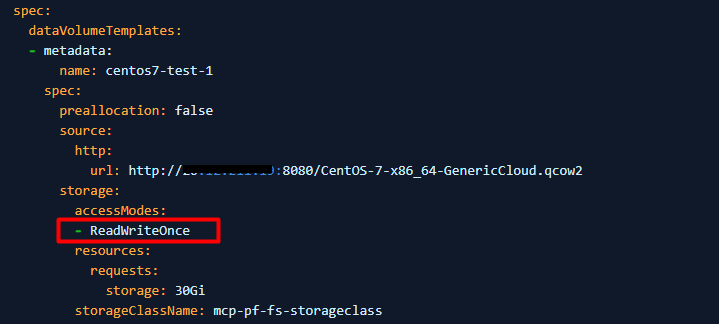
- 1.3 Ändern der accessModes von "ReadWriteOnce" in "ReadWriteMany"
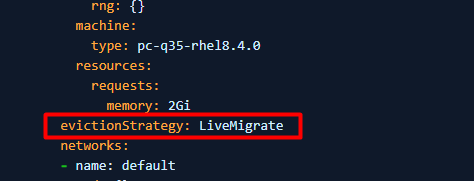
- 1.4 Wenn PV nicht auf "ReadWriteMany" festgelegt werden kann (die VM kann nicht mit "ReadWriteMany" beginnen), legen Sie "evictionStrategy" von LiveMigrate auf "None" fest
Hinweis: Führen Sie entweder Schritt 1.3 oder 1.4 aus, der auf Ihre Umgebung zutrifft. Sie müssen nicht beide Schritte ausführen.
- 1.5 Klicken Sie auf "Save" und starten Sie die VM neu.
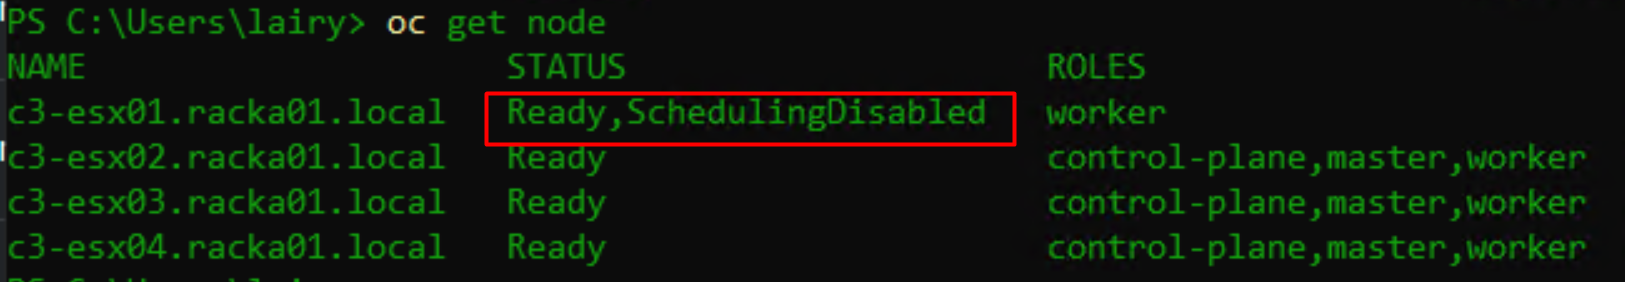
2. Suchen Sie die Nodes, deren Status "Ready,SchedulingDisabled" ist.
$ oc get nodeBeispiel:
3. Entladen Sie den Node, um ausgeführte Pods daraus zu entfernen.
$ oc adm <node name> --ignore-daemonsets --delete-emptydir-data --forceBeispiel: oc adm drain c3-esx01.racka01.local --ignore-daemonsets --delete-emptydir-data --force
4. Stellen Sie den Debug-Modus ein und starten Sie den Node neu.
$ oc debug node/<node name>

$ sh-4.4# chroot /host

$ sh-4.4# systemctl reboot
5. Sobald der Node nach dem Neustart bereit ist, markieren Sie ihn als planbar.
$ oc adm uncordon <node name>
6. Überprüfen Sie, ob der Node erfolgreich als schedulable markiert wurde.
$ oc get node
Produse afectate
APEX Cloud Platform for Red Hat OpenShiftProprietăți articol
Article Number: 000216593
Article Type: Solution
Ultima modificare: 18 sept. 2026
Version: 4
Găsiți răspunsuri la întrebările dvs. de la alți utilizatori Dell
Servicii de asistență
Verificați dacă dispozitivul dvs. este acoperit de serviciile de asistență.