Openshift: Błąd sprawdzania po uaktualnieniu OCP pod kątem braku gotowości węzła lub wyłączonego planowania
Summary: Błąd uaktualnienia OCP po sprawdzeniu pod kątem braku gotowości węzła lub wyłączonego planowania z powodu maszyny wirtualnej skonfigurowanej z woluminem pamięci masowej ReadWriteOnce (RWO), którego nie można migrować na żywo. ...
Acest articol se aplică pentru
Acest articol nu se aplică pentru
Acest articol nu este legat de un produs specific.
Acest articol nu acoperă toate versiunile de produs existente.
Symptoms
Podczas procesu aktualizacji OCP po sprawdzeniu może pojawić się komunikat o błędzie "Nie udało się uruchomić kontroli końcowej klastra OCP. Węzeł nie jest gotowy lub planowanie jest wyłączone".
Cause
Co najmniej jedna maszyna wirtualna skonfigurowana z woluminem pamięci masowej ReadWriteOnce (RWO), której nie można migrować na żywo w węźle raportowania błędów.
Sprawdź poniższy dokument Openshift, aby uzyskać więcej informacji na temat woluminów pamięci masowej dla dysków maszyn wirtualnych.
Resolution
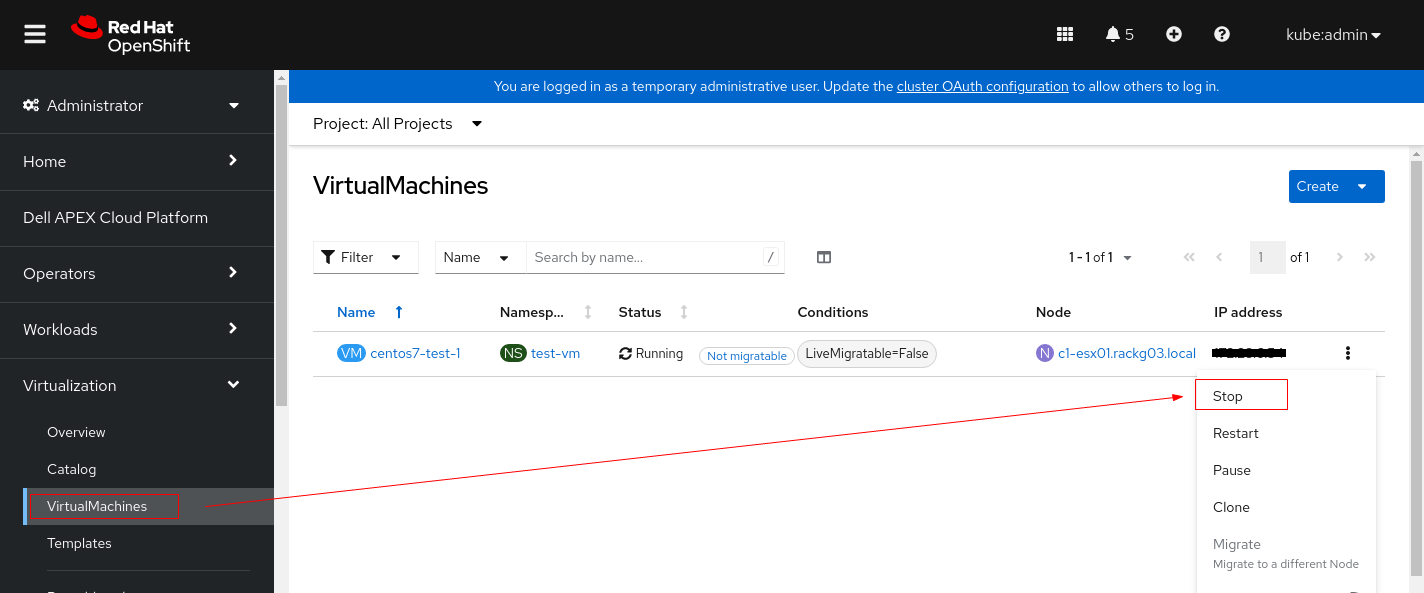
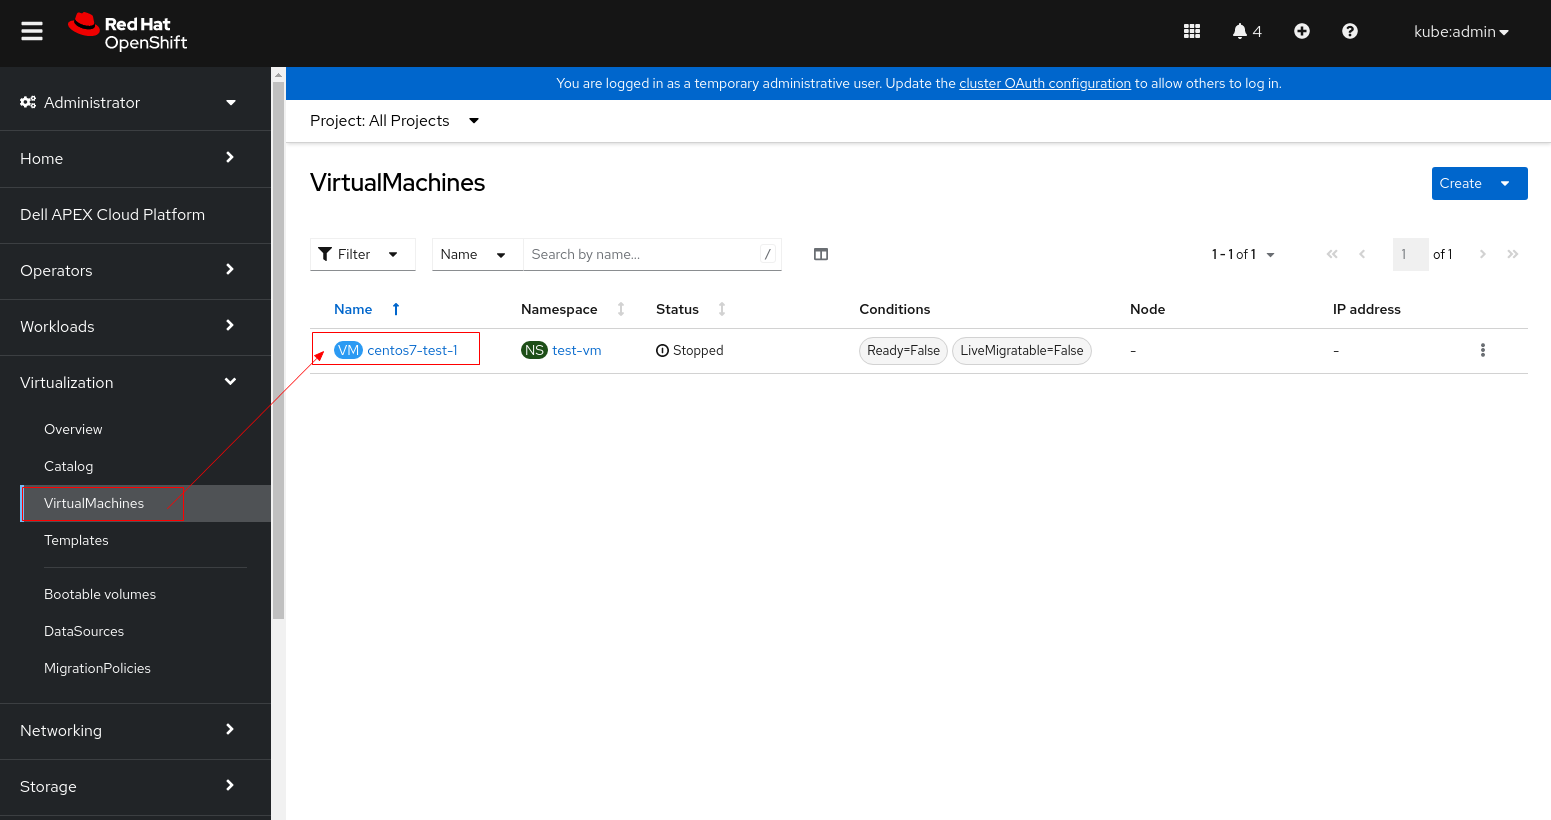
1. Zmień ustawienia PV maszyny wirtualnej.
2. Znajdź węzły, których stan to "Ready,SchedulingDisabled".
3. Rozładuj węzeł, aby usunąć z niego uruchomione zasobniki.
4. Ustaw tryb debugowania i uruchom ponownie węzeł.
5. Gdy węzeł będzie gotowy po ponownym uruchomieniu, oznacz go jako możliwy do zaplanowania.
6. Sprawdź, czy węzeł został pomyślnie oznaczony jako możliwy do zaplanowania.
- 1.1zatrzymaj wystąpienie maszyny wirtualnej przed zmianą jego ustawień PV.
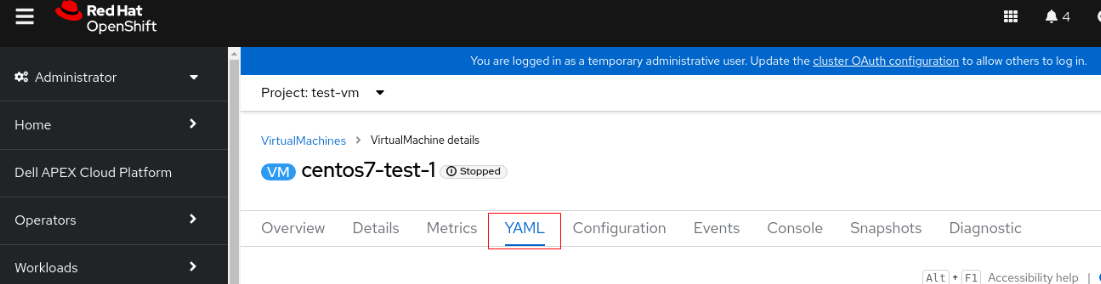
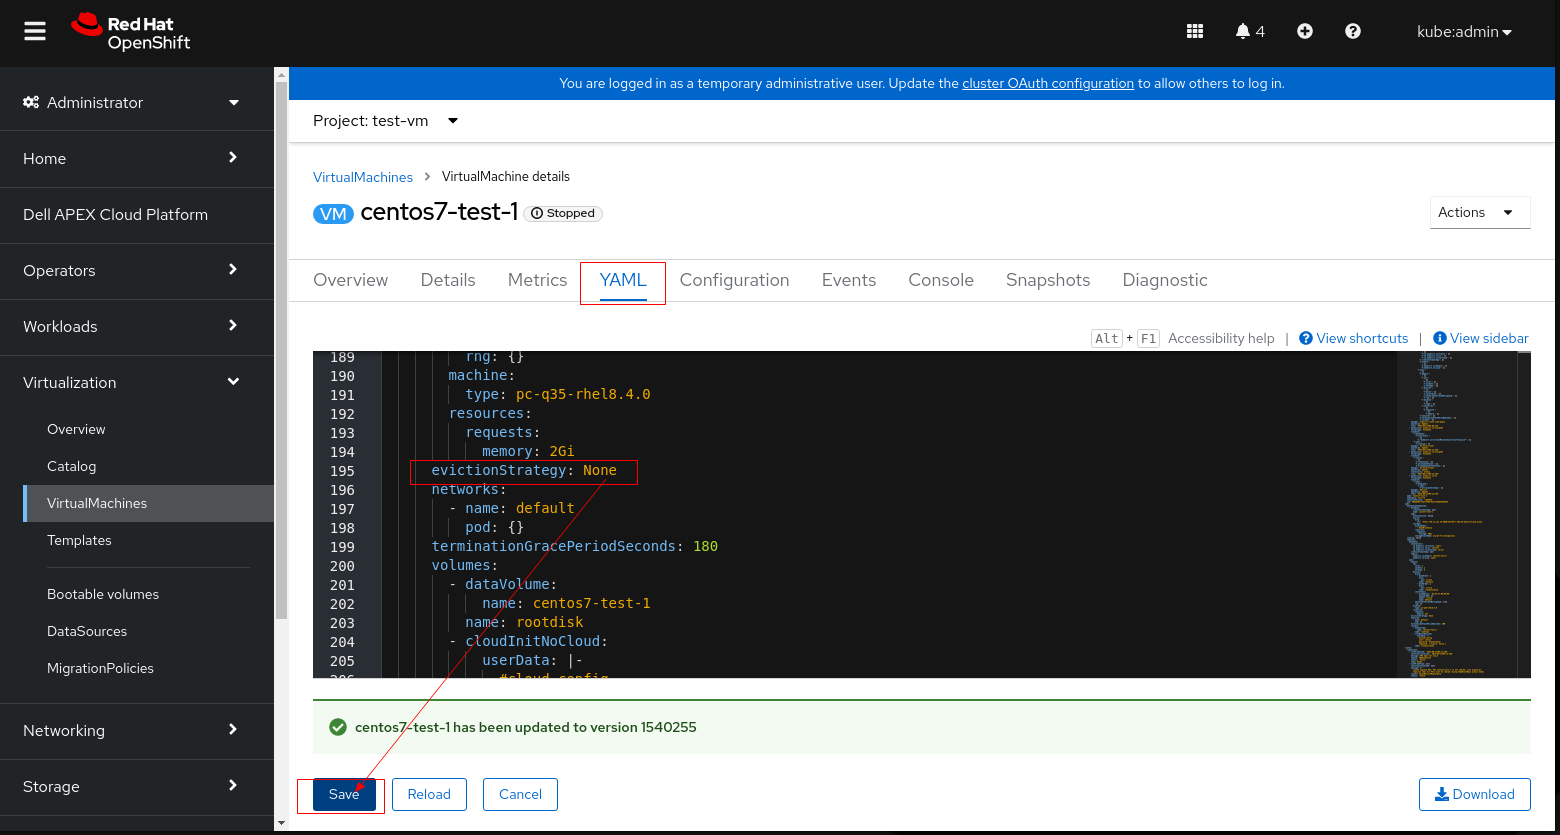
- 1.2 Kliknij maszynę wirtualną i przejdź do karty YAML
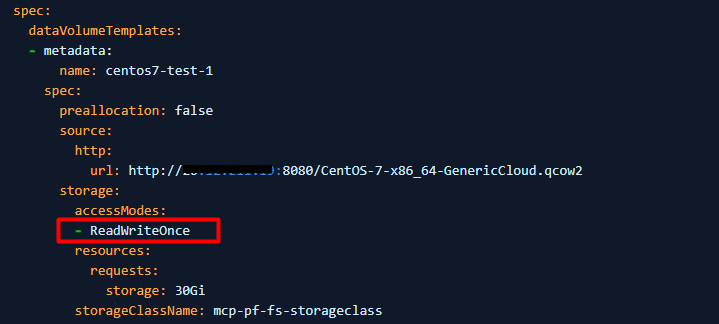
- 1.3 Zmień accessModes z "ReadWriteOnce" na "ReadWriteMany"
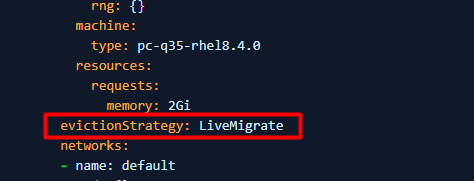
- 1.4 Jeśli PV nie można ustawić na ReadWriteMany (maszyna wirtualna nie może uruchomić użycia ReadWriteMany), ustaw wartość evictionStrategy z LiveMigrate na None
Uwaga: Wykonaj krok 1.3 lub 1.4, który dotyczy Twojego środowiska, nie musisz wykonywać obu kroków.
- 1.5. Kliknij przycisk Save i uruchom ponownie maszynę wirtualną.
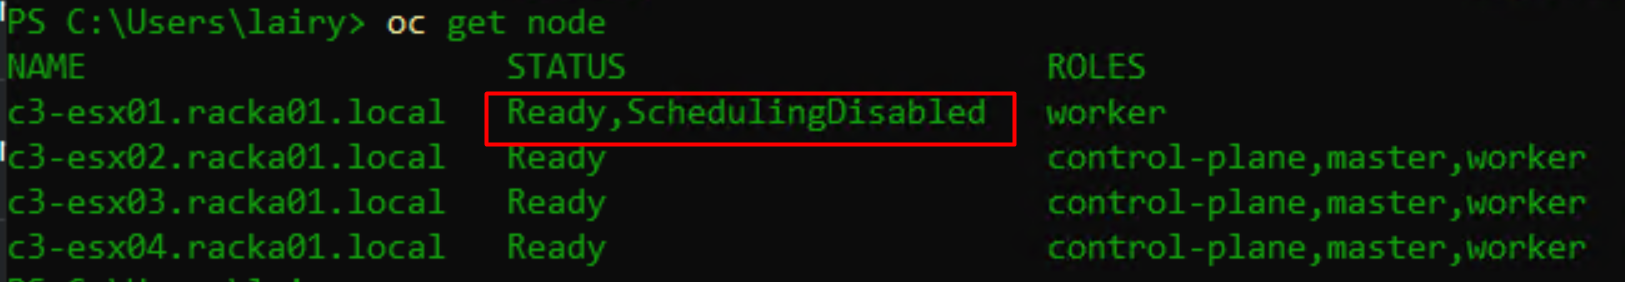
2. Znajdź węzły, których stan to "Ready,SchedulingDisabled".
$ oc get nodeNa przykład:
3. Rozładuj węzeł, aby usunąć z niego uruchomione zasobniki.
$ oc adm <node name> --ignore-daemonsets --delete-emptydir-data --forceNa przykład: oc adm drain c3-esx01.racka01.local --ignore-daemonsets --delete-emptydir-data --force
4. Ustaw tryb debugowania i uruchom ponownie węzeł.
$ oc debug node/<node name>

$ sh-4.4# chroot /host

$ sh-4.4# systemctl reboot
5. Gdy węzeł będzie gotowy po ponownym uruchomieniu, oznacz go jako możliwy do zaplanowania.
$ oc adm uncordon <node name>
6. Sprawdź, czy węzeł został pomyślnie oznaczony jako możliwy do zaplanowania.
$ oc get node
Produse afectate
APEX Cloud Platform for Red Hat OpenShiftProprietăți articol
Article Number: 000216593
Article Type: Solution
Ultima modificare: 18 sept. 2026
Version: 4
Găsiți răspunsuri la întrebările dvs. de la alți utilizatori Dell
Servicii de asistență
Verificați dacă dispozitivul dvs. este acoperit de serviciile de asistență.