Openshift : Échec de la vérification préalable à la mise à niveau d’OCP en raison d’une erreur de nœud de vidage à sec
Summary: La vérification préalable à la mise à niveau de l’OCP a échoué pour l’erreur de vidage à sec, car certaines VM ne peuvent pas être migrées en direct ou certains pods ne peuvent pas être supprimés. ...
Acest articol se aplică pentru
Acest articol nu se aplică pentru
Acest articol nu este legat de un produs specific.
Acest articol nu acoperă toate versiunile de produs existente.
Symptoms
Lors de la vérification préalable de la LCM, il peut y avoir une défaillance de nœud de vidange à sec qui bloquera le processus LCM.
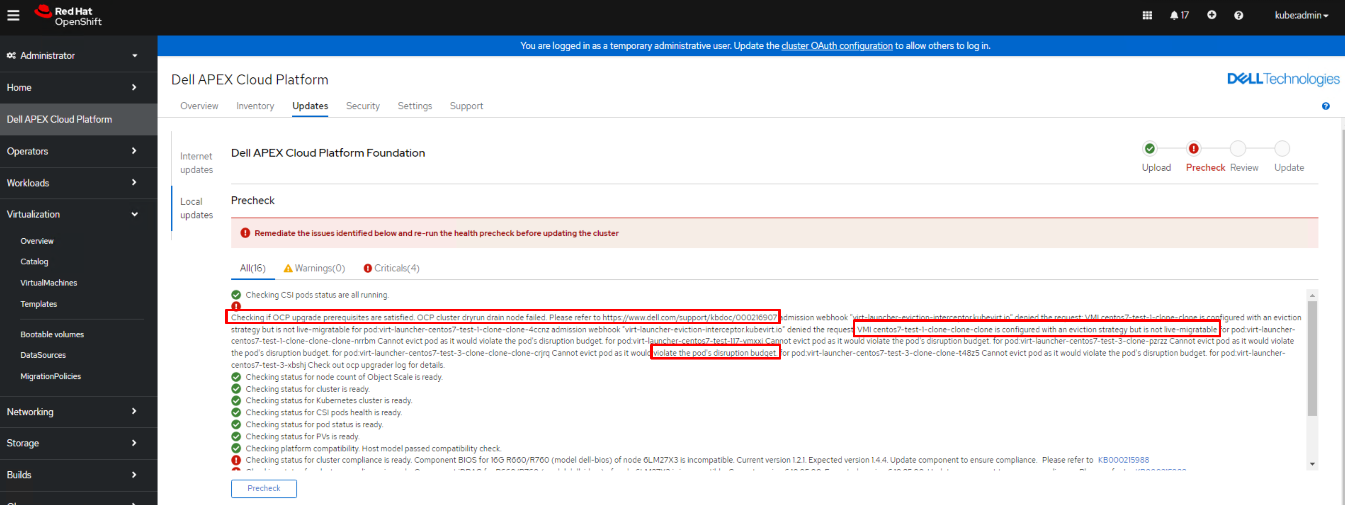
Le message d’erreur peut inclure, sans s’y limiter, les scénarios suivants :
Le message d’erreur peut inclure, sans s’y limiter, les scénarios suivants :
- Scénario 1 : « VMI XXXXXX est configuré avec une stratégie d’expulsion, mais ne peut pas migrer en direct. »
- Scénario 2 : « Impossible d’expulser le pod, car cela violerait le budget de perturbation du pod. »
- Scénario 3 : « pods xxx » introuvable pour le pod : xxxxxxxxxxxx
Cause
Cause première du scénario 1 : La machine virtuelle est configurée avec un volume de stockage ReadWriteOnce (RWO) qui ne peut pas être migré en direct sur le nœud de rapport d’erreur.
Cause première du scénario 2 : Le paramètre « PodDistruptionBudget » du pod est configuré sur « minAvailable : 1", Cela bloquera le processus d’éviction du pod.
Cause première du Senario 3 : La tâche planifiée Openshift démarre un pod et le pod est arrêté une fois le travail terminé. Il est donc possible que le pod soit introuvable lors de l’étape de purge du nœud de test à sec de pré-vérification.
Cause première du scénario 2 : Le paramètre « PodDistruptionBudget » du pod est configuré sur « minAvailable : 1", Cela bloquera le processus d’éviction du pod.
Cause première du Senario 3 : La tâche planifiée Openshift démarre un pod et le pod est arrêté une fois le travail terminé. Il est donc possible que le pod soit introuvable lors de l’étape de purge du nœud de test à sec de pré-vérification.
Resolution
Résolution du scénario 1
1. Arrêtez l’instance de machine virtuelle avant de modifier ses paramètres PV.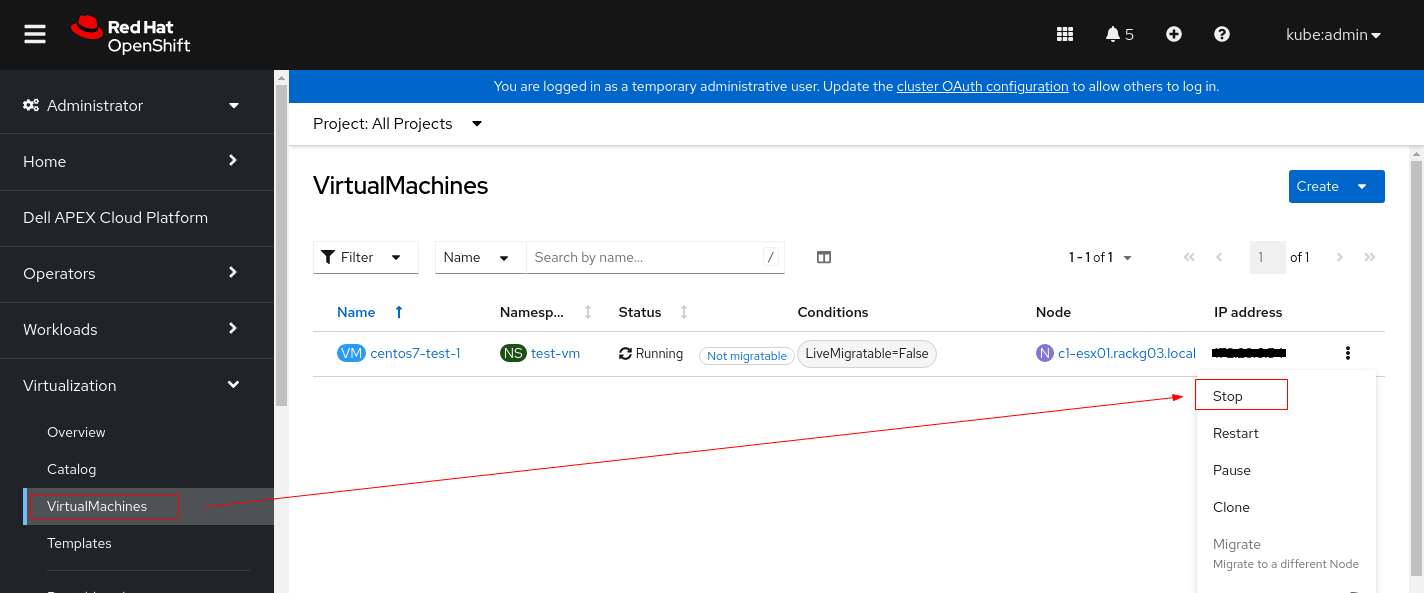
2. Cliquez sur la machine virtuelle et passez à l’onglet YAML.
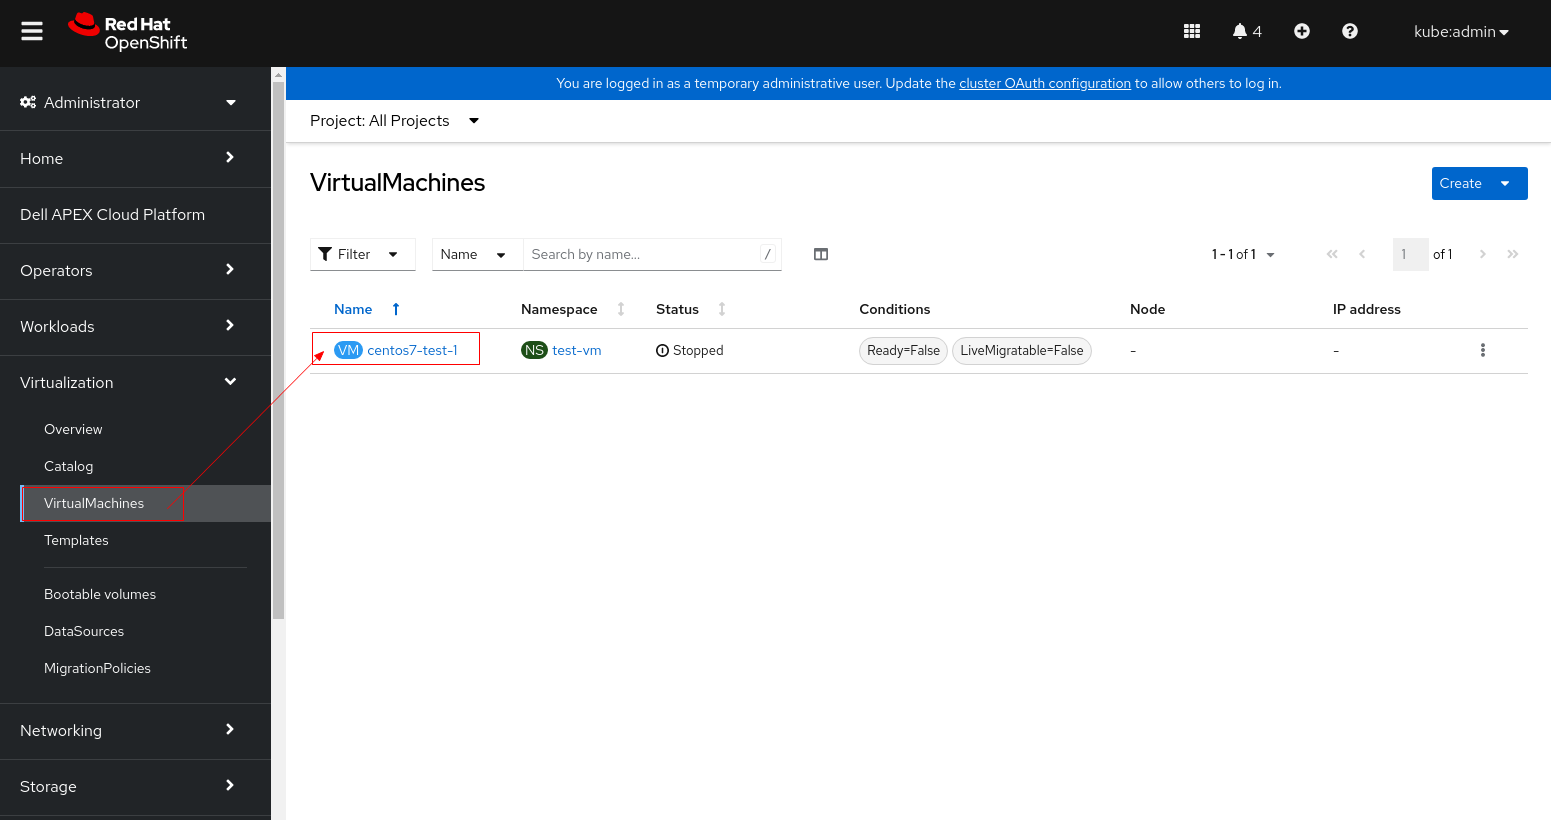
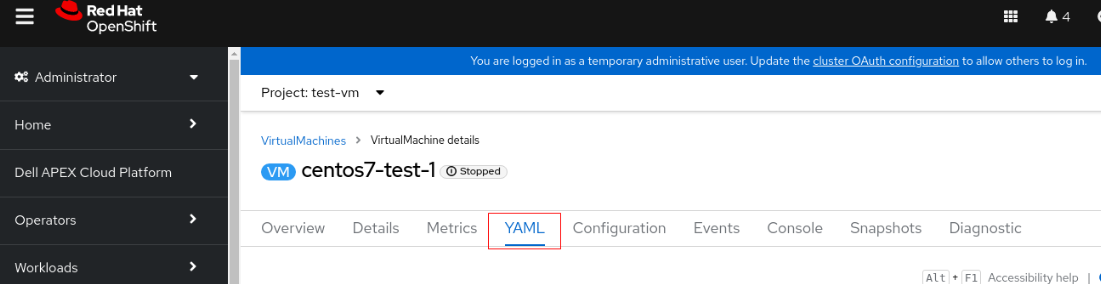
3. Modifiez accessModes de « ReadWriteOnce » à « ReadWriteMany ».
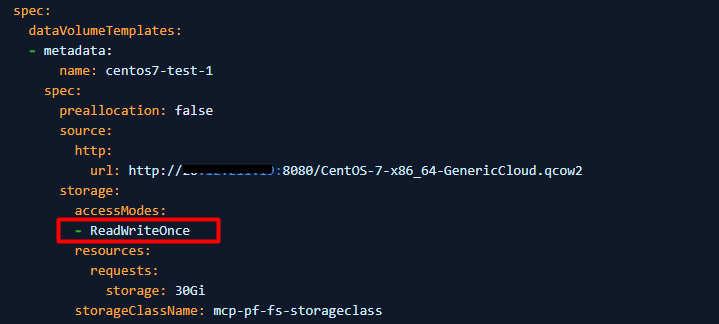
4. Si PV ne peut pas être défini sur ReadWriteMany (la machine virtuelle ne peut pas commencer à utiliser ReadWriteMany), définissez evictionStrategy de « LiveMigrate » sur « None ».
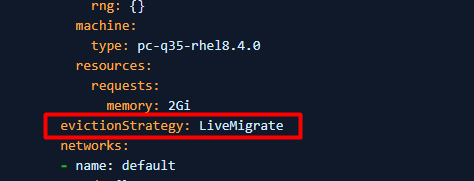
Note: Veuillez effectuer l’étape 3 ou 4 qui s’applique à votre environnement. Vous n’avez pas besoin d’effectuer les deux étapes.
5. Cliquez sur Enregistrer et redémarrez la machine virtuelle.
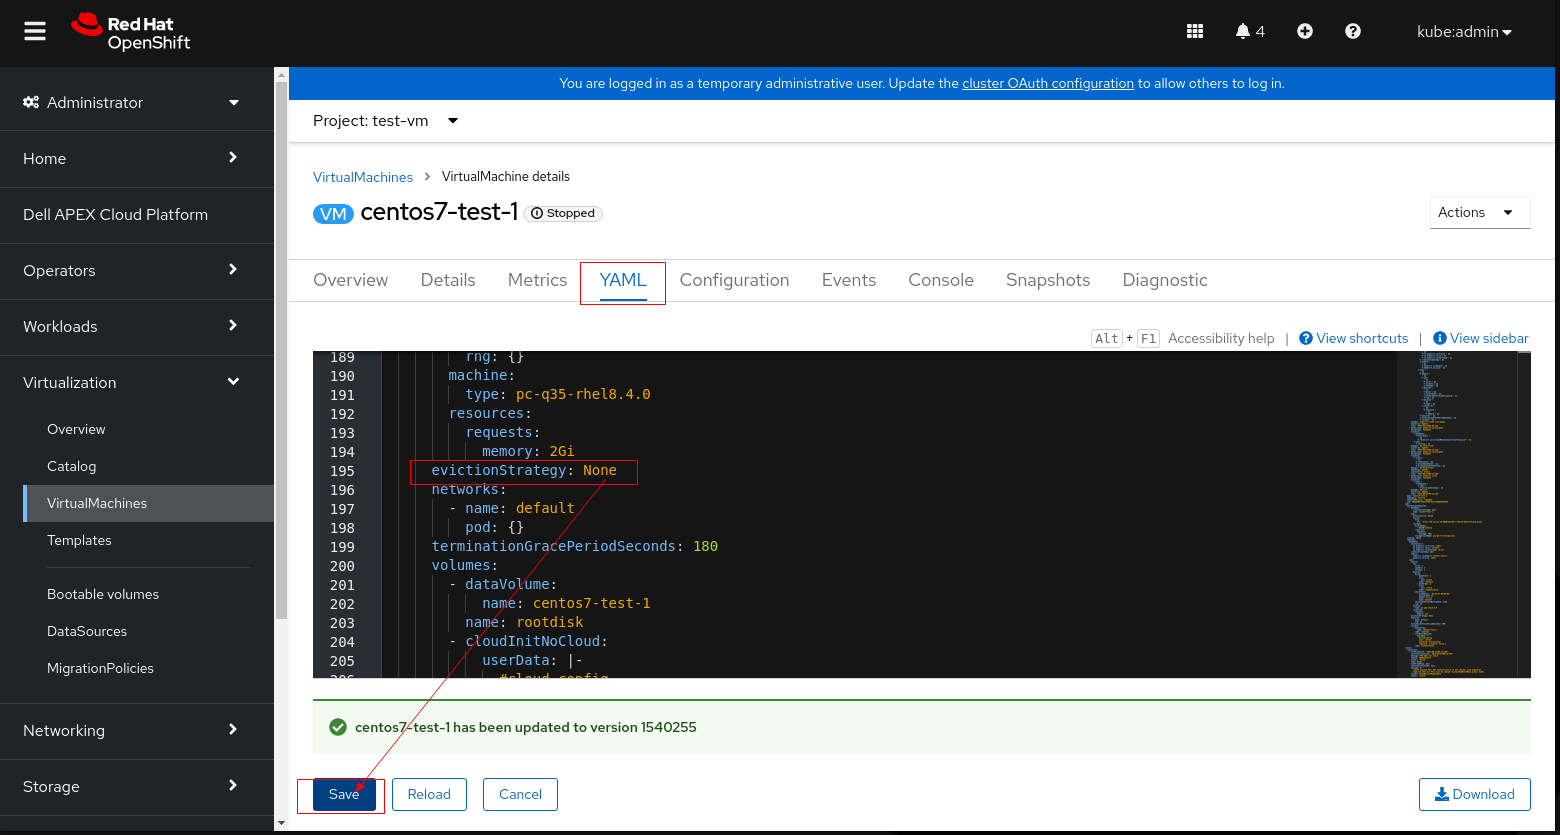
6. Réessayez la vérification préalable de LCM et poursuivez la mise à niveau.
Résolution du scénario 2
Effectuez l’une des procédures suivantes qui s’applique à votre environnement.
Procédure 1 : Supprimez manuellement le ou les pods qui ne peuvent pas être expulsés.
- Exécutez la commande ci-dessous pour supprimer le ou les pods qui ne peuvent pas être exclus et laissez-les se recréer dans des nœuds différents.
$ oc delete pod <pod_name> -n <pod_namespace>
- Réessayez la vérification préalable de LCM et poursuivez la mise à niveau.
Procédure 2 : Si le pod ne peut pas être supprimé manuellement, corrigez le pod dont « PodDisruptionBudget » est configuré comme « minAvailable : 1"
- Exécutez la commande ci-dessous pour vérifier la valeur « PodDisruptionBudget » du pod
Par exemple :
$ oc get pdb <pdb_name> -n <pod_namespace>

NAME         MIN AVAILABLE   MAX UNAVAILABLE   ALLOWED DISRUPTIONS   AGE
<pdb_name>   1               N/A               0                     18h
- Si le résultat de la commande indique que « MIN AVAILABLE » est défini sur « 1 », corrigez la valeur PodDisruptionBudget minAvailable sur « 0 » en exécutant la commande ci-dessous.
$ oc patch pdb <pdb_name> -n <pod_namespace> --type=merge -p '{"spec":{"minAvailable":0}}'
- Réessayez la vérification préalable de LCM et poursuivez la mise à niveau.
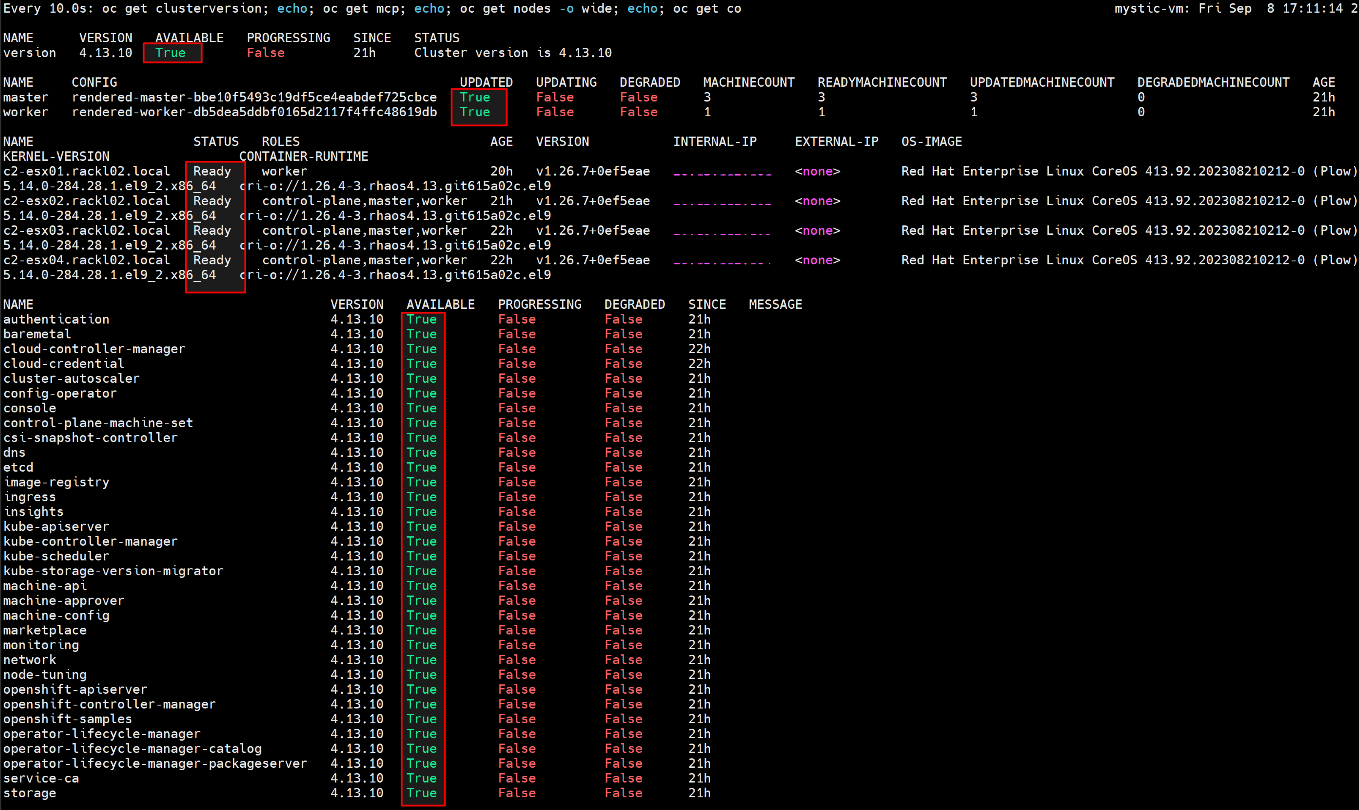
- Patientez jusqu’à ce que la mise à niveau soit terminée et que le MCO soit disponible, exécutez la commande ci-dessous pour vérifier que tout va bien.
$ watch -n10 "oc get clusterversion; echo; oc get mcp; echo; oc get nodes -o wide; echo; oc get co"
Par exemple :
- Une fois la mise à niveau OCP terminée, restaurez la valeur minAvailable PodDisruptionBudget sur « 1 »
$ oc patch pdb <pdb_name> -n <pod_namespace> --type=merge -p '{"spec":{"minAvailable":1}}'
Procédure 3 : Si vous corrigez l’erreur d’accès au pod « PodDisruptionBudget.policy « pdb_name> » n’est< pas valide : spec : Interdit : les mises à jour de la spécification de budget poddisruption sont interdites. », suivez les étapes ci-dessous pour contourner ce problème.
- Sauvegardez le PodDisruptionBudget configuré avec « minAvailable : 1"
$ oc get pdb <pdb_name> -n <pod_namespace> -o yaml > <pdb_name>_backup.yaml
- Supprimez le PodDisruptionBudget configuré avec « minAvailable : 1"
$ oc delete pdb <pdb_name> -n <pod_namespace>
- Réessayez la vérification préalable de LCM et poursuivez la mise à niveau.
- Patientez jusqu’à ce que la mise à niveau soit terminée et que le MCO soit disponible, exécutez la commande ci-dessous pour vérifier que tout va bien.
$ watch -n10 "oc get clusterversion; echo; oc get mcp; echo; oc get nodes -o wide; echo; oc get co"
Par exemple :
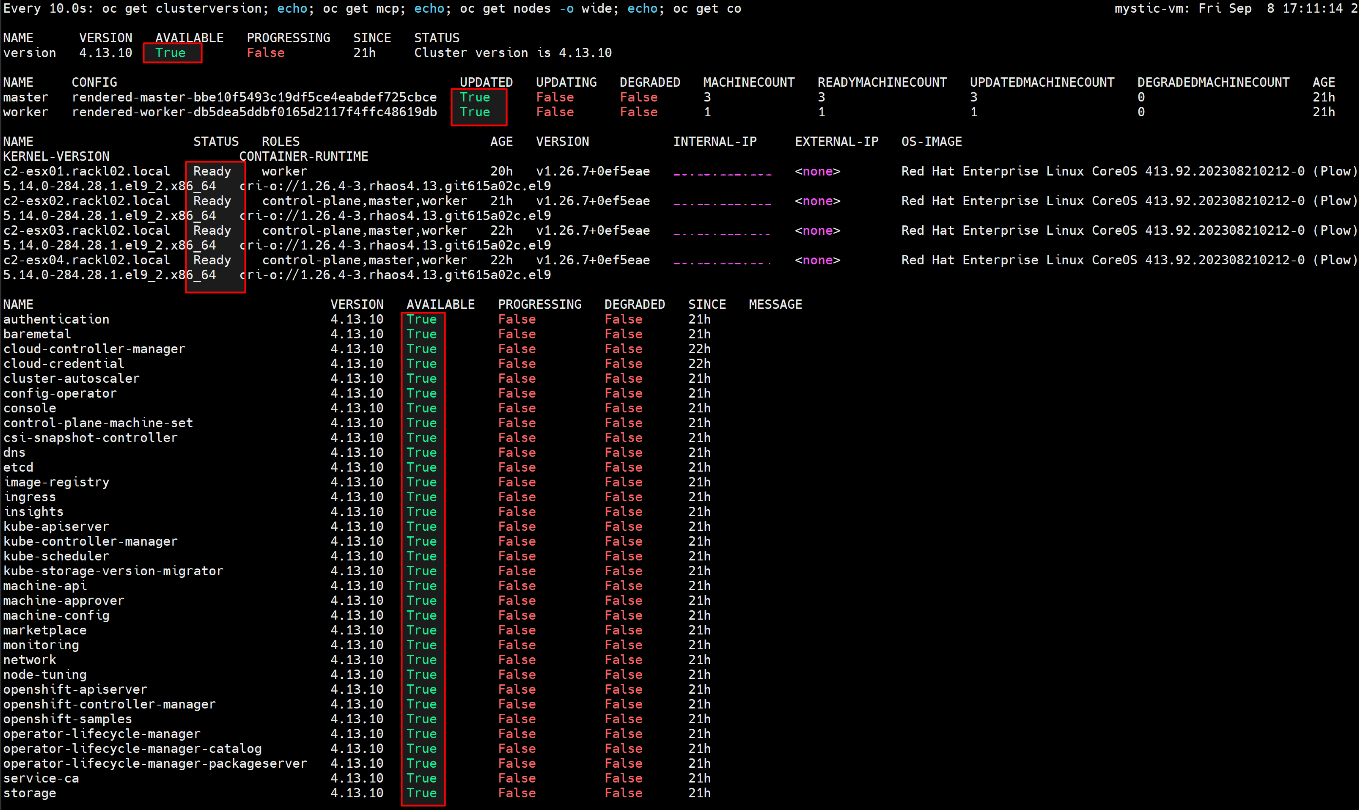
- Une fois la mise à niveau OCP terminée, restaurez le fichier yaml de sauvegarde.
$ oc create -f <pdb_name>_backup.yaml -n <pod_namespace>
Résolution du scénario 3
Il vous suffit de réessayer la vérification préalable de LCM, elle devrait réussir cette fois.
Additional Information
Consultez le document Openshift ci-dessous pour plus d’informations sur les volumes de stockage des disques de machine virtuelle.
Produse afectate
APEX Cloud Platform for Red Hat OpenShiftProprietăți articol
Article Number: 000216907
Article Type: Solution
Ultima modificare: 18 sept. 2026
Version: 4
Găsiți răspunsuri la întrebările dvs. de la alți utilizatori Dell
Servicii de asistență
Verificați dacă dispozitivul dvs. este acoperit de serviciile de asistență.