Openshift: ノードの再起動中にクラスターLCMに障害が発生しました
Summary: CSIコントローラー ポッドと引き取り修理マネージャー ポッドがデッドロック状態になったため、ノードの再起動中にLCMが失敗しました。
This article applies to
This article does not apply to
This article is not tied to any specific product.
Not all product versions are identified in this article.
Symptoms
OCPアップグレードまたはノードの再起動中にLCMが失敗し、アップデートUIにアクセスできなくなりました。
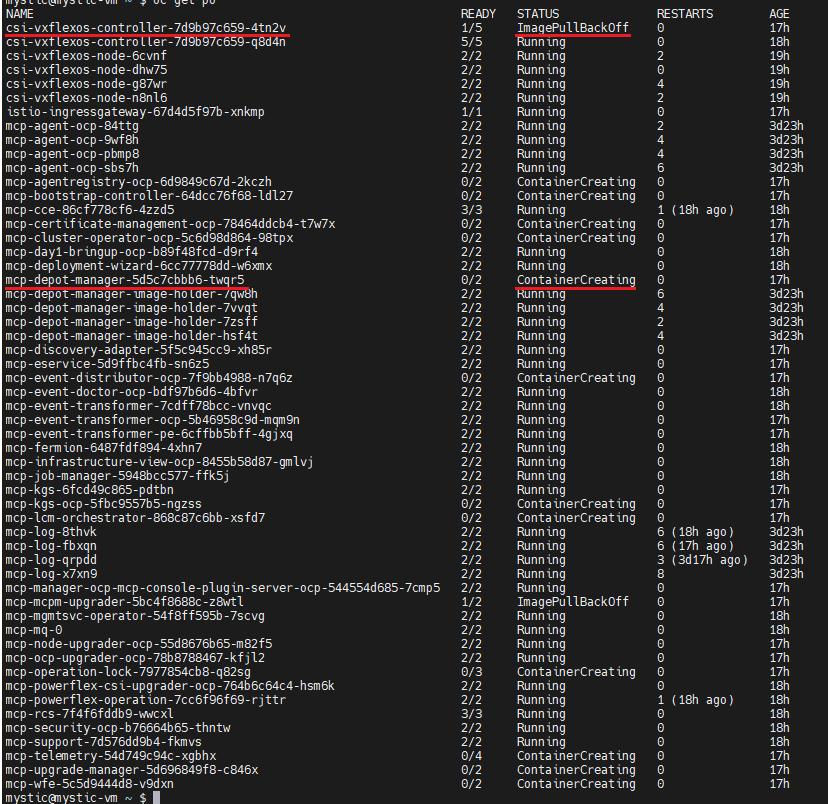
OCPにログインし、「oc get pods -n dell-acp」コマンドを実行してポッドのステータスを確認し、1つの csi-vxflexos-controller ポッドが ImagePullBackOff ステータスで、1つの mcp-depot-manager ポッドが ContainerCreating ステータスであることを確認します。例:「
「oc logs <pod_name> -n dell-acp -c driver 」コマンドを実行して、podログを確認します。
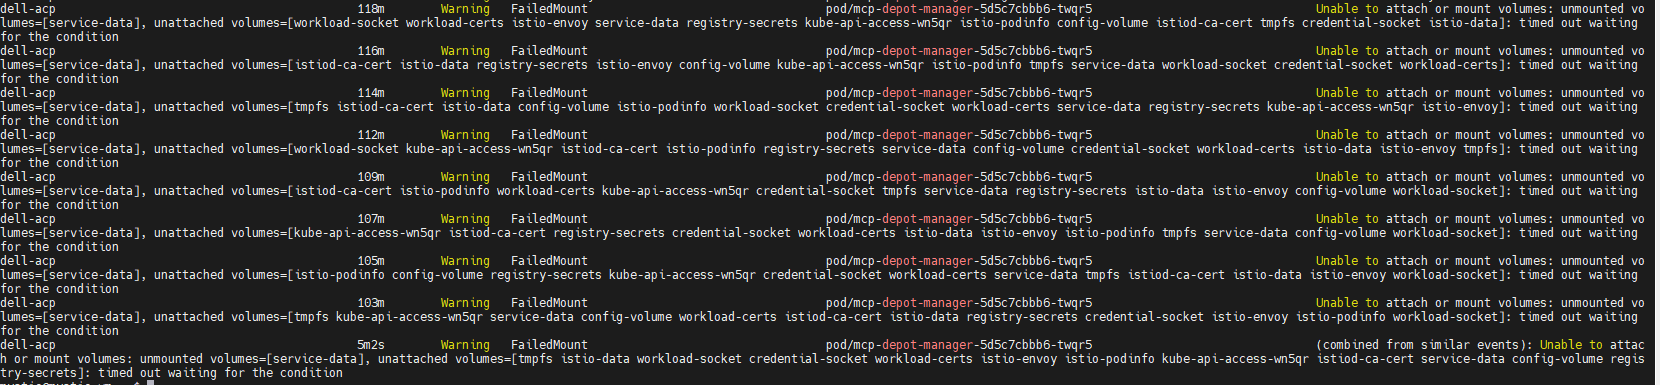
「oc describe pod <pod_name> -n dell-acp」コマンドを実行して、コンテナの作成mcp-depot-managerを確認します(上のスクリーンショットの例では、ポッド名はmcp-depot-manager-5d5c7cbbb6-twqr5です)。次のようなFailedMount警告が報告されます。
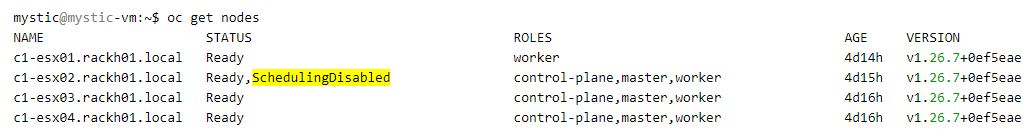
「oc get nodes」コマンドを実行してノードのステータスを確認します。SchedulingDisabledステータスのノードが1つあります。たとえば、次のようになります。
OCPにログインし、「oc get pods -n dell-acp」コマンドを実行してポッドのステータスを確認し、1つの csi-vxflexos-controller ポッドが ImagePullBackOff ステータスで、1つの mcp-depot-manager ポッドが ContainerCreating ステータスであることを確認します。例:「
「oc logs <pod_name> -n dell-acp -c driver 」コマンドを実行して、podログを確認します。
- 実行中のcsi-vxflexos-controllerポッドでは、ログにリーダー リースを取得しようとしていることが示されています。たとえば、次のようになります。
mystic@mystic-vm:~$ oc logs csi-vxflexos-controller-7d9b97c659-q8d4n -n dell-acp -c driver
-I0918 08:33: 23.460955 1 leaderelection.go:248] リーダーリースdell-acp /driver-csi-vxflexos-dellemc-comを取得しようとしています...
-I0918 08:33: 23.460955 1 leaderelection.go:248] リーダーリースdell-acp /driver-csi-vxflexos-dellemc-comを取得しようとしています...
- ImagePullBackOff csi-vxflexos-controllerポッドでは、ログにリーダー リースが正常に取得されたことが示されます。次に例を示します。
mystic@mystic-vm:~$ oc logs csi-vxflexos-controller-7d9b97c659-4tn2v -n dell-acp -c driver
-I0918 09:07: 30.076298 1 leaderelection.go:248] リーダーリースdell-acp/driver-csi-vxflexos-dellemc-comを取得しようとしています...
I0918 09:07:46.074524 1 leaderelection.go:258] リース dell-acp/driver-csi-vxflexos-dellemc-com
time="2023-09-18T09:07:46Z" level=info msg="configured 69de1f95f50e390f" allSystemNames= endpoint="https://dellpowerflex.h01.com" isDefault=true nasName=0xc000489950 nfsAcls= password="********" skipCertificateValidation=false systemID=69de1f95f50e390f user=admin
time="2023-09-18T09:07:46Z" level=info msg="ドライバー構成ファイル " file=/vxflexos-config-params/driver-config-params.yaml
time="2023-09-18T09:07:46Z" level=info msg="ログ構成ファイルからCSI_LOG_FORMATを読み取る" format=text
time="2023-09-18T09:07:46Z" level=info msg="ログ構成ファイルからCSI_LOG_LEVELを読み取る" fields.level=debug
time="2023-09-18T09:07:46Z" level=info msg="アレイ構成ファイル" file=/vxflexos-config/config
time = "2023-09-18T09:07:46Z" level = info msg = "すべてのアレイを調査しています。アレイの数: 1"
time="2023-09-18T09:07: 46Z" level=info msg="デフォルトのアレイはアレイIDに設定されています: 69de1f95f50e390f"
time="2023-09-18T09:07:46Z" level=info msg="69de1f95f50e390fはデフォルトのアレイで、VolumePrefixToSystemsマップの更新はスキップされます。\n"
time="2023-09-18T09:07:46Z" level=info msg="array 69de1f95f50e390f が正常にプローブされました"
time="2023-09-18T09:07:46Z" level=info msg="構成済み csi-vxflexos.dellemc.com" IsApproveSDCEnabled=false IsHealthMonitorEnabled=false IsQuotaEnabled=false IsSdcRenameEnabled=false MaxVolumesPerNode=0 allowRWOMultiPodAccess=false autoprobe=true externalAccess= mode=controller nfsAcls= privatedir=/dev/disk/csi-vxflexos sdcGUID= sdcPrefix= thickprovision=false
time="2023-09-18T09:07:46Z" level=info msg="ID service registered"
time="2023-09-18T09:07:46Z" level=info msg="controller service registered"
time="2023-09-18T09:07:46Z" level=info msg="追加のGRPCサーバーの登録"
time="2023-09-18T09:07:46Z" level=info msg=serving endpoint="unix:///var/run/csi/csi.sock"
-I0918 09:07: 30.076298 1 leaderelection.go:248] リーダーリースdell-acp/driver-csi-vxflexos-dellemc-comを取得しようとしています...
I0918 09:07:46.074524 1 leaderelection.go:258] リース dell-acp/driver-csi-vxflexos-dellemc-com
time="2023-09-18T09:07:46Z" level=info msg="configured 69de1f95f50e390f" allSystemNames= endpoint="https://dellpowerflex.h01.com" isDefault=true nasName=0xc000489950 nfsAcls= password="********" skipCertificateValidation=false systemID=69de1f95f50e390f user=admin
time="2023-09-18T09:07:46Z" level=info msg="ドライバー構成ファイル " file=/vxflexos-config-params/driver-config-params.yaml
time="2023-09-18T09:07:46Z" level=info msg="ログ構成ファイルからCSI_LOG_FORMATを読み取る" format=text
time="2023-09-18T09:07:46Z" level=info msg="ログ構成ファイルからCSI_LOG_LEVELを読み取る" fields.level=debug
time="2023-09-18T09:07:46Z" level=info msg="アレイ構成ファイル" file=/vxflexos-config/config
time = "2023-09-18T09:07:46Z" level = info msg = "すべてのアレイを調査しています。アレイの数: 1"
time="2023-09-18T09:07: 46Z" level=info msg="デフォルトのアレイはアレイIDに設定されています: 69de1f95f50e390f"
time="2023-09-18T09:07:46Z" level=info msg="69de1f95f50e390fはデフォルトのアレイで、VolumePrefixToSystemsマップの更新はスキップされます。\n"
time="2023-09-18T09:07:46Z" level=info msg="array 69de1f95f50e390f が正常にプローブされました"
time="2023-09-18T09:07:46Z" level=info msg="構成済み csi-vxflexos.dellemc.com" IsApproveSDCEnabled=false IsHealthMonitorEnabled=false IsQuotaEnabled=false IsSdcRenameEnabled=false MaxVolumesPerNode=0 allowRWOMultiPodAccess=false autoprobe=true externalAccess= mode=controller nfsAcls= privatedir=/dev/disk/csi-vxflexos sdcGUID= sdcPrefix= thickprovision=false
time="2023-09-18T09:07:46Z" level=info msg="ID service registered"
time="2023-09-18T09:07:46Z" level=info msg="controller service registered"
time="2023-09-18T09:07:46Z" level=info msg="追加のGRPCサーバーの登録"
time="2023-09-18T09:07:46Z" level=info msg=serving endpoint="unix:///var/run/csi/csi.sock"
「oc describe pod <pod_name> -n dell-acp」コマンドを実行して、コンテナの作成mcp-depot-managerを確認します(上のスクリーンショットの例では、ポッド名はmcp-depot-manager-5d5c7cbbb6-twqr5です)。次のようなFailedMount警告が報告されます。
「oc get nodes」コマンドを実行してノードのステータスを確認します。SchedulingDisabledステータスのノードが1つあります。たとえば、次のようになります。
Cause
アクティブなcsi-controllerポッドとmcp-depot-managerが同じノード上にある場合、LCMがノードを再起動すると、csi-controllerとdepot-managerは新しいノードに再スケジュールされます。ポッドの起動中に、csi-controllerとdepot-managerがデッドロックに陥り、起動できません。
Resolution
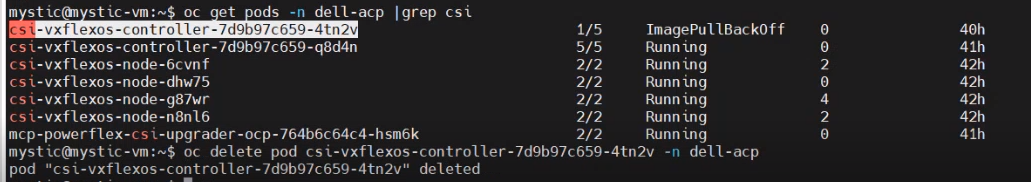
1.「oc get pods -n dell-acp |grep csi」コマンドを実行して、ステータスが正しくないCSIコントローラー ポッドのポッド名を特定します。
2.「oc delete pod <pod_name> -n dell-acp」コマンドを実行して、特定されたポッドを削除します。
例:
3.数分待ってから「oc get pods -n dell-acp」コマンドを実行し、すべてのポッドが実行中ステータスになっていることを確認します。それでもcsi-controller podまたはmcp-depot-managerが実行されていない場合は、上記の手順を再試行してください
4.すべてのポッドが[Running]ステータスになるまで、LCMを再試行してクラスターのアップグレードを続行します。
2.「oc delete pod <pod_name> -n dell-acp」コマンドを実行して、特定されたポッドを削除します。
例:
3.数分待ってから「oc get pods -n dell-acp」コマンドを実行し、すべてのポッドが実行中ステータスになっていることを確認します。それでもcsi-controller podまたはmcp-depot-managerが実行されていない場合は、上記の手順を再試行してください
4.すべてのポッドが[Running]ステータスになるまで、LCMを再試行してクラスターのアップグレードを続行します。
Article Properties
Article Number: 000217992
Article Type: Solution
Last Modified: 18 Sept 2026
Version: 4
Find answers to your questions from other Dell users
Support Services
Check if your device is covered by Support Services.