PowerEdge: AMD Řím – architektura a počáteční výkon HPC
Shrnutí: V dnešním světě HPC představuje představení nejnovější generace procesorů AMD EPYC s kódovým označením Rome.
Pokyny
Garima Kochhar, Deepthi Cherlopalle, Joshua Weage. HPC and AI Innovation Lab, říjen 2019
V dnešním světě HPC není třeba nejnovější generaci procesorů 
Architektura
Rome je procesor AMD EPYC 2. generace, který obnovuje jejich Neapol 1. generace.
Jedním z největších architektonických rozdílů mezi Neapolí a Římem, který přináší výhody pro HPC, je nová matrice IO v Římě. V Římě je každý procesor vícečipový balíček složený až z devíti čipletů , jak je znázorněno na obrázku 1. K dispozici je jeden centrální 14nm IO čip, který obsahuje všechny IO a paměťové funkce - představte si paměťové řadiče, Infinity fabric linky v rámci socketu a intersocketové konektivity a PCI-e. V každém socketu je osm paměťových řadičů, které podporují osm paměťových kanálů s procesorem DDR4 o rychlosti 3 200 MT/s. Jednosocketový server může podporovat až 130 linek PCIe 4. generace. Dvousocketový systém podporuje až 160 linek PCIe 4. generace.
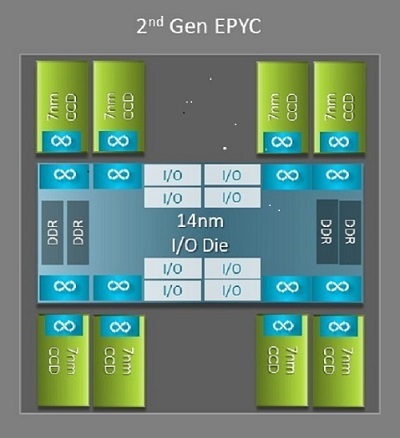
(Obrázek 1: Vícečipové pouzdro Rome s jedním centrálním čipem IO a až osmijádrovými čipy)
Kolem centrálního IO čipsetu je až osm 7nm jádrových čipletů. Čiplet jádra se nazývá Core Cache die nebo CCD. Každý CCD čip má jádra CPU založená na mikroarchitektuře Zen2, L2 cache a 32MB L3 cache. Samotný CCD má dva Core Cache Complexes (CCX),
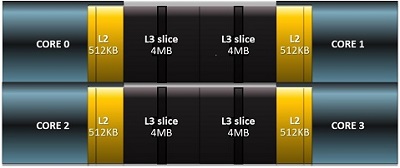
(Obrázek 2 : CCX se čtyřmi jádry a sdílenou 16MB mezipamětí L3)
Různé modely
Na horním konci je model procesoru s 64 jádry, například EPYC 7702. Výstup nám ukazuje, že tento procesor má 16 CCX na socket, každý CCX má čtyři jádra, jak je znázorněno na obrázku 3 a 4, což dává 64 jader na socket. 16 MB L3 na CCX, tedy 32 MB L3 na CCD, dává tomuto procesoru 256 MB L3 cache. Všimněte si však, že celková mezipaměť L3 v Římě není sdílena všemi jádry. 16MB L3 cache v každém CCX je nezávislá a je sdílena pouze jádry v CCX, jak je znázorněno na obrázku 2.
24jádrový procesor, jako je EPYC 7402, má 128 MB L3 cache. Výstup Lstopo na obrázku 3 a 4 ukazuje, že tento model má tři jádra na CCX a osm CCX na socket.
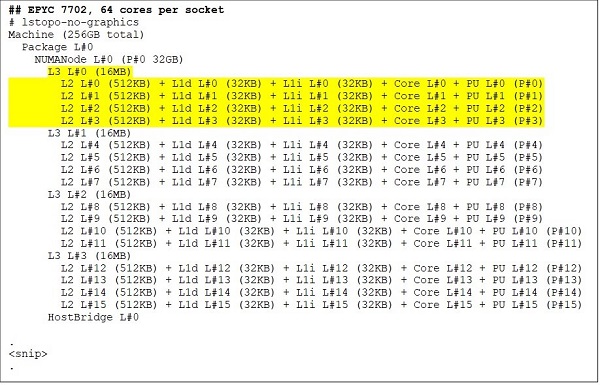
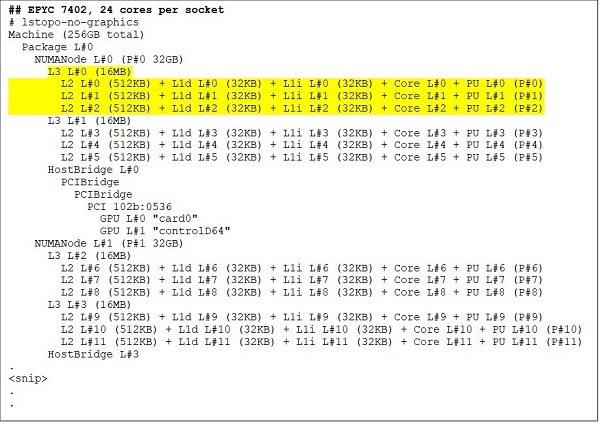
(Obrázek 3 a 4: Výstup lstopo pro 64jádrové a 24jádrové procesory)
Bez ohledu na počet CCD je každý procesor Rome logicky rozdělen do čtyř kvadrantů s CCD distribuovanými co nejrovnoměrněji napříč kvadranty a dvěma paměťovými kanály v každém kvadrantu. Centrální IO matrici si lze představit jako logicky podporující čtyři kvadranty patice.
Možnosti systému BIOS vycházející z římské architektury
Centrální IO matrice v Římě pomáhá zlepšit latenci
Čtyři logické kvadranty v procesoru Řím umožňují rozdělení procesoru do různých domén NUMA. Toto nastavení se nazývá NUMA na soket nebo NPS.
- NPS1 znamená, že procesor Rome je jedna doména NUMA se všemi jádry v soketu a veškerou pamětí v této doméně NUMA. Paměť je prokládána napříč osmi paměťovými kanály. Všechna zařízení PCIe na socketu patří do této jediné domény NUMA.
- Server NPS2 rozdělí procesor do dvou domén NUMA s polovinou jader a polovinou paměťových kanálů na soketu v každé doméně NUMA. Paměť je prokládaná napříč čtyřmi paměťovými kanály v každé doméně NUMA
- Server NPS4 rozdělí procesor do čtyř domén NUMA. Každý kvadrant je zde doménou NUMA a paměť je prokládána přes dva paměťové kanály v každém kvadrantu. Zařízení PCIe jsou místní pro jednu ze čtyř domén NUMA na soketu podle toho, který kvadrant čipu IO má kořenový adresář PCIe pro dané zařízení
- Ne všechny procesory podporují všechna nastavení serveru NPS.
Tam, kde je k dispozici, se pro HPC doporučuje NPS4, protože se očekává, že poskytne nejlepší šířku pásma paměti, nejnižší latenci paměti a naše aplikace obvykle podporují technologii NUMA. Pokud NPS4 není k dispozici, doporučujeme, aby nejvyšší NPS podporovaný modelem procesoru - NPS2 nebo dokonce NPS1.
Vzhledem k velkému množství možností NUMA, které jsou k dispozici na římských platformách, umožňuje systém BIOS serveru PowerEdge v rámci výčtu MADT dvě různé metody výčtu jader. Lineární výčet čísel jader v pořadí, vyplnění jednoho CCX, CCD, socketu před přechodem na další socket. Na procesoru 32c jsou jádra 0 až 31 na prvním socketu a jádra 32–63 na druhém socketu. Kruhové dotazování čísluje jádra napříč oblastmi NUMA. V tomto případě jsou sudá jádra na prvním socketu, lichá jádra na druhém socketu. Pro zjednodušení doporučujeme lineární výčet pro HPC. Na obrázku 5 je uveden příklad lineárního výčtu jader na dvousocketovém serveru 64c nakonfigurovaném v NPS4. Na obrázku je každá krabička se čtyřmi jádry CCX, každá sada osmi sousedících jader je CCD.
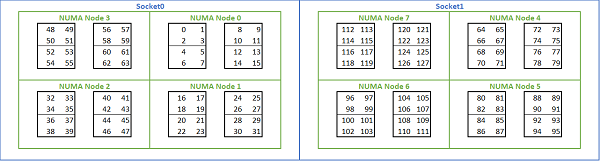
(Obrázek 5 Lineární výčet jader v systému se dvěma sockety, 64c na socket, konfigurace NPS4 v modelu s osmi procesory CCD)
Další volba systému BIOS specifická pro Řím se nazývá Preferred IO Device. Toto je důležitý ladicí knoflík pro šířku pásma InfiniBand a rychlost zpráv. Umožňuje platformě upřednostnit provoz pro jedno vstupně-výstupní zařízení. Tato možnost je k dispozici na jednosocketových i dvousocketových platformách Rome a zařízení InfiniBand v platformě musí být vybráno jako preferované zařízení v nabídce systému BIOS, aby bylo dosaženo plné rychlosti zpráv, když jsou aktivní všechna jádra procesoru.
Podobně jako Neapol i Řím podporuje hyper-threading nebo logický procesor. U HPC ponecháváme tuto možnost zakázánou, ale pro některé aplikace může být povolení logického procesoru výhodné. Podívejte se na naše následující blogy o aplikačních studiích molekulární dynamiky.
Podobně jako Neapol umožňuje Řím také CCX jako doménu NUMA. Tato možnost zpřístupňuje každý CCX jako uzel NUMA. V systému s dvousocketovými procesory s 16 CCX na procesor toto nastavení zpřístupňuje 32 domén NUMA. V tomto příkladu má každá zásuvka osm CCD, tedy 16 CCX. Každý CCX může být povolen jako vlastní doména NUMA, což dává 16 uzlů NUMA na soket a 32 v systému se dvěma sockety. V případě HPC doporučujeme ponechat CCX jako doménu NUMA ve výchozí nastavení zakázáno. Očekává se, že povolení této možnosti pomůže virtualizovaným prostředím.
Podobně jako Neapol i Řím umožňuje nastavit systém v režimu Performance Determinism nebo Power Determinism . V determinismu výkonu systém pracuje s očekávanou frekvencí pro model procesoru, což snižuje variabilitu mezi více servery. V Power Determinism systém pracuje s maximálním dostupným TDP modelu CPU. To zesiluje rozdíly ve výrobním procesu mezi díly, což umožňuje, aby některé servery byly rychlejší než jiné. Všechny servery mohou spotřebovávat maximální jmenovitý výkon procesoru, takže spotřeba energie je deterministická, ale umožňuje určité rozdíly ve výkonu napříč více servery.
Jak se dá očekávat u platforem PowerEdge, systém BIOS obsahuje meta možnost nazvanou System Profile. Výběrem profilu systému Optimalizace výkonu povolíte režim Turbo Boost, zakážete stavy C a nastavíte posuvník determinismu na hodnotu Power Determinism, optimalizace výkonu.
Výsledky výkonu – mikrosrovnávací testy STREAM, HPL, InfiniBand
Mnoho našich čtenářů možná skočilo rovnou na tuto sekci, takže se do ní rovnou ponoříme.
V laboratoři HPC and AI Innovation Lab jsme vytvořili cluster s 64 servery v Římě, kterému říkáme Minerva. Kromě homogenního klastru Minerva máme několik dalších vzorků procesorů Rome, které bychom mohli vyhodnotit. Náš testbed je popsán v Tabulce 1 a Tabulce 2.
(Tabulka 1 Římské modely procesorů hodnocené v této studii)
| Procesor | Počet jader na socket | Konfigurace | Základní taktovací frekvence | TDP |
|---|---|---|---|---|
| 7702 | 64c | 4c za CCX | 2,0 GHz | 200 W |
| 7502 | 32c | 4c za CCX | 2,5 GHz | 180 W |
| 7452 | 32c | 4c za CCX | 2,35 GHz | 155 W |
| 7402 | 24c | 3c za CCX | 2,8 GHz | 180 W |
(Tabulka 2 Testbed)
| Komponenta | Podrobnosti |
|---|---|
| Server | PowerEdge C6525 |
| Procesor | Jak je uvedeno v tabulce 1: Dvousocketové |
| Paměť | 256 GB, 16 × 16 GB, 3 200 MT/s, DDR4 |
| Interconnect | ConnectX-6 Mellanox Infini Band HDR100 |
| Operační systém | Red Hat Enterprise Linux 7.6 |
| Jádro | 3.10.0.957.27.2.e17.x86_64 |
| Pevný disk | 240GB modul SATA SSD M.2 |
STREAMOVAT
Testy šířky pásma paměti v Římě jsou znázorněny na obrázku 6. Tyto testy probíhaly v režimu NPS4. Naměřili jsme šířku pásma paměti ~270–300 GB/s na našem dvousocketovém serveru PowerEdge C6525 při využití všech jader serveru ve všech čtyřech modelech procesorů uvedených v tabulce 1. Pokud je na CCX použito pouze jedno jádro, šířka pásma systémové paměti je ~9–17 % vyšší než šířka pásma se všemi jádry.
Většina úloh HPC buď plně přihlásí všechna jádra v systému, nebo centra HPC běží v režimu vysoké propustnosti s více úlohami na každém serveru. Šířka pásma paměti pro všechna jádra je tedy přesnějším vyjádřením šířky pásma paměti a možností šířky pásma paměti na jádro systému.
Obrázek 6 také znázorňuje propustnost paměti naměřenou na předchozí generaci platformy EPYC Naples , která také podporovala osm paměťových kanálů na socket, ale běžela rychlostí 2667 MT/s. Platforma Rome poskytuje o 5 až 19 % lepší celkovou propustnost paměti než Neapol, a to především díky rychlejší paměti 3200 MT/s. I s 64c na socket může systém Rome dodávat až 2 GB/s/jádro.
Při porovnání různých konfigurací serveru NPS byla u NPS4 naměřena ~13% vyšší šířka pásma paměti ve srovnání s NPS1, jak je znázorněno na obrázku 7.
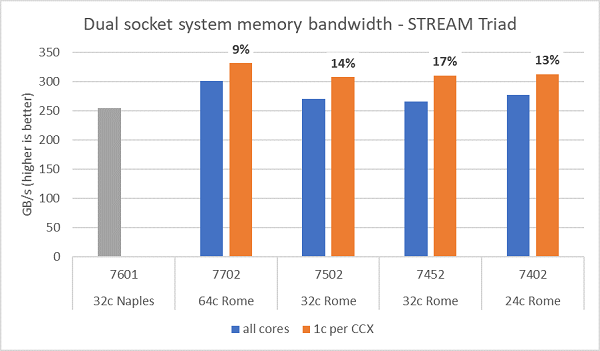
(Obrázek 6 : Šířka pásma paměti dual-socket NPS4 STREAM Triad)
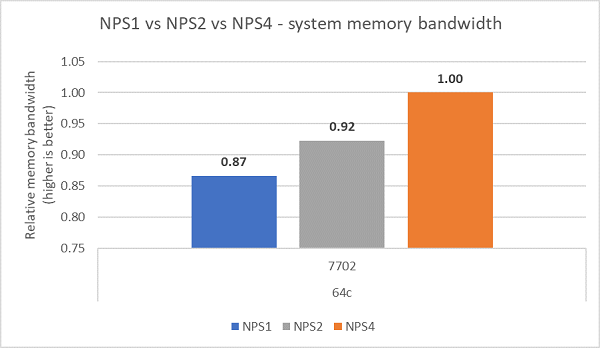
(Obrázek 7 Šířka pásma paměti NPS1 vs NPS2 vs NPS 4)
Šířka pásma a rychlost zpráv InfiniBand
Obrázek 8 znázorňuje šířku pásma InfiniBand s jedním jádrem pro jednosměrné a obousměrné testy. Testovací prostředí používalo HDR100 běžící na 100 Gb/s a graf ukazuje očekávaný výkon linkové rychlosti pro tyto testy.
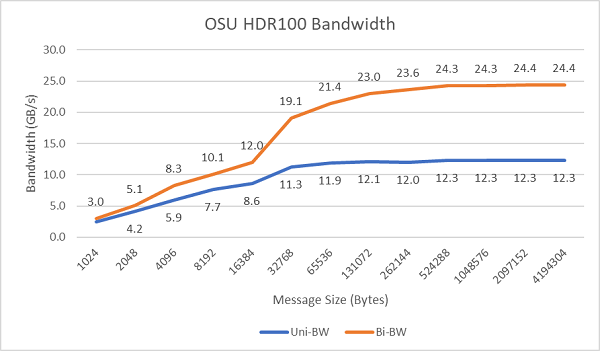
Obrázek 8 Šířka pásma InfiniBand (jedno jádro)
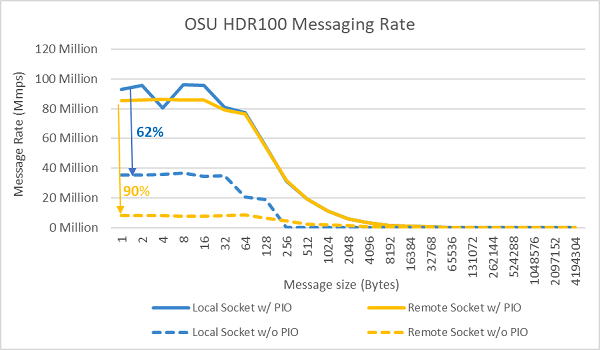
Obrázek 9 Rychlost zpráv InfiniBand (všechna jádra))
Dále byly provedeny testy rychlosti přenosu zpráv se všemi jádry socketu na dvou testovaných serverech. Když je v systému BIOS povolena funkce Preferred IO a adaptér ConnectX-6 HDR100 je nakonfigurován jako preferované zařízení, rychlost zpráv všech jader je vyšší, než když preferovaný IO není povolen, jak je znázorněno na obrázku 9. To dokládá důležitost této možnosti systému BIOS při ladění pro HPC a zejména při škálování aplikací s více uzly.
HPL
Římská mikroarchitektura dokáže vyřadit 16 DP FLOP/cyklus, což je dvojnásobek oproti Neapoli, která měla 8 FLOPŮ/cyklus. To dává Římu 4x vyšší teoretický špičkový FLOPS než Neapol, 2x větší schopnost floating-point a 2x dvojnásobný počet jader (64c vs 32c). Obrázek 10 znázorňuje naměřené výsledky HPL pro čtyři modely procesorů Rome, které jsme testovali, spolu s našimi předchozími výsledky ze systému založeného na Neapoli. Efektivita Rome HPL je uvedena jako procentuální hodnota nad pruhy v grafu a je vyšší pro modely CPU s nižším TDP.
Testy probíhaly v režimu Power Determinism a na 64 identicky nakonfigurovaných serverech byl naměřen rozdíl ve výkonu ~5 %, výsledky jsou tedy v tomto výkonnostním pásmu.
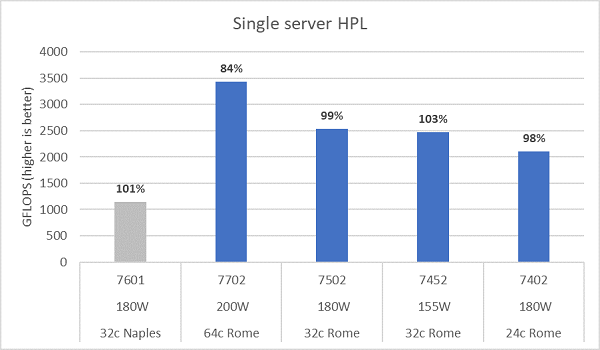
(Obrázek 10 HPL pro jeden server v NPS4)
Dále byly provedeny testy HPL s více uzly a tyto výsledky jsou vyneseny do grafu 11. Účinnost HPL pro EPYC 7452 zůstává nad 90 % v měřítku 64 uzlů, ale poklesy účinnosti ze 102 % dolů na 97 % a zpět na 99 % vyžadují další vyhodnocení.
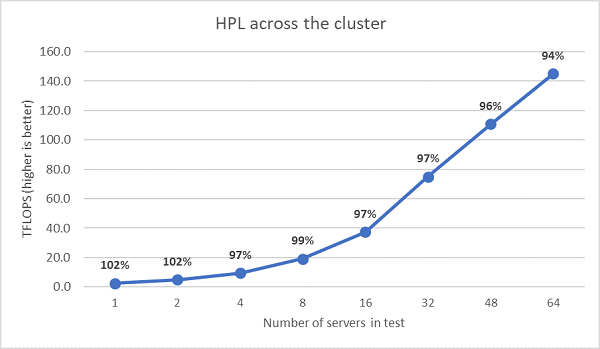
(Obrázek 11 HPL s více uzly, dvousocketový procesor EPYC 7452 přes HDR100 InfiniBand)
Shrnutí a další kroky:
Úvodní studie výkonu serverů z Říma ukazují očekávaný výkon pro naši první sadu srovnávacích testů HPC. Ladění systému BIOS je důležité při konfiguraci maximálního výkonu. Možnosti ladění jsou k dispozici v profilu zátěže BIOS HPC, který lze nakonfigurovat ve výrobě nebo nastavit pomocí nástrojů pro správu systémů Dell EMC.
Centrum HPC a AI Innovation Lab