OpenShift: Proces wdrażania klastra nie powiódł się z powodu nieprawidłowego stanu zasobnika statycznego.
Podsumowanie: Problem z platformą kontenerów OpenShift powodujący niepowodzenie wdrożenia klastra, stan zasobnika statycznego zmienił się na ukończony.
Objawy
Scenariusz 1: Proces konfiguracji wdrożenia klastra nie powiódł się z błędem "Nie udało się wykonać kroku oczekiwania na gotowość płaszczyzny sterowania OCP"
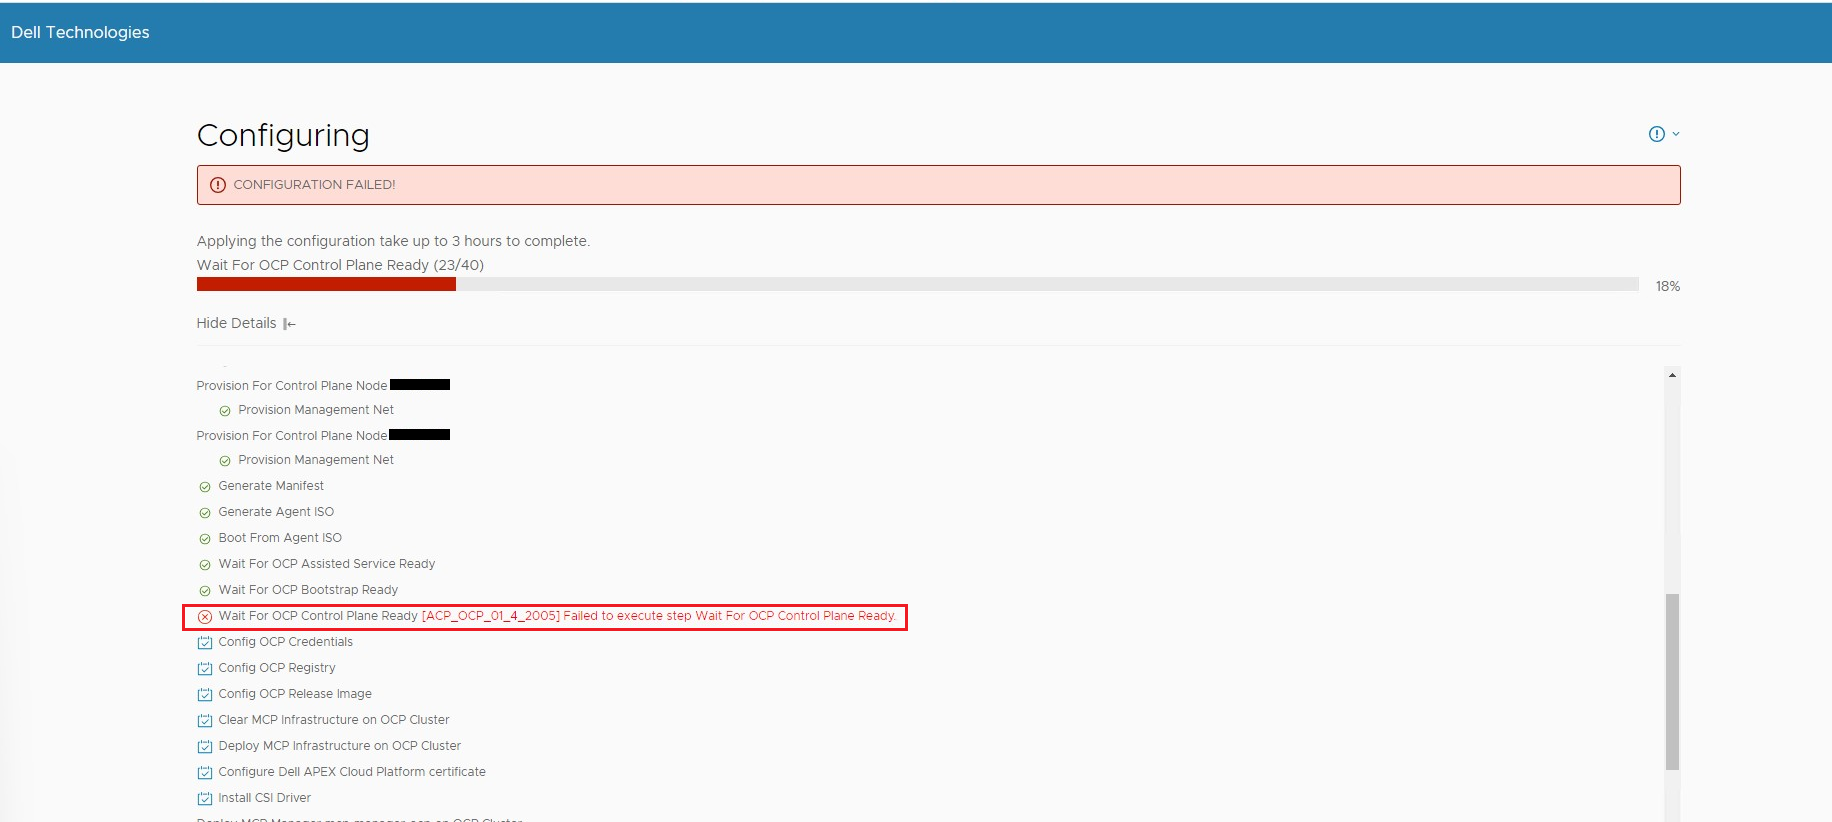
Scenariusz 2: Proces konfiguracji wdrożenia klastra nie powiódł się z błędem "Failed to execute step Config OCP Registry"
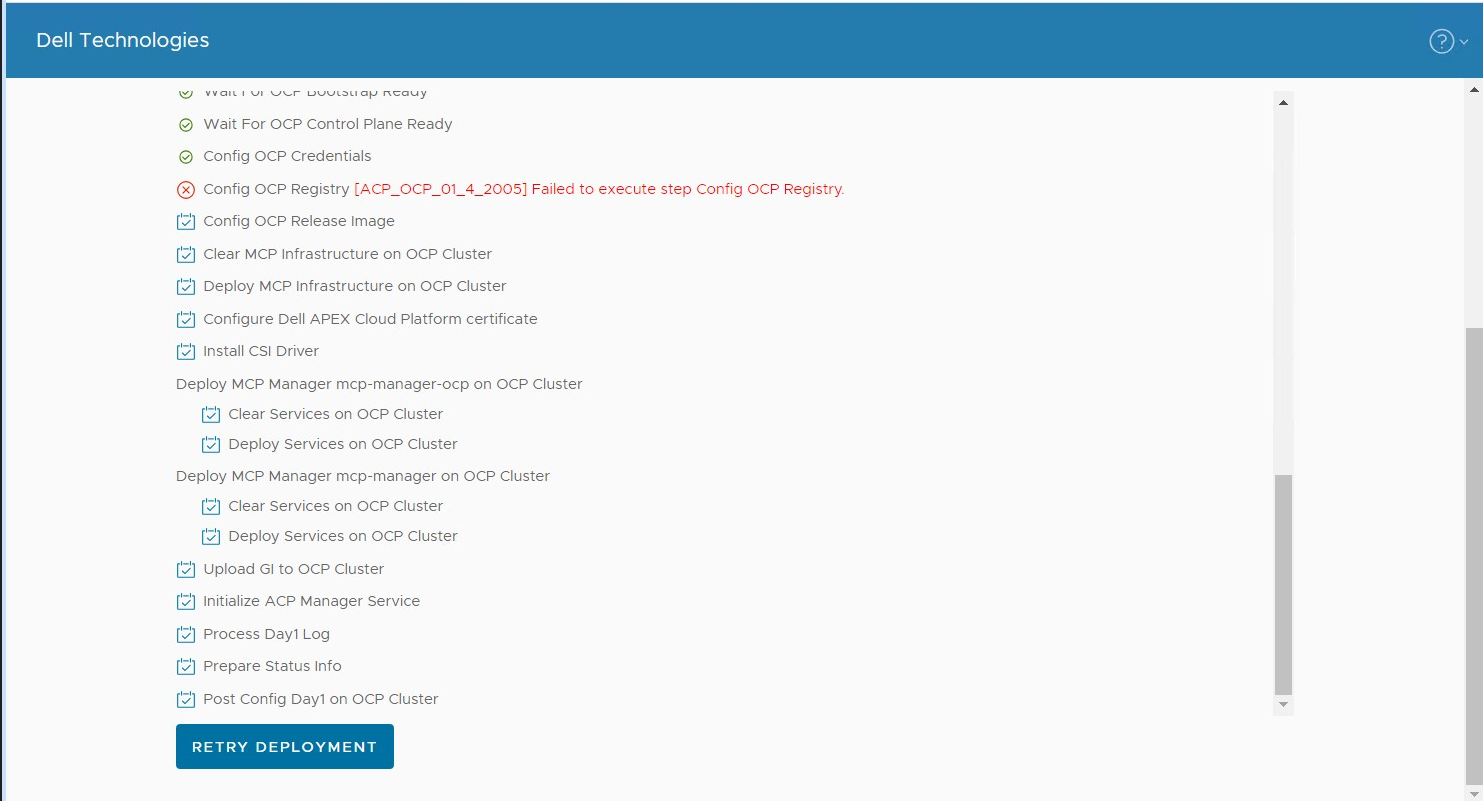
Zaloguj się do węzła głównego przez SSH (domyślne poświadczenia to root/Passw0rd!), uruchom poniższe polecenia, aby sprawdzić wersję klastra, operatora klastra i stan zasobników statycznych.
1. Uruchom polecenie:kubectl --kubeconfig="/usr/share/mcp_ocp/pv/mcp-installer-ocp/auth/kubeconfig" get clusterversion
Polecenie zwraca wartość "kube-scheduler is degraded", na przykład:
| NAZWA DOSTĘPNA WERSJA POSTĘPUJE OD STATUS Wersja
False False 5h4m Błąd podczas uzgadniania 4.13.12: Operator klastra kube-scheduler uległ degradacji |
lub zwraca "kube-controller-manager is degraded", na przykład:
| NAZWA DOSTĘPNA WERSJA POSTĘP OD STANU Wersja
False False 5h4m Błąd podczas uzgadniania 4.13.12: Operator klastra kube-controller-manager uległ degradacji |
2. Uruchom polecenie:
kubectl --kubeconfig="/usr/share/mcp_ocp/pv/mcp-installer-ocp/auth/kubeconfig" get co
Na przykład kube-controller-manager ulega degradacji, a polecenie pokazuje, że jeden kube-controller-manager uległ degradacji z komunikatem "GuardControllerDegraded: Brak operandu w węźle"
|
NAZWA DOSTĘPNA WERSJA POSTĘPUJĄCA OBNIŻONA OD KOMUNIKATU ...... kube-controller-manager 4.13.12 True True True 4d7h GuardControllerDegraded: [Brak operandu w węźle h01-01-compute-02.p82.local, Brak operandu w węźle h01-01-compute-03.p82.local]... ...... machine-config 4.13.12 True False True 4d7h Nie udało się ponownie zsynchronizować 4.13.12, ponieważ: błąd podczas syncRequiredMachineConfigPools: [upłynął limit czasu oczekiwania na warunek. Wzorzec puli błędów nie jest gotowy, ponawianie próby. Status: (pula o obniżonej wydajności: true total: 3, Ready 1, zaktualizowano: 1, niedostępne: 2)] |
3. Uruchom polecenie:
kubectl --kubeconfig="/usr/share/mcp_ocp/pv/mcp-installer-ocp/auth/kubeconfig" get pods -A | grep kube-controller-manager
Na przykład kube-controller-manager jest zdegradowany, polecenie pokazuje, że jeden kube-controller-manager ma wartość 0/1
|
NAZWA STATUS GOTOWOŚCI WIEK PONOWNEGO URUCHOMIENIA installer-4-h01-01-compute-03.p82.local 0/1 Zakończone 0 4d7h installer-4-h01-01-compute-04.p82.local 0/1 Zakończone 0 4d7h installer-5-h01-01-compute-03.p82.local 0/1 Zakończone 0 4d7h installer-5-h01-01-compute-04.p82.local 0/1 Ukończono 0 4d7h installer-6-h01-01-compute-03.p82.local 0/1 Zakończone 0 4d7h kube-controller-manager-guard-h01-01-compute-03.p82.local 0/1 Bieganie 0 4k7h kube-controller-manager-guard-h01-01-compute-04.p82.local 1/1 Uruchamianie 0 4k7h kube-controller-manager-h01-01-compute-04.p82.local 4/4 Uruchamianie 0 4k7h |
Przyczyna
Główną przyczyną jest to, że platforma Kubernetes nie może usunąć części zasobników i powoduje, że niektóre usługi działają w złej kondycji.
Rozwiązanie
Ten problem zostanie naprawiony w przyszłej wersji OCP.
W przypadku wersji OCP, której dotyczy problem, wykonaj następujące czynności, aby obejść problem:
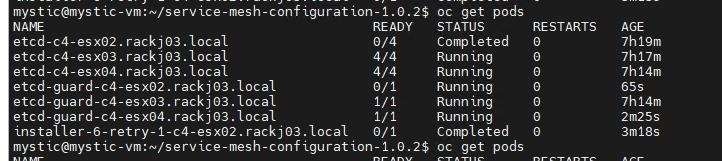
logowanie SSH do zidentyfikowanego węzła, w powyższym przykładzie nazwa zidentyfikowanego węzła to "c4-esx02.rackj03.local".
1. Zapisz klucz prywatny odpowiadający kluczowi publicznemu SSH wygenerowanemu na stronie internetowej kreatora wdrażania klastra.
Uruchom polecenie: ssh-keygen -t ecdsa -b 521
- Wprowadź nazwę pliku, w której chcesz zapisać klucz, lub użyj wartości domyślnej.
- Wprowadź hasło lub użyj wartości domyślnej.
Twój klucz publiczny został zapisany w katalogu /root/.ssh/id_ecdsa.pub
3. Uruchom polecenie: sudo systemctl restart kubelet
4. Ponów próbę wdrożenia klastra ze strony internetowej kreatora