Turno aberto: Erro de pós-verificação do upgrade do OCP para nó não pronto ou agendamento desativado
Resumo: Erro pós-verificação do upgrade do OCP para nó não pronto ou agendamento desativado devido a VM configurada com volume de armazenamento ReadWriteOnce(RWO) que não pode ser migrado em tempo real. ...
Este artigo aplica-se a
Este artigo não se aplica a
Este artigo não está vinculado a nenhum produto específico.
Nem todas as versões do produto estão identificadas neste artigo.
Sintomas
Durante o processo de pós-verificação do upgrade do OCP, pode ser exibida uma mensagem de erro dizendo "Falha ao executar a verificação de após o cluster do OCP. O nó não está pronto ou a programação está desativada."
Causa
Uma ou mais VMs configuradas com o volume de armazenamento ReadWriteOnce(RWO) que não pode ser migrado em tempo real no nó de geração de relatórios de erros.
Verifique abaixo o documento do Openshift para obter mais informações sobre volumes de armazenamento para discos de máquina virtual.
Resolução
1. Altere as configurações do PV da VM.
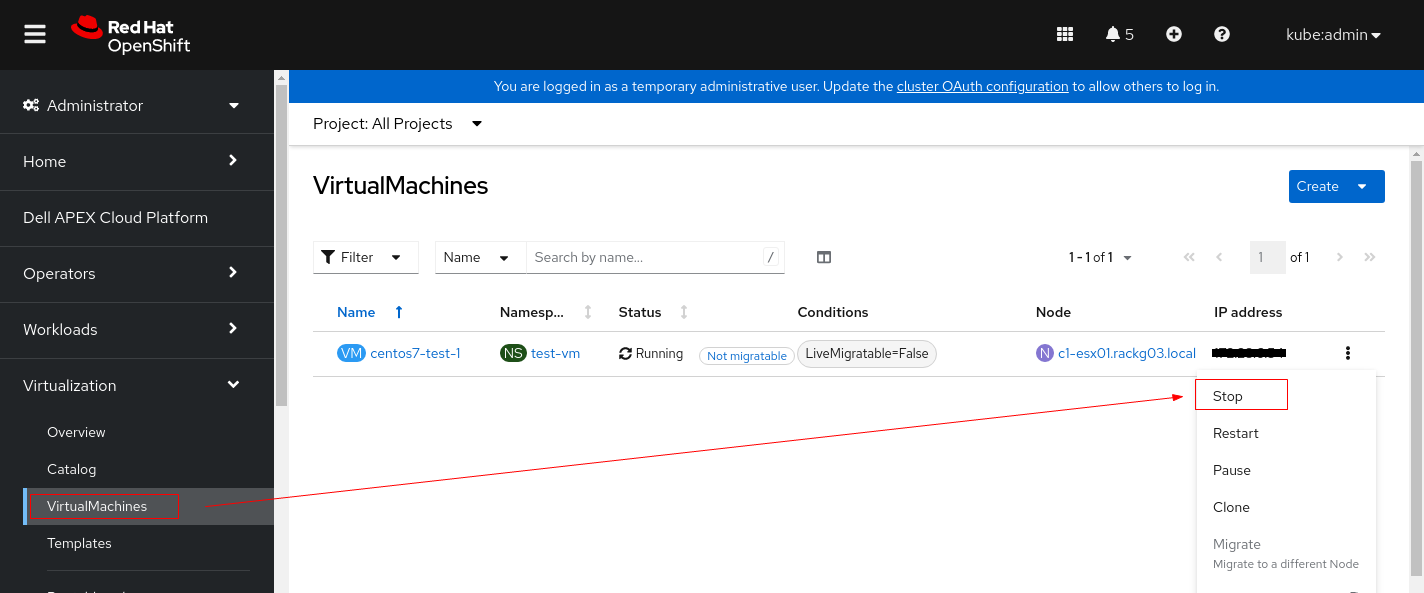
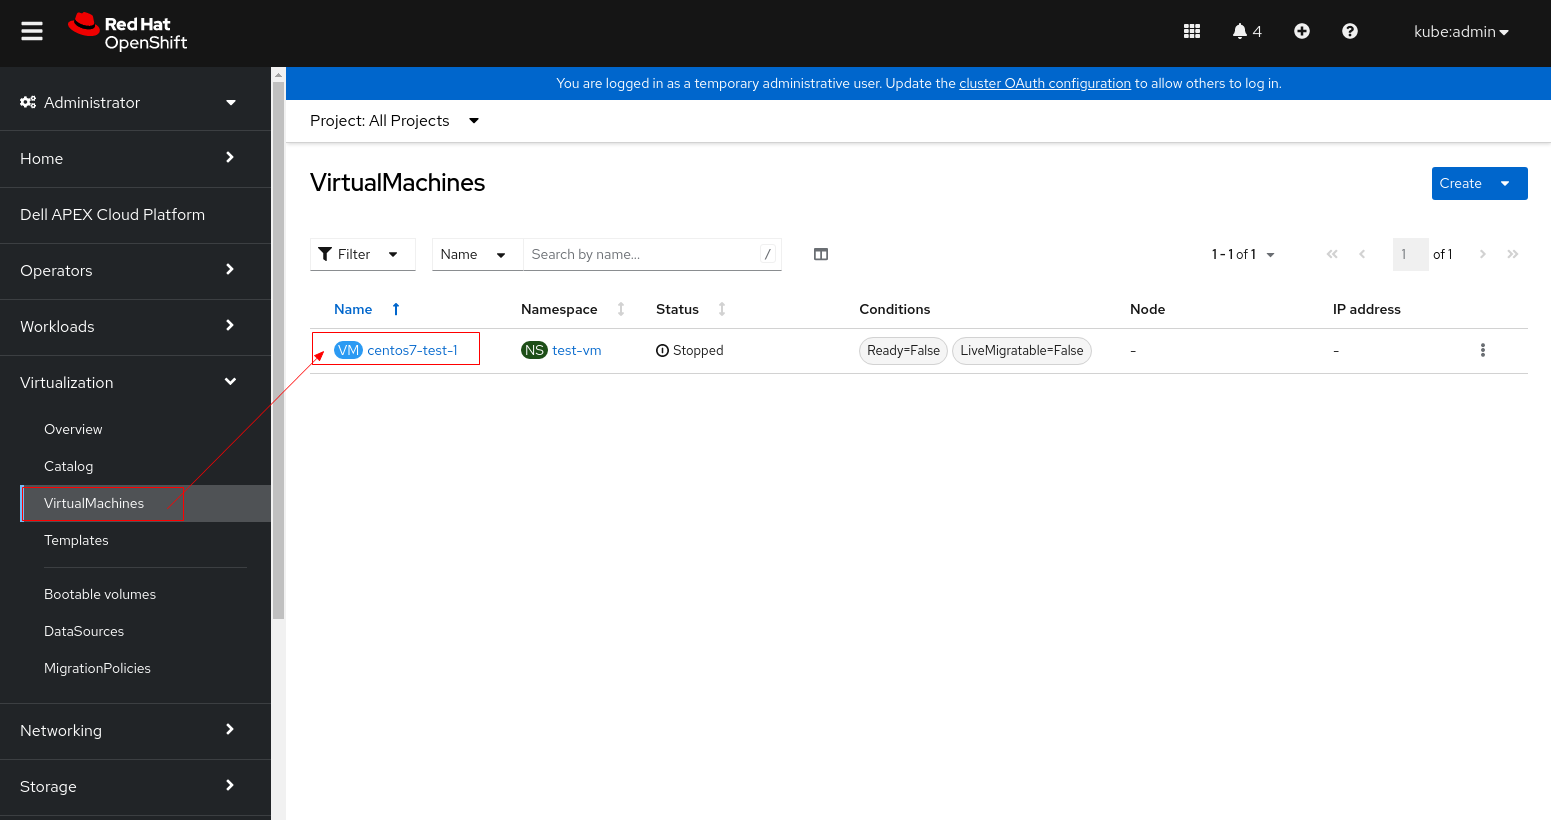
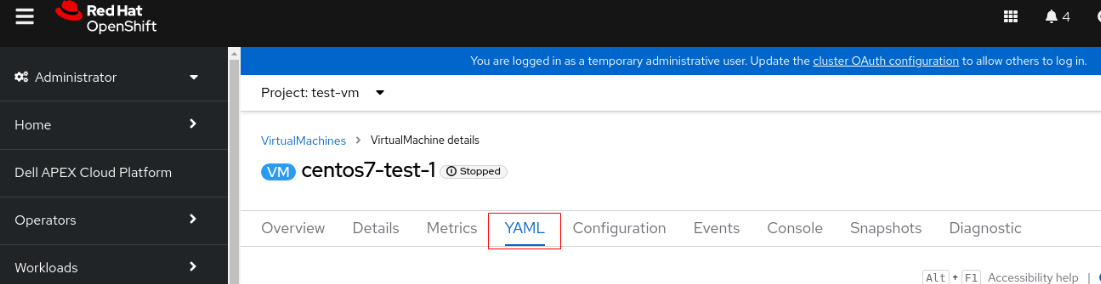
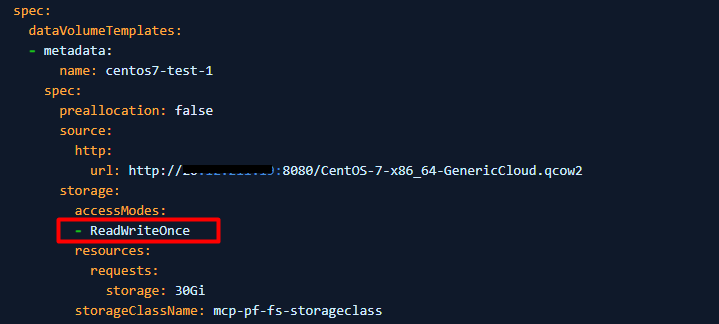
2. Localize os nós cujo status é "Ready,SchedulingDisabled".
3. Drene o nó para remover pods em execução dele.
4. Defina o modo de depuração e reinicialize o nó.
5. Quando o nó estiver pronto após a reinicialização, marque-o como ativo.
6. Verifique se o nó foi marcado com sucesso como ativo.
- 1.1 interrompa a instância da VM antes de alterar suas configurações de PV.
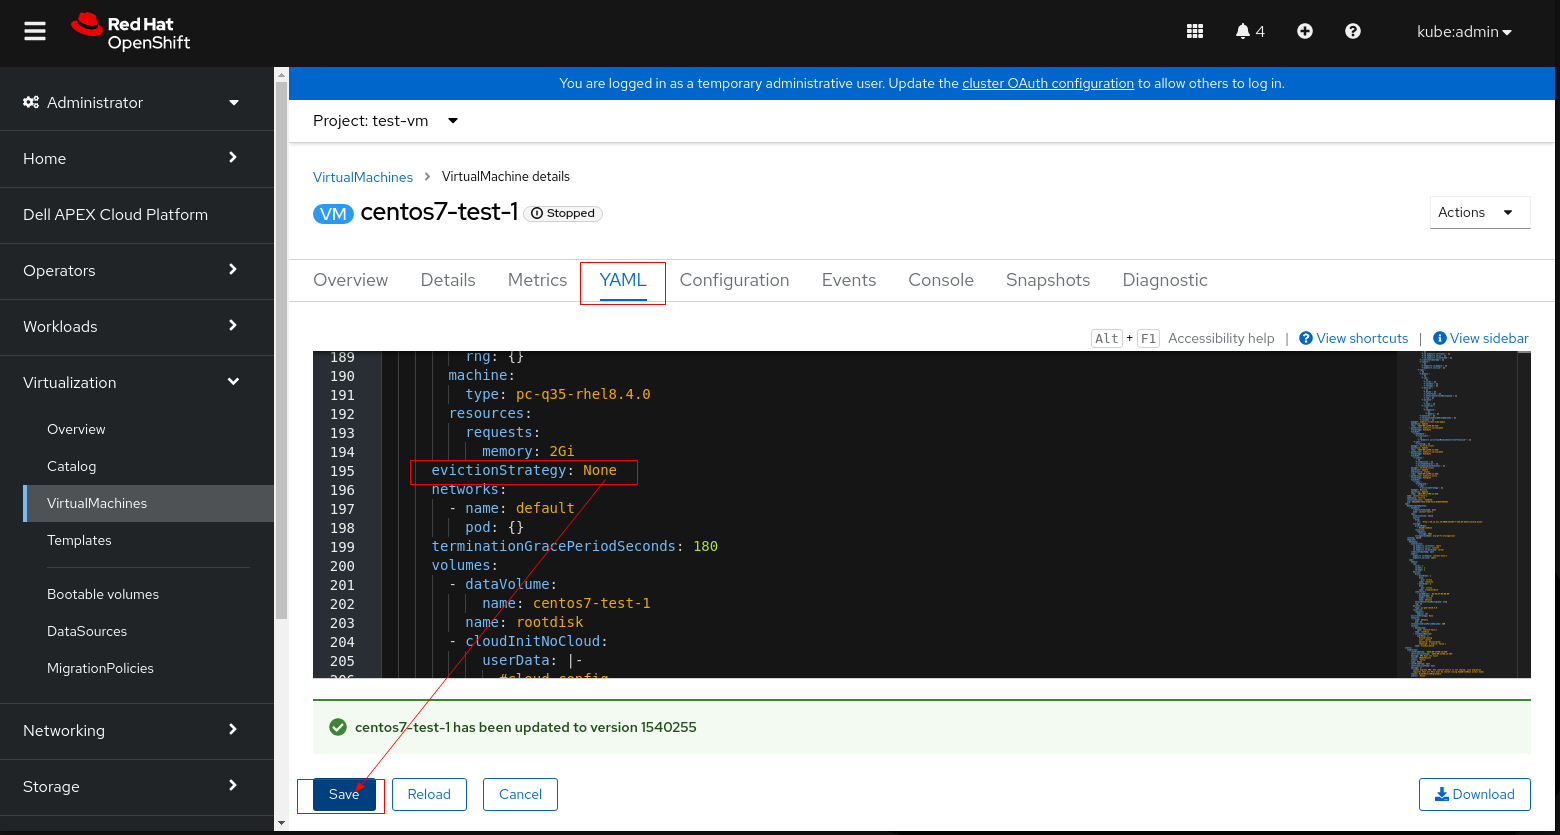
- 1.2 Clique na VM e alterne para a guia YAML
- 1.3 Altere accessModes de "ReadWriteOnce" para "ReadWriteMany"
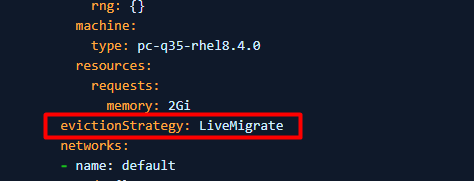
- 1.4 Se o PV não puder ser definido como ReadWriteMany (a VM não pode começar a usar ReadWriteMany), defina a evictionStrategy de LiveMigrate como None
Nota: Execute a etapa 1.3 ou 1.4 que se aplica ao seu ambiente, não precisa executar as duas etapas.
- 1.5 Clique em Save e reinicie a VM.
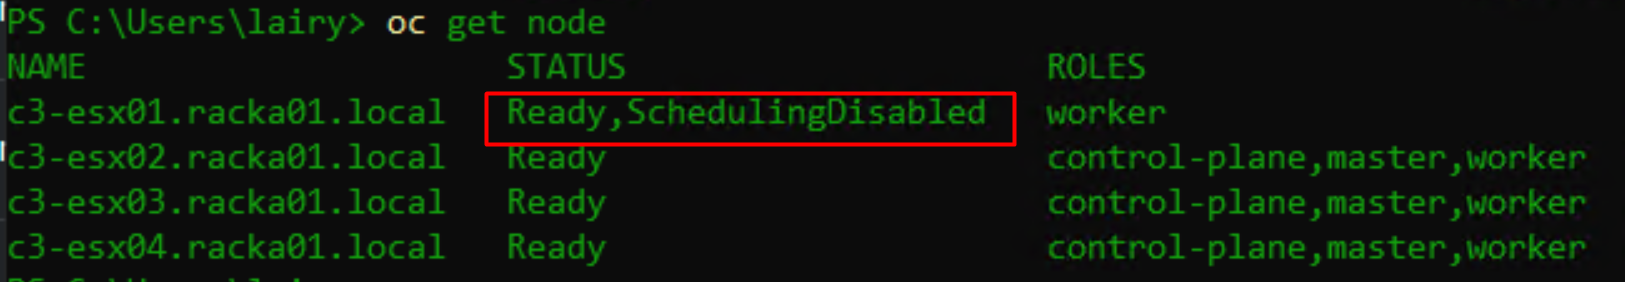
2. Localize os nós cujo status é "Ready,SchedulingDisabled".
$ oc get nodePor exemplo:
3. Drene o nó para remover pods em execução dele.
$ oc adm <node name> --ignore-daemonsets --delete-emptydir-data --forcePor exemplo: oc adm drain c3-esx01.racka01.local --ignore-daemonsets --delete-emptydir-data --force
4. Defina o modo de depuração e reinicialize o nó.
$ oc debug node/<node name>

$ sh-4.4# chroot /host

$ sh-4.4# systemctl reboot
5. Quando o nó estiver pronto após a reinicialização, marque-o como ativo.
$ oc adm uncordon <node name>
6. Verifique se o nó foi marcado com sucesso como ativo.
$ oc get node
Produtos afetados
APEX Cloud Platform for Red Hat OpenShiftPropriedades do artigo
Número do artigo: 000216593
Tipo de artigo: Solution
Último modificado: 18 set. 2026
Versão: 4
Encontre as respostas de outros usuários da Dell para suas perguntas.
Serviços de suporte
Verifique se o dispositivo está coberto pelos serviços de suporte.