Код події Openshift: 1030NODE0001
Resumo: При тривалому високому завантаженні процесора на одному вузлі керуючої площини більший тиск CPU, ймовірно, спричинить аварійне перемикання; збільшити доступний процесор.
Este artigo aplica-se a
Este artigo não se aplica a
Este artigo não está vinculado a nenhum produto específico.
Nem todas as versões do produto estão identificadas neste artigo.
Sintomas
Екстремальний тиск на процесор може спричинити повільну серіалізацію та низьку продуктивність kube-apiserver та etcd. Коли це трапляється, існує ризик, що клієнти бачать невідповідні API-запити, які знову надсилаються,
що створює ще більший тиск на процесор.Це також може спричиняти відмови у живих зондах через повільну чутливість etcd на бекенді. Якщо один kube-apiserver виходить з ладу за цієї умови, ймовірно, ви зіткнетеся з каскадом, оскільки решта kube-apiservers також недостатньо налаштовані.
що створює ще більший тиск на процесор.Це також може спричиняти відмови у живих зондах через повільну чутливість etcd на бекенді. Якщо один kube-apiserver виходить з ладу за цієї умови, ймовірно, ви зіткнетеся з каскадом, оскільки решта kube-apiservers також недостатньо налаштовані.
Causa
Це сповіщення спрацьовує, коли на одному вузлі керуючої площини спостерігається стійке високе навантаження процесора.
Терміновість цього сповіщення визначається тим, як довго вузол підтримує високе навантаження процесора:
.Терміновість цього сповіщення визначається тим, наскільки довго завантаження процесора на всіх трьох вузлах керуючої площини перевищує витривалість двох вузлів керуючої площини.
Терміновість цього сповіщення визначається тим, як довго вузол підтримує високе навантаження процесора:
- Критично
- коли використання процесора на окремому вузлі керуючої площини перевищує 90% понад 1 годину.
- Увага
- коли використання процесора на окремому вузлі керуючої площини перевищує 90% для понад 5 м.
.Терміновість цього сповіщення визначається тим, наскільки довго завантаження процесора на всіх трьох вузлах керуючої площини перевищує витривалість двох вузлів керуючої площини.
- Увага
- коли завантаження процесора на всіх трьох вузлах керуючої площини перевищує, ніж два вузли керуючої площини можуть підтримувати понад 10 м.
Resolução
Діагноз:
Виконайте наступні запити PromQL на веб-консолі OCP для допомоги в діагностиці (Спостерігати → метрики → Запускати запити).Топ-5 контейнерів із найбільшим завантаженням процесора на певному вузлі:
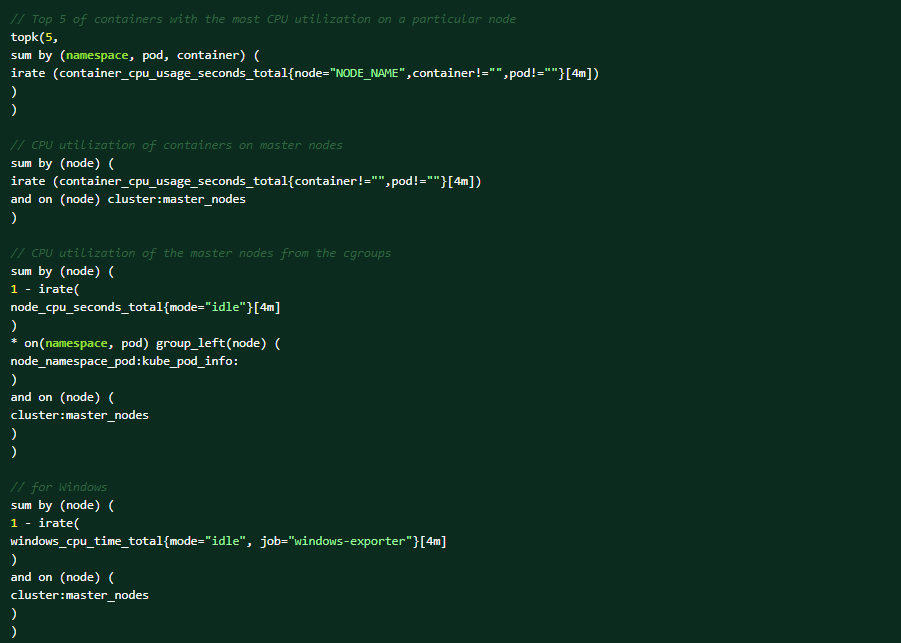
Ось умови, які можуть спричинити попередження:
- з'явилося нове навантаження, яке генерує більше викликів до APISERVER і призводить до високого навантаження процесора. У такому випадку збільште потужність процесора та пам'яті на вузлах керуючої площини.
- сповіщення спрацьовується на основі метрик вузла, тож можливо, що компонент на вузлі спричиняє високе навантаження процесора.
- APISERVER/ETCD обробляє більше запитів через повторні спроби клієнта, спричинені прихованою проблемою.
- нерівномірний розподіл запитів до екземплярів APISERVER через HTTP2 (він мультиплексує запити через одне TCP-з'єднання). Балансувальники навантаження не знаходяться на рівні додатків і тому не розуміють http2.
Пом'якшення наслідків:
- Якщо навантаження створює навантаження на APISERVER, що спричиняє високе навантаження процесора, збільште CPU та пам'ять на вузлах керуючої площини.
- Якщо тривале високе навантаження процесора зумовлене деградацією кластера:
- Визначте корінну причину деградації і визначте подальші кроки відповідно.
Підтримка:
Якщо всі вищезазначені кроки не допоможуть вирішити проблему, зверніться до технічної підтримки Dell EMC для подальшого розслідування.
Mais informações
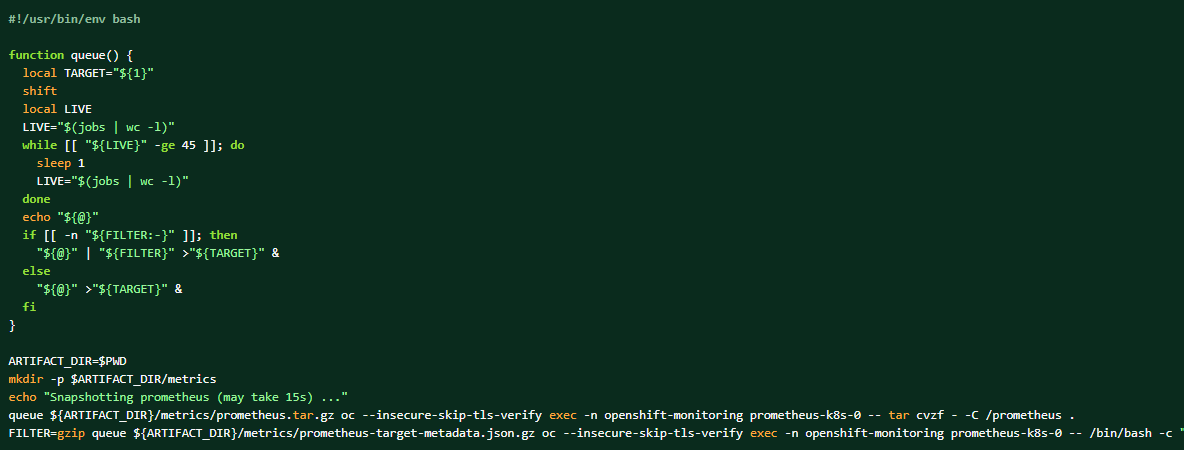
Якщо зібрати логарифмічний пучок, дані Прометея також можуть бути скинуті як комплементарні матеріали.
Як взяти дамп даних кластера Prometheus:
Produtos afetados
APEX Cloud Platform for Red Hat OpenShiftPropriedades do artigo
Número do artigo: 000217405
Tipo de artigo: Solution
Último modificado: 18 set. 2026
Versão: 4
Encontre as respostas de outros usuários da Dell para suas perguntas.
Serviços de suporte
Verifique se o dispositivo está coberto pelos serviços de suporte.