OpenShift: Falha no processo de implementação do cluster devido ao status de pod estático não íntegro.
Resumo: Um problema da plataforma de contêiner OpenShift causando falha na implementação do cluster, status do pod estático alterado para concluído.
Este artigo aplica-se a
Este artigo não se aplica a
Este artigo não está vinculado a nenhum produto específico.
Nem todas as versões do produto estão identificadas neste artigo.
Sintomas
Vários erros podem ser observados durante o processo de implementação do cluster, incluindo, entre outros, os seguintes cenários:
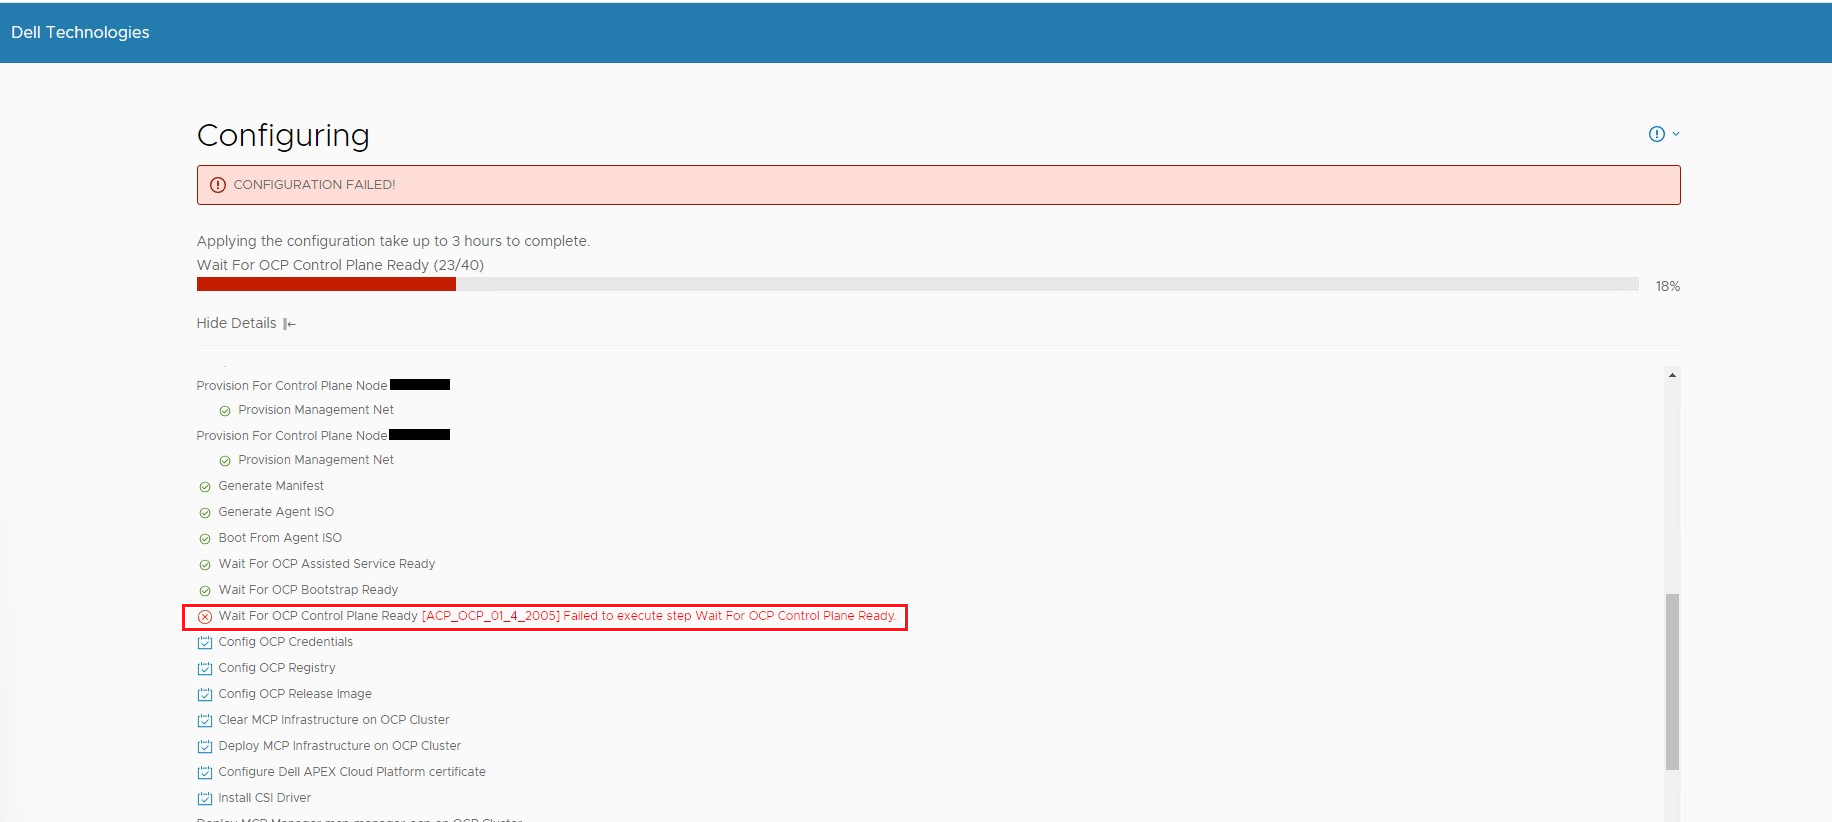
Cenário 1: O processo de configuração de implementação do cluster apresentou falha com o erro "Failed to execute step Wait For OCP Control Plane Ready"
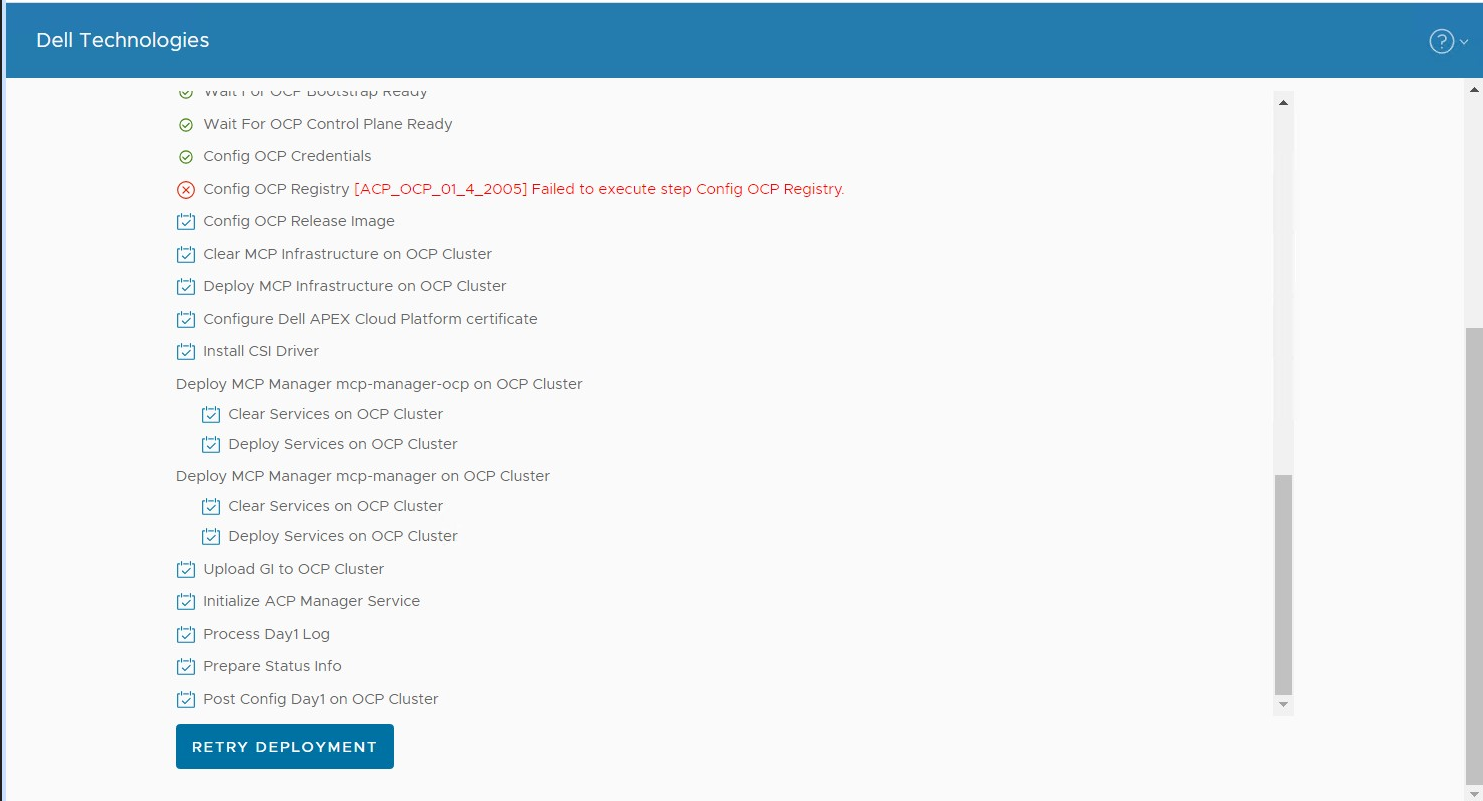
cenário 2: O processo de configuração de implementação do cluster apresentou falha com o erro "Failed to execute step Config OCP Registry"
O comando retorna "kube-scheduler is degraded", por exemplo:
ou retorna "kube-controller-manager is degraded", por exemplo:
2. Comando de execução:
Considera que o kube-controller-manager está degradado, por exemplo, o comando mostra que um kube-controller-manager está degradado com a mensagem "GuardControllerDegraded: Operando ausente no nó"
Cenário 1: O processo de configuração de implementação do cluster apresentou falha com o erro "Failed to execute step Wait For OCP Control Plane Ready"
cenário 2: O processo de configuração de implementação do cluster apresentou falha com o erro "Failed to execute step Config OCP Registry"
Faça log-in no nó principal via SSH (a credencial padrão é root/Passw0rd!), execute os comandos abaixo para verificar o status de clusterversion, clusteroperator e pods estáticos.
1. Comando de execução:kubectl --kubeconfig="/usr/share/mcp_ocp/pv/mcp-installer-ocp/auth/kubeconfig" get clusterversion
O comando retorna "kube-scheduler is degraded", por exemplo:
| VERSÃO DO NOME DISPONÍVEL EM ANDAMENTO DESDE A VERSÃO DO STATUS
Falso Falso 5h4m Erro durante a reconciliação 4.13.12: o operador do cluster kube-scheduler está degradado |
ou retorna "kube-controller-manager is degraded", por exemplo:
| VERSÃO DO NOME DISPONÍVEL EM ANDAMENTO DESDE A VERSÃO DO STATUS
Falso Falso 5h4m Erro ao reconciliar a versão 4.13.12: o operador do cluster kube-controller-manager está degradado |
2. Comando de execução:
kubectl --kubeconfig="/usr/share/mcp_ocp/pv/mcp-installer-ocp/auth/kubeconfig" get co
Considera que o kube-controller-manager está degradado, por exemplo, o comando mostra que um kube-controller-manager está degradado com a mensagem "GuardControllerDegraded: Operando ausente no nó"
|
VERSÃO DO NOME DISPONÍVEL PROGREDINDO DEGRADADA DESDE A MENSAGEM ...... kube-controller-manager 4.13.12 True True True 4d7h GuardControllerDegraded: [operando ausente no nó h01-01-compute-02.p82.local, operando ausente no nó h01-01-compute-03.p82.local]... ...... machine-config 4.13.12 True False True 4d7h Falha ao sincronizar novamente o 4.13.12 porque: erro durante syncRequiredMachineConfigPools: [Tempo de espera excedido aguardando a condição, erro O mestre de pool não está pronto, tentando novamente. Status: (Pool degradado: true total: 3, pronto 1, atualizado: 1, indisponível: 2)] |
3. Comando de execução:
kubectl --kubeconfig="/usr/share/mcp_ocp/pv/mcp-installer-ocp/auth/kubeconfig" get pods -A | grep kube-controller-manager
Considera que o kube-controller-manager está degradado, por exemplo, o comando mostra que um kube-controller-manager é 0/1
|
IDADE DE REINICIALIZAÇÃO DO STATUS NAME READY installer-4-h01-01-compute-03.p82.local 0/1 concluído 0 4d7h installer-4-h01-01-compute-04.p82.local 0/1 concluído 0 4d7h installer-5-h01-01-compute-03.p82.local 0/1 concluído 0 4d7h installer-5-h01-01-compute-04.p82.local 0/1 concluído 0 4d7h installer-6-h01-01-compute-03.p82.local 0/1 concluído 0 4d7h kube-controlador-gerente-guarda-h01-01-compute-03.p82.local 0/1 Executando 0 4d7h kube-controller-manager-guard-h01-01-compute-04.p82.local 1/1 Executando 0 4d7h kube-controller-manager-h01-01-compute-04.p82.local 4/4 Executando 0 4d7h |
Causa
Esse é um problema conhecido do OCP 4.10, 4.11, 4.12 e 4.13.
A causa raiz é que o Kubernetes falha ao excluir alguns pods e faz com que alguns serviços fiquem em estado não íntegro.
A causa raiz é que o Kubernetes falha ao excluir alguns pods e faz com que alguns serviços fiquem em estado não íntegro.
Resolução
Esse problema será corrigido na versão futura do OCP.
Para a versão do OCP afetada, siga as etapas abaixo para contornar o problema:
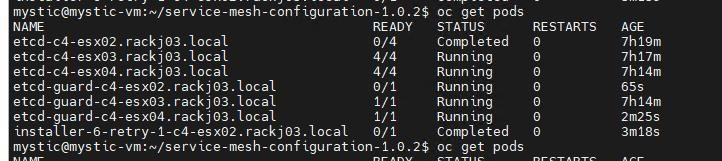
log-in SSH no nó identificado. No exemplo acima, o nome do nó identificado é "c4-esx02.rackj03.local".
1. Salve a chave privada correspondente à chave pública ssh gerada na página da Web do Assistente de implementação de cluster.
Por exemplo:
Execute o comando: ssh-keygen -t ecdsa -b 521
Execute o comando: ssh-keygen -t ecdsa -b 521
- Digite um nome de arquivo no qual você deseja salvar a chave ou usando o valor padrão.
- Digite a frase secreta ou use o valor padrão.
A saída do comando é como:
Sua identificação foi salva em /root/.ssh/id_ecdsa
Sua chave pública foi salva em /root/.ssh/id_ecdsa.pub
Sua chave pública foi salva em /root/.ssh/id_ecdsa.pub
Neste exemplo, "/root/.ssh/id_ecdsa" é o arquivo de chave privada que será usado no próximo comando.
2. Execute o comando: ssh -l core <node name> -i <private_key_file>
3. Execute o comando: sudo systemctl restart kubelet
4. Repita o processo de implementação do cluster na página da Web do assistente
Produtos afetados
APEX Cloud Platform for Red Hat OpenShiftPropriedades do artigo
Número do artigo: 000218328
Tipo de artigo: Solution
Último modificado: 18 set. 2026
Versão: 5
Encontre as respostas de outros usuários da Dell para suas perguntas.
Serviços de suporte
Verifique se o dispositivo está coberto pelos serviços de suporte.